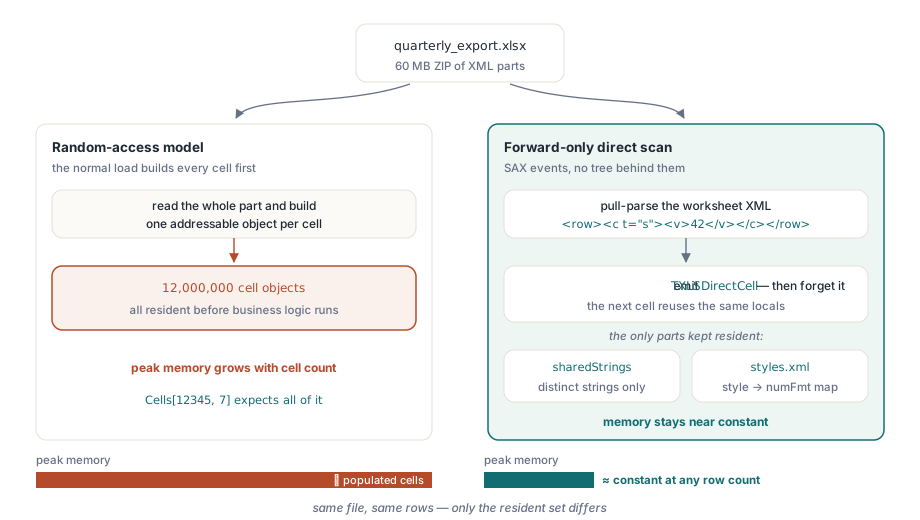
Таблица на миллион строк и десяток колонок — совершенно обычная выгрузка из отчётного задания над базой данных. Откройте её привычным способом, загрузив всю книгу в TXLSWorkbook, и процессу придётся материализовать каждую из этих двенадцати миллионов ячеек как живой объект ещё до первой строки вашей бизнес-логики. Файл на диске может весить шестьдесят мегабайт сжатого XML. Дерево объектов, в которое он разворачивается, в несколько раз больше, и всё оно должно быть в памяти одновременно, потому что модель по замыслу даёт произвольный доступ. Для отчёта, который вы собираетесь прочитать сверху вниз и выбросить, это огромный расход памяти на структуру, которая вам никогда не была нужна
Через тот же файл ведёт и второй путь. Вместо построения модели вы сканируете XML листа только вперёд, по одной ячейке за раз, и позволяете каждой ячейке уплыть мимо после того, как вы на неё посмотрели. Ничего не накапливается. Память остаётся почти постоянной, будь на листе тысяча строк или десять миллионов, потому что читатель никогда не держит больше, чем разбираемый в данный момент фрагмент плюс пара небольших справочных таблиц. Именно это и делает прямой читатель HotXLS, а остальная часть статьи — о том, почему он остаётся компактным и что даёт взамен
Почему модель в памяти не масштабируется
Файл XLSX — это ZIP-пакет частей XML, описанный в ECMA-376. Каждый лист — отдельная часть, xl/worksheets/sheetN.xml, и внутри неё каждая строка представлена элементом <row>, содержащим элементы ячеек <c>. Обычный путь загрузки читает эту часть и строит адресуемый объект для каждой ячейки, чтобы вы потом могли спросить Cells[12345, 7] и получить ответ за постоянное время. Произвольный доступ — весь смысл модели книги, и именно он делает удобными редактирование, вычисление формул и оформление
Плата за это в том, что произвольный доступ требует одновременного присутствия всего. Нельзя индексироваться в структуру, построенную лишь частично. Поэтому пик памяти полной загрузки — функция от числа ячеек, и на листе с миллионами заполненных ячеек эта функция уводит туда, где ваш сервис быть не хочет, особенно если несколько таких заданий работают одновременно на общей машине. Когда нужный вам шаблон доступа на самом деле последовательный, платить за произвольный доступ — значит платить за возможность, которой вы не воспользуетесь
Сканирование SAX только вперёд, не строящее дерева
Прямой читатель открывает ZIP-пакет и обходит каждую часть листа тянущим парсером в стиле SAX. SAX здесь означает, что парсер сообщает о событиях разбора по мере их появления — открывающий элемент, текстовый фрагмент, закрывающий элемент — и идёт дальше. Дерева узлов за собой он не оставляет. Читатель отслеживает текущие строку и колонку по атрибутам r, собирает тип ячейки, индекс стиля, значение и текст формулы по мере поступления событий, а увидев закрывающий тег </c>, выдаёт одну ячейку и забывает о ней. Следующая ячейка переиспользует ту же горстку локальных переменных
Поскольку между ячейками ничего не удерживается, потребление памяти не растёт с их числом. Именно за это свойство и стоит держаться. Лист на двести строк и лист на двадцать миллионов строк стоят читателю одной и той же резидентной памяти, а различаются они только длительностью сканирования. Вы отказываетесь от произвольного доступа, главной особенности модели, и получаете взамен потолок памяти, который числу ячеек не пробить
Что остаётся в памяти и почему именно эти две части
Сканирование не полностью лишено состояния, и исключения тут поучительны. Две небольшие таблицы приходится держать в памяти на всё время, потому что ячейка сама по себе не несёт достаточно сведений, чтобы её истолковать без них
Первая — таблица общих строк. В SpreadsheetML текстовая ячейка не хранит свой текст. Она несёт t="s" и числовую нагрузку, которая является индексом в xl/sharedStrings.xml — едином списке всех различных строк книги без повторов. Это выгодный обмен по месту для файлов, где одни и те же подписи повторяются в тысячах строк, но он означает, что читатель обязан загрузить эту таблицу строк заранее и держать её в памяти, поскольку любая ячейка в любом листе может сослаться на любую её запись. Размер таблицы определяется числом различных строк, а не числом ячеек, поэтому она остаётся скромной даже на огромных листах
Вторая — отображение числовых форматов из части стилей. Числовая ячейка и ячейка с датой на проводе побайтово одинаковы: и там, и там простое число, потому что дата в SpreadsheetML — это всего лишь порядковый номер дня. Отличает их только стиль ячейки, который через cellXfs в xl/styles.xml указывает на идентификатор числового формата. Чтобы сообщить дату как дату, а не как сырой порядковый номер, читатель загружает эту таблицу соответствия стилей форматам и держит её в памяти. Всё остальное в файле — собственно данные ячеек, составляющие основную массу байтов, — проплывает мимо, не сохраняясь
Каждая ячейка сообщает свой вид и значение
Каждая выданная ячейка приходит как запись TXLSDirectCell. Она несёт индекс и имя листа, строку и колонку, считая с единицы, семантический Kind, значение Value в виде Variant, текст Formula без ведущего знака равенства и сырой StyleIndex. Вид — это один из xdkNumber, xdkString, xdkBoolean, xdkDate или xdkError, поэтому ветвиться можно по смыслу ячейки, а не выводить его заново из атрибутов. Ячейка с формулой сообщает вид своего кэшированного результата и рядом текст формулы, так что вычисленный итог приходит числом, которое заодно рассказывает, как оно получено

type
  TReportScan = class
    procedure OnCell(Sender: TObject; const Cell: TXLSDirectCell;
      var Abort: Boolean);
  end;

procedure TReportScan.OnCell(Sender: TObject; const Cell: TXLSDirectCell;
  var Abort: Boolean);
begin
  case Cell.Kind of
    xdkString:  AccumulateLabel(Cell.Row, Cell.Col, VarToStr(Cell.Value));
    xdkNumber:  AddToTotals(Cell.Col, Double(Cell.Value));
    xdkDate:    NoteWhen(Cell.Row, VarToDateTime(Cell.Value));
    xdkBoolean: FlagRow(Cell.Row, Boolean(Cell.Value));
    xdkError:   LogBadCell(Cell.Row, Cell.Col, VarToStr(Cell.Value));
  end;
end;
Как отличить дату от числа
Вопрос с датами заслуживает отдельного разбора, потому что именно здесь ошибается большинство наивных сканеров. У числовой ячейки нет типа даты. Ячейка со значением 46000 может быть количеством, ценой или 17 февраля 2025 года, и файл говорит вам, что именно, только через идентификатор числового формата, до которого добираются через стиль ячейки. ECMA-376 резервирует блок встроенных идентификаторов форматов, смысл которых одинаков у всех соответствующих спецификации продуктов, и несущие дату идентификаторы лежат в двух диапазонах: с 14 по 22 для стандартных форматов даты и времени и с 45 по 47 для форматов прошедшего времени вроде [h]:mm:ss. Когда DetectDates включён, а по умолчанию он включён, читатель разрешает стиль каждой числовой ячейки до идентификатора формата, и ячейка, чей идентификатор попал в эти зарезервированные диапазоны, сообщается как xdkDate с уже преобразованным в TDateTime значением Value. Пользовательские форматы тоже проверяются — по наличию в коде формата токенов даты и времени, — но надёжной опорой остаются именно зарезервированные диапазоны. Выключите DetectDates, и таблица стилей даже не загрузится, каждая числовая ячейка придёт как xdkNumber, а сканирование станет чуть легче
Пропускайте листы и прерывайте раньше
У последовательного сканирования есть тихое преимущество, недоступное произвольному доступу: вы можете остановиться. Событие OnSheet срабатывает до открытия каждого листа и даёт вам два переключателя. Установите SkipSheet, и эта часть вообще не будет разобрана — так в многолистовой книге сканируют только интересующие листы, не платя за чтение остальных. Установите Abort, и всё сканирование немедленно завершится. Событие OnCell несёт собственный Abort, поэтому вы можете остановиться в тот момент, когда нашли искомое — нужную строку, сигнальное значение, конец блока заголовков, — не читая оставшиеся миллионы ячеек. При сканировании только вперёд прерывание по-настоящему бесплатно, потому что пропущенная работа — это работа, которая ещё не была сделана

procedure TReportScan.OnSheet(Sender: TObject; SheetIndex: Integer;
  const SheetName: WideString; var SkipSheet: Boolean; var Abort: Boolean);
begin
  // Сканируем только лист "Data"; остальные оставляем непрочитанными
  SkipSheet := SheetName <> 'Data';
end;
Подсчёт ячеек без обработчика
Одно недавнее уточнение стоит отметить отдельно, потому что оно превращает частый вопрос в один дешёвый вызов. Читатель считает каждую пройденную заполненную ячейку и делает это независимо от того, подключён ли обработчик OnCell. Раньше без установленного обработчика число заполненных ячеек возвращалось нулём, поскольку подсчёт был побочным эффектом выдачи. Теперь подсчёт от выдачи не зависит. Это значит, что вы можете задать один вопрос — сколько заполненных ячеек на самом деле содержит эта книга — и получить ответ по цене сканирования вообще без колбэков. И ReadFile, и ReadStream возвращают этот итог как Int64, и то же число доступно потом через свойство CellCount. Возврат -1 сигнализирует, что файл не удалось открыть или он не является пакетом OOXML
var
  Reader: TXLSDirectReader;
  Populated: Int64;
begin
  Reader := TXLSDirectReader.Create;
  try
    // Без обработчика OnCell: чистая перепись заполненных ячеек, память по-прежнему почти постоянна
    Populated := Reader.ReadFile('quarterly_export.xlsx');
    if Populated < 0 then
      raise Exception.Create('Not a readable XLSX package')
    else
      Writeln(Format('%d populated cells (CellCount = %d)',
        [Populated, Reader.CellCount]));
  finally
    Reader.Free;
  end;
end;
Для полного сканирования вы подключаете обработчик и вызываете ReadFile ровно так же. Контраст с полной загрузкой и есть весь смысл: там, где загрузка quarterly_export.xlsx в книгу развернула бы каждую ячейку в резидентный объект и держала бы всю эту массу, прямой читатель держит только общие строки и таблицу стилей, пока двенадцать миллионов ячеек по одной проходят через ваш OnCell. Арифметика, отработавшая на каждой ячейке, ничего после себя не оставляет, поэтому пик памяти задаётся числом различных строк книги, а не числом её строк-записей
Прямой читатель — верный инструмент, когда задача в том, чтобы один раз прочитать большую книгу и извлечь из неё данные или свести их. Если же вам нужен произвольный доступ полной модели, но хочется, чтобы она прилично вела себя на больших файлах, этот путь разбирают наши заметки о производительности на больших книгах в Delphi. А когда направление обратное, то есть речь о производстве большого вывода, а не о его потреблении, разбор потоковой записи для серверных пакетных заданий применяет ту же дисциплину постоянной памяти к записи. Все три возможности входят в состав HotXLS Delphi Component для Delphi и C++Builder наряду с API чтения, записи, формул и форматирования, которым посвящены другие статьи этого блога