В Excel ="a-b">"ab" возвращает TRUE, и ="a~b"<"ab" тоже возвращает TRUE. Скормите те же пары Delphi-функции CompareText — и оба ответа перевернутся: в порядке кодовых точек дефис стоит ниже букв, а тильда выше. Excel сравнивает текст с учётом нечувствительного к регистру «word sort» из локали пользователя Windows, где дефисы и апострофы лишь разрешают ничьи, а вся остальная пунктуация сортируется раньше цифр и букв
Симптомы редко напоминают про коллацию. COUNTIF(A:A,">M"), посчитанный на сервере, находит на две строки больше, чем та же формула в Excel. Прайс-лист, отсортированный сервисом отчётов, кладёт X-100 не туда, куда положил бы Excel. VLOOKUP("ABC",...) возвращает #N/A, хотя в столбце явно есть abc. Все три случая сводятся к одному вопросу: когда оба операнда — текст, какой из них меньше? У Excel ответ точный, и это почти никогда не тот ответ, который Delphi-код выдаёт по умолчанию
По какому правилу Excel сравнивает две текстовые строки?
Excel сравнивает два текстовых значения word sort'ом текущей локали пользователя Windows, игнорируя регистр. Word sort — коллация по умолчанию у функций сравнения Windows NLS: буквы сопоставляются в алфавитном порядке, а не по кодовой точке, поэтому é ложится между e и f, а верхний и нижний регистр схлопываются. Два символа обрабатываются особо. Дефис - и апостроф ' на первом проходе пропускаются, отчего co-op оказывается вплотную к coop; и только когда остальные символы сравнялись, их наличие и позиция решают порядок. Вся прочая пунктуация считается с полным весом и сортируется раньше цифр, а цифры — раньше букв
Таблица сводит вердикты Excel для IF(A<B,...) с двумя сравнениями, которые Delphi-разработчик скорее всего напишет первыми
| A против B | Excel / HotXLS | CompareStr (ординарное) | CompareText |
|---|---|---|---|
"a-b" vs "ab" | больше | меньше | меньше |
"a'b" vs "ab" | больше | меньше | меньше |
"a~b" vs "ab" | меньше | больше | больше |
"a_b" vs "ab" | меньше | меньше | больше |
"ab" vs "AB" | равно | больше | равно |
"é" vs "f" | меньше | больше | больше |
"Z" vs "f" | больше | меньше | больше |
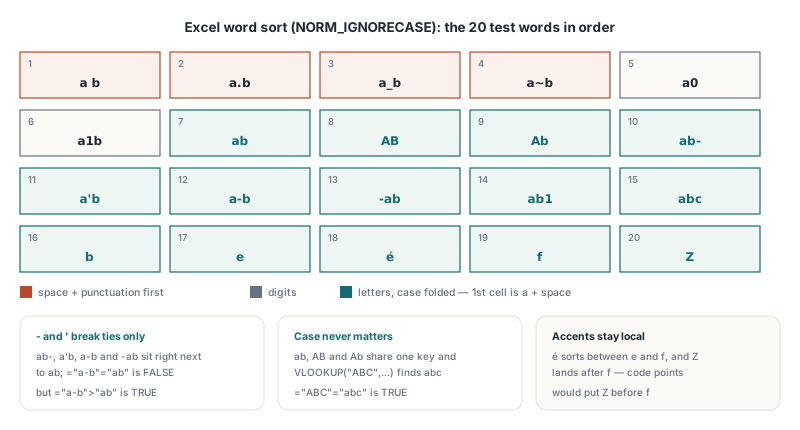
Два следствия ловят людей. Поскольку дефис лишь разрешает ничью, ="a-b"="ab" — FALSE: две строки соседи по сортировке и всё же не равны. А поскольку регистр схлопывается полностью, ab, AB и Ab — один ключ для любого оператора сравнения. В английской локали пользователя столбец из 20 неудобных слов сортируется в a b, a.b, a_b, a~b, a0, a1b, ab / AB / Ab, ab-, a'b, a-b, -ab, ab1, abc, b, e, é, f, Z. Внутри группы ab позиция пропущенного символа решает: завершающий дефис первым, начальный последним
Как самому проверить коллацию против Excel
Документация Excel ни разу не называет коллацию, которой пользуется, так что надёжный способ убедиться на своей машине — дать Excel рассудить пачку строковых пар и сверить его вердикты с CompareStringW под разными наборами флагов. Положите пары в два столбца, заставьте Excel вычислить =IF(A1<B1,-1,IF(A1=B1,0,1)) для каждой строки и прогоните те же пары через API. Стоящие пары смешивают ASCII-пунктуацию, цифры, оба регистра, пробелы, буквы с диакритикой вроде é, ß и ä, CJK-символы, полноширинные формы и неразрывный пробел, причём с изрядным числом почти-совпадений, различающихся одним символом. Случайные слова из словаря — плохая выборка: обычные буквы сортируются одинаково при всех правилах из этой статьи
Наборы флагов дают заметно разные результаты:
- Один
NORM_IGNORECASEсLOCALE_USER_DEFAULT— обычный word sort, именно ему следует Excel - Добавление
SORT_STRINGSORTпереключает на string sort, где дефис и апостроф становятся обычными символами с полным весом, и каждая пара вродеa-b/abвыходит наоборот - Добавление
NORM_IGNOREWIDTHделает полноширинную букву равной её полуширинной форме, а Excel держит эти две отдельно
Одна ловушка сидит в самом тестовом каркасе. Excel трактует апостроф в начале ячейки как префикс «хранить как текст», поэтому ячейка, чей весь ввод — ', оказывается пустой, и любая пара, собранная так, сообщает о несовпадении, к коллации отношения не имеющем. Собирайте такие пары строковыми литералами в формуле (="'") или пропускайте
Почему CompareText и ординарное сравнение ошибаются?
CompareText и ординарное сравнение промахиваются мимо порядка Excel, потому что сравнивают кодовые единицы UTF-16, а порядок кодовых точек разбрасывает пунктуацию вокруг алфавита. Дефис — U+002D, апостроф — U+0027, оба ниже любой буквы, поэтому ординарное сравнение объявляет "a-b" меньшим, чем "ab", там, где Excel трактует дефис как разрешителя ничьей. Тильда — U+007E, выше любой буквы, отчего "a~b" выходит большим — противоположно Excel. У CompareText есть и собственное второе искажение: он поднимает в верхний регистр только a..z и затем сравнивает кодовые единицы, а поскольку подчёркивание (U+005F) лежит между диапазонами заглавных и строчных, свёртка передвигает "a_b" из положения ниже "ab" в положение выше него. Ни одна из функций не подозревает, что é положено стоять между e и f
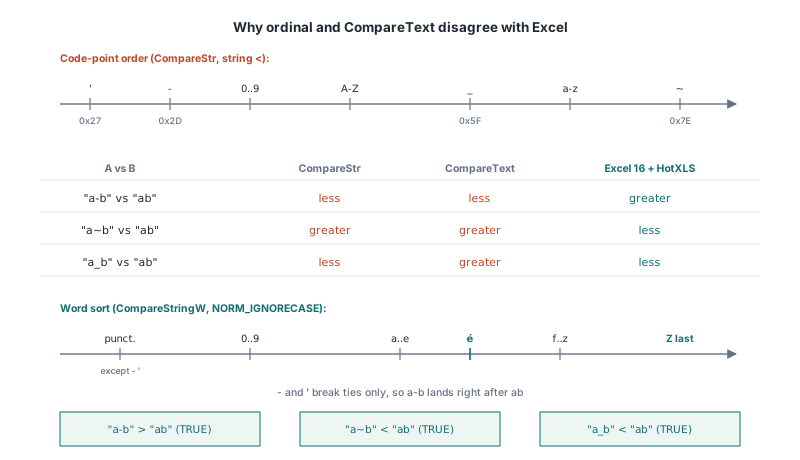
Обычные инструменты Delphi падают по обе стороны черты:
CompareStr, строковый оператор<иTComparer<string>.Defaultординарны и чувствительны к регистру, так чтоTArray.Sort<string>без компаратора ставитZраньшеfCompareTextиSameTextординарны после свёртки регистра, ограниченной ASCIIAnsiCompareTextиWideCompareTextв Delphi RTL на Windows зовутCompareString(LOCALE_USER_DEFAULT, NORM_IGNORECASE, ...)— тот вызов, что совпадает с Excel. ОтсортированныйTStringListс его дефолтами (UseLocaleTrue,CaseSensitiveFalse) идёт черезAnsiCompareTextи потому тоже согласен с Excel- На POSIX-целях Delphi RTL направляет
AnsiCompareTextчерез коллатор ICU — другой алгоритм с другими правилами пунктуации.AnsiCompareTextу Free Pascal на Windows конвертирует строку в ANSI-кодовую страницу и зовётCompareStringA, теряя всякий символ, который она не может представить
Так что locale-зависимые функции RTL на Windows оказываются правы просто потому, что так они реализованы сегодня. Код, который обязан соглашаться с Excel, должен звать API явно и говорить об этом. Более сложная проблема всплывает в любом движке формул, где каждый путь кода хватает ближайшее сравнение: верхний регистр и кодовые точки в операторах = и <, чувствительное к регистру Variant-сравнение в ветке > / < критериев COUNTIF, ещё одно внутри VLOOKUP (ровно поэтому VLOOKUP("ABC",A1:A20,1,FALSE) не находит abc) и locale-вызов в сортировке диапазона. Каждый путь по отдельности оправдан. Вместе они дают три разных порядка над одним столбцом
Одно сравнение за формулами, поисками и сортировкой в HotXLS
HotXLS проводит каждое сравнение текста с текстом в вычислительном и сортировочном коде через одну функцию, XlsCompareText в lxStandard.pas, которая зовёт CompareStringW(LOCALE_USER_DEFAULT, NORM_IGNORECASE, ...) и вычитает CSTR_EQUAL. Ею пользуются шесть операторов сравнения, поэлементные сравнения в формулах массивов, ветки >, <, >= и <= критериев в духе COUNTIF и функций баз данных, VLOOKUP и HLOOKUP в точном и приближённом режиме, упорядочивание за функциями динамических массивов и XLOOKUP / XMATCH, а также SortRange у обоих движков, TXLSWorksheet и TXLSXWorksheet. Посадить сортировку диапазона на ту же функцию было ключевым решением проектирования. Приближённый VLOOKUP по тексту даёт осмысленные ответы, только когда столбец отсортирован в том порядке, в каком поиск сравнивает, а одна общая функция делает расползание этих двух порядков невозможным
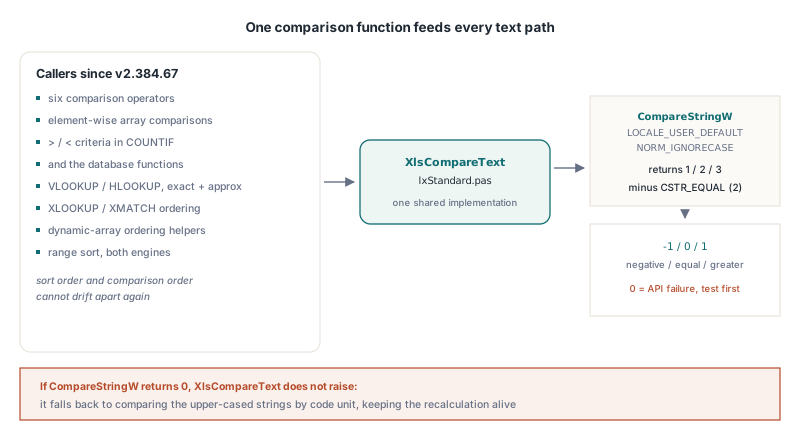
Быстрее всего увидеть правило из Delphi можно через TXLSXWorkbook.Calculate, который вычисляет строку формулы на активном листе и возвращает результат как Variant
uses
  System.Variants, lxHandleX;

var
  Book: TXLSXWorkbook;
begin
  Book := TXLSXWorkbook.Create;
  try
    Book.Sheets.Add('Data');  // Calculate вычисляет на активном листе
    Writeln(VarToStr(Book.Calculate('="a-b">"ab"')));   // True: дефис лишь разрешает ничью
    Writeln(VarToStr(Book.Calculate('="a-b"="ab"')));   // False: ничья разрешена, не равны
    Writeln(VarToStr(Book.Calculate('="a~b"<"ab"')));   // True: пунктуация первой
    Writeln(VarToStr(Book.Calculate('="ABC"="abc"')));  // True: регистр игнорируется
  finally
    Book.Free;
  end;
end;
Word sort вступает в силу, лишь когда оба операнда текстовые. Смешанные типы подчиняются фиксированному ранжированию, где всякое число ниже всякого текстового значения, а всякое текстовое значение ниже всякого boolean, — об этом статья о цепочках сравнения, пустых операндах и SUMIF. Критерии с wildcards вроде "a*" или "=ab" — проверки шаблона и равенства со своими правилами, разобранные в руководстве по wildcards Excel в COUNTIF, MATCH и DSUM; обсуждаемая здесь коллация решает только операторы упорядочивания
Следующий пример загружает 20 слов в столбец A листа, проверяет три счётчика критериев и поиск, затем сортирует столбец через TXLSXWorksheet.SortRange. Ожидаемые счётчики напрямую следуют из показанного выше порядка сортировки: одиннадцать слов сортируются после группы ab, одиннадцать — раньше a-b, а три члена группы ab присоединяются к одиннадцати для >=AB
const
  Words: array [0..19] of string = ('ab', 'a-b', 'a~b', 'a_b', 'AB', 'a b',
    'ab1', 'ab-', '-ab', 'abc', 'a''b', 'Ab', 'b', 'a.b', 'a1b', 'a0',
    #$00E9, 'e', 'f', 'Z');
var
  Book: TXLSXWorkbook;
  Sheet: TXLSXWorksheet;
  i: Integer;
begin
  Book := TXLSXWorkbook.Create;
  try
    Sheet := Book.Sheets.Add('Words');
    for i := 0 to High(Words) do
      Sheet.Cells[i + 1, 1].Value := WideString(Words[i]);

    // Ожидаемо из порядка word sort: 11, 11, 14
    Writeln(VarToStr(Book.Calculate('=COUNTIF(A1:A20,">ab")')));
    Writeln(VarToStr(Book.Calculate('=COUNTIF(A1:A20,"<a-b")')));
    Writeln(VarToStr(Book.Calculate('=COUNTIF(A1:A20,">=AB")')));

    // Находит abc: поиск сравнивает без учёта регистра, как и Excel
    Sheet.Cells[1, 3].Formula := '=VLOOKUP("ABC",A1:A20,1,FALSE)';
    Book.Recalculate;
    Writeln(VarToStr(Sheet.Cells[1, 3].Value));                // abc

    // Один ключевой столбец, по возрастанию: a b, a.b, a_b, a~b, a0, a1b, ab, AB, Ab, ...
    Sheet.SortRange(1, 1, 20, 1, [1], [False]);
    for i := 1 to 20 do
      Writeln(VarToStr(Sheet.Cells[i, 1].Value));
  finally
    Book.Free;
  end;
end;
SortRange использует стабильную сортировку слиянием, так что ab, AB и Ab, сравнивающиеся как равные, сохраняют относительный порядок, который был у них до сортировки. Пустые ячейки уходят вниз при любом направлении ключа — именно туда их кладёт Excel
Как повторить порядок сортировки Excel в собственном Delphi-коде?
Чтобы воспроизвести текстовый порядок Excel вне книги, зовите CompareStringW с LOCALE_USER_DEFAULT и NORM_IGNORECASE, не добавляя SORT_STRINGSORT и NORM_IGNOREWIDTH. Следите за возвращаемым значением. API не возвращает знаковый результат; он возвращает CSTR_LESS_THAN (1), CSTR_EQUAL (2) или CSTR_GREATER_THAN (3), а при сбое вызова — 0. Вычитание 2 даёт привычную конвенцию отрицательное / ноль / положительное, но только после обработки случая 0, иначе сбойный вызов превращается в -2 и читается как «меньше»
uses
  Winapi.Windows, System.SysUtils, System.Generics.Defaults,
  System.Generics.Collections;

// Текстовый порядок Excel: word sort локали пользователя, без учёта регистра
function ExcelCompareText(const A, B: string): Integer;
var
  R: Integer;
begin
  R := CompareStringW(LOCALE_USER_DEFAULT, NORM_IGNORECASE,
    PWideChar(A), Length(A), PWideChar(B), Length(B));
  if R = 0 then
    RaiseLastOSError;          // 0 — это сбой, а не результат сравнения
  Result := R - CSTR_EQUAL;    // 1/2/3 становятся -1/0/1
end;

var
  Keys: TArray<string>;
begin
  Keys := ['abc', 'a-b', 'AB', 'a~b', '-ab', 'ab'];
  TArray.Sort<string>(Keys, TComparer<string>.Construct(
    function(const L, R: string): Integer
    begin
      Result := ExcelCompareText(L, R);
    end));
  // a~b, ab / AB (равны, в любом порядке), a-b, -ab, abc
end;
Если HotXLS уже в uses, lxStandard.XlsCompareText публичен и возвращает тот же порядок. Различие двух вариантов только в сбойном вызове API: функция выше бросает исключение, тогда как XlsCompareText откатывается к сравнению поднятых в верхний регистр строк по кодовым единицам, чтобы пересчёт не прерывался на полпути. Для автономной сортировки лучше бросать исключение: беззвучно неправильный порядок выслеживать труднее, чем исключение
TArray.Sort не стабилен, поэтому равные ключи вроде ab и AB могут выйти в любом порядке. Когда исходный порядок равных ключей важен, сортируйте массив индексов и используйте исходную позицию как вторичный ключ
Иногда столбец должен нарочно игнорировать порядок Excel. Классический случай — артикулы: X-100 и X100 — разные коды и должны сортироваться по кодовым точкам. У SortRange есть перегрузка, принимающая TXLSSortCompareEvent, объявленный как function(const Left, Right: Variant): Integer of object, и использующая его вместо встроенного сравнения
uses
  System.SysUtils, System.Variants, lxStandard, lxHandleX;

type
  TPartNumberOrder = class
    function Compare(const Left, Right: Variant): Integer;
  end;

function TPartNumberOrder.Compare(const Left, Right: Variant): Integer;
begin
  // Собственный компаратор тоже получает пустые ячейки (как Null): разместите их сами
  if VarIsNull(Left) or VarIsNull(Right) then
    Exit(Ord(VarIsNull(Left)) - Ord(VarIsNull(Right)));
  Result := CompareStr(VarToStr(Left), VarToStr(Right));   // ординарное, с учётом регистра
end;

var
  Sheet: TXLSXWorksheet;   // заполненный лист, строки 2..501, столбцы A..D
  Order: TPartNumberOrder;
begin
  // ...
  Order := TPartNumberOrder.Create;
  try
    // ключ по столбцу A, по возрастанию
    Sheet.SortRange(2, 1, 501, 4, [1], [False], xlsSortByRows,
      xlsSortExcelLike, Order.Compare);
  finally
    Order.Free;
  end;
end;
С пользовательским компаратором SortRange передаёт сырые значения ключей и оставляет размещение пустых ячеек вам — именно поэтому компаратор выше сперва разбирается с Null. Для убывающего ключа сортировка инвертирует всё, что вернёт компаратор, так что в этом направлении пустые уезжают наверх, если компаратор об этом не позаботился. Столбец, отсортированный так, больше не в порядке, которого ждут приближённый VLOOKUP или бинарный поиск XLOOKUP; что идёт не так в этих режимах на данных, отсортированных иначе, разобрано в руководстве по режимам бинарного поиска XLOOKUP и XMATCH
Почему одна и та же книга может сортироваться по-разному на другой машине?
Книга может сортироваться по-разному на другой машине, потому что текстовый порядок Excel зависит от локали пользователя Windows, и HotXLS следует этой зависимости нарочно. Word sort зависит от языка: шведская коллация, например, ставит ä после z, тогда как английская и немецкая держат её рядом с a, так что файл, пересчитанный коллегой в Стокгольме, может вернуть другой COUNTIF(...,">y"), чем тот же файл на десктопе в Чикаго. HotXLS передаёт LOCALE_USER_DEFAULT, чтобы его ответы равнялись ответам Excel на той же машине. Зафиксировать какую-то одну локаль выглядело бы аккуратнее, но заставило бы HotXLS расходиться с Excel на каждой машине, настроенной иначе
Для серверной генерации это даёт три практических следствия:
- Локаль, которая имеет значение, принадлежит учётной записи, под которой работает процесс. У службы Windows или пула приложений IIS региональные настройки могут отличаться от десктопа разработчика, так что результаты, видимые в IDE, не обязаны совпадать с тем, что посчитает производство
- Кэшированные результаты формул, записанные в файл, отражают локаль машины-генератора. Excel пересчитывает своей локалью, так что значение может измениться, когда файл откроют и пересчитают в другом месте; Excel ведёт себя так же со своими файлами
- Локали расходятся в основном на буквах с диакритикой, на парах букв, которые некоторые языки считают одной буквой, и на не-латинских письменностях. Тестовые данные из обычных английских слов разницу никогда не покажут, так что положите в выборку пару имён вроде
ÅngströmиÖberg
Совпадающий с Excel путь — Windows: каждая сборка Win32 и Win64, собрана ли она Delphi, C++Builder или Lazarus с Free Pascal, зовёт тот же CompareStringW. Когда сборка нацелена на не-Windows платформу, XlsCompareText использует WideCompareText из RTL, чей порядок берётся из коллационной библиотеки самой платформы
Обычные слова сортируются одинаково при всех правилах — вот почему неправильная коллация переживает тестирование до тех пор, пока не появятся дефисные артикулы, пунктуация или имена клиентов с диакритикой. HotXLS даёт ответ Excel на таких входных данных в обоих движках, XLS и XLSX, от операторов сравнения до SortRange. Поддерживаемые версии Delphi и C++Builder, лицензирование и пробная загрузка перечислены на странице Delphi Excel-компонента HotXLS