Проверка диапазона, записанная как =0<B2<100, возвращает FALSE в Excel на каждой строке, включая строку, где B2 держит 50. Excel сперва вычисляет 0<B2, получает TRUE, а затем спрашивает, меньше ли TRUE, чем 100; логическое значение стоит выше любого числа, поэтому ответ FALSE, что бы ни содержала B2. У пустых ячеек и SUMIF сюрпризы того же рода: пустая ячейка равна 0, "" и FALSE одновременно, а =SUMIF(A1:A10,">5",B1) суммирует десять ячеек столбца B
Расчётный движок, пересчитывающий такую книгу вне Excel, обязан воспроизводить эти ответы, даже когда они очевидно не то, что имел в виду автор. Кэшированный результат, лежащий в файле, — то, что видят просмотрщик, почтовый предпросмотр или нижестоящий импорт, пока никто не нажал F9. Если сервер запишет TRUE для проверки диапазона, а Excel позже покажет FALSE, один отчёт содержит два разных числа в зависимости от того, где он открыт, и никто не скажет, какому верить. Чинить формулу автора — работа автора
{{Почему =1<2<3 возвращает FALSE в Excel?
}}Excel возвращает FALSE для =1<2<3, потому что все шесть операторов сравнения делят один уровень приоритета и ассоциируются слева направо, значит формула означает (1<2)<3, и внутренний TRUE затем проигрывает состязание рангов числу 3. HotXLS Delphi Component разбирает цепочки сравнений так же в обоих своих движках книг — классическом TXLSWorkbook и XLSX-нативном TXLSXWorkbook. Парсер читает один операнд, и пока следующий токен — =, <>, <, >, <= или >=, строит узел сравнения со всем разобранным на данный момент левым ребёнком и следующим операндом правым, затем тащит узел в следующий раунд. Это тот же контур цикла, что для +, - и &
Капкан сидит в учебниковой грамматике. Записанная как expr = operand op expr, она заставляет рекурсивный спуск уходить в себя за правой стороной и тихо делает оператор правоассоциативным. При таком чтении =1<2<3 превращается в 1<(2<3), то есть 1<TRUE, то есть TRUE. Ошибка работает в обе стороны: =3>2>1 в Excel TRUE, а при правой ассоциативности FALSE, и =1=1=TRUE переворачивается так же. Скобочные формы выходят верными при любом разборе, поэтому ошибка проскальзывает мимо любого теста, проверяющего лишь (a<b)<c
Метод Calculate вычисляет строку формулы, не кладя её в ячейку, что делает его быстрым способом сверить целый список цепочек на обоих движках. Метод подробнее разобран в обзоре формульного движка HotXLS
uses
  SysUtils, Variants, lxCalc, lxHandle, lxHandleX;   // lxOk объявлен в lxCalc

const
  Formulas: array [0..6] of string = ('=1<2<3', '=3>2>1', '=(1<2)<3',
    '=1<(2<3)', '=1=1=TRUE', '=3>2>1=TRUE', '=1<2<3=FALSE');
  // Ответы Excel:  FALSE, TRUE, FALSE, TRUE, TRUE, TRUE, TRUE
var
  Classic: IXLSWorkbook;
  Xlsx: TXLSXWorkbook;
  i: Integer;
begin
  Classic := TXLSWorkbook.Create;   // с подсчётом ссылок через интерфейс
  Xlsx := TXLSXWorkbook.Create;
  try
    // TXLSXWorkbook.Calculate вычисляет против активного листа и
    // возвращает Null, когда у книги ещё нет листа
    Xlsx.Sheets.Add('Data');
    for i := 0 to High(Formulas) do
      Writeln(Formulas[i], '  classic=', VarToStr(Classic.Calculate(Formulas[i])),
        '  xlsx=', VarToStr(Xlsx.Calculate(Formulas[i])));
  finally
    Xlsx.Free;
  end;
end;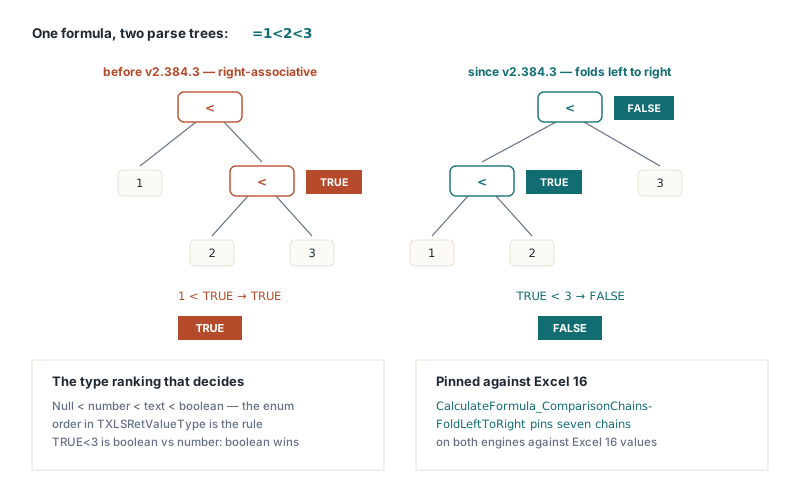
Числа, текст и булевы: межтиповое ранжирование
Когда две стороны сравнения разных типов, Excel не конвертирует одну в другую. Он ранжирует типы: любое число меньше любого текстового значения, а любое текстовое значение меньше любого булева. HotXLS классифицирует оба операнда как число, текст или булево и при разных классах сравнивает одни классы. Поэтому =TRUE>99999 — TRUE, ="1">2 — TRUE и =FALSE>"zzz" тоже TRUE. Это тот кусок, из-за которого цепные сравнения кажутся произвольными. TRUE<3 — не TRUE, приведённое к 1 и сравнённое с 3; это булево против числа, и булево побеждает
Внутри одного класса сравнение натуральное, с поворотом для текста: строковое сравнение игнорирует регистр, поэтому ="abc"="ABC" возвращает TRUE и в Excel, и в HotXLS. Даты для движка — серийные числа, значит дата всегда стоит ниже любого текста, включая текстовую ячейку, которая лишь выглядит как дата. Столбец импортированных дат, где половина ячеек приехала строками, будет сортироваться и сравниваться двумя раздельными полосами, и =A2>DATE(2026,1,1) возвращает TRUE для каждой из строковых ячеек
Чему равна пустая ячейка в сравнении?
}}Пустая ячейка в роли операнда сравнения принимает тип другой стороны: против числа она равна 0, против текста — "", против логического значения — FALSE. При пустой A1 все три =A1=0, =A1="" и =A1=FALSE в Excel TRUE. HotXLS делает ту же подстановку перед ранжированием операндов, для всех шести операторов сравнения и в обоих движках. Когда пусты оба операнда, подстановки нет, и они равны
var
  Wb: IXLSWorkbook;
  Sh: TXLSWorksheet;
begin
  Wb := TXLSWorkbook.Create;
  Sh := Wb.Sheets.Add;                  // первый лист становится активным
  Sh.Range['B1', 'B1'].Value := 5;      // A1 оставлена пустой нарочно

  Writeln(VarToStr(Wb.Calculate('=A1=0')));      // True
  Writeln(VarToStr(Wb.Calculate('=A1=""')));     // True
  Writeln(VarToStr(Wb.Calculate('=A1=FALSE')));  // True
  Writeln(VarToStr(Wb.Calculate('=A1<B1')));     // True: пустая сравнивается как 0
  Writeln(VarToStr(Wb.Calculate('=A1<0')));      // False: 0 не ниже 0
end;
Последняя строка — та, что кусается на практике. Арифметика уже считает пустую за 0, поэтому =A1+1 даёт 1 в любом движке. Сравнение — то место, где шорткат ломается. Движок, держащий «пусто» собственным низшим рангом, ниже любого числа, отвечает TRUE на =A1<0, и тогда =IF(A1<0,"overdrawn","ok") помечает каждую пустую ячейку баланса как овердрафт. Подстановки только 0 или пустой строки тоже мало: против булева пустая стала бы 0, стоящим ниже и TRUE, и FALSE, и =A1=FALSE вышло бы FALSE на пустой ячейке
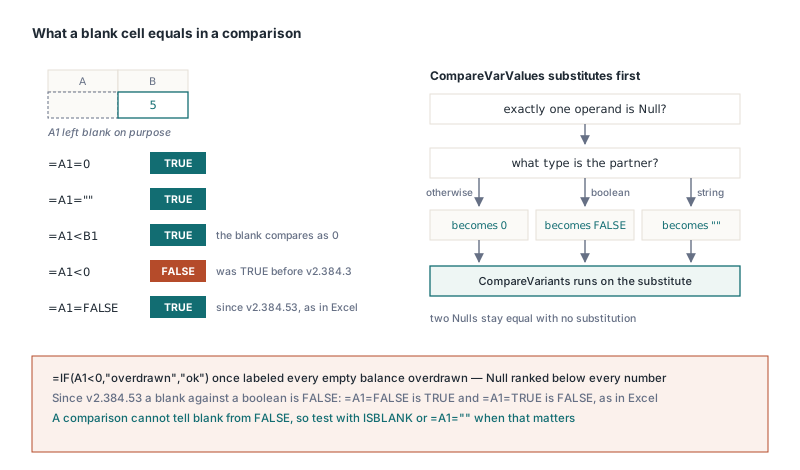
Есть следствие, о котором стоит подумать заранее. Поскольку пустая сравнивается как FALSE против логического значения, =A1=FALSE не отличает пустую ячейку от ячейки с FALSE — ни в Excel, ни в HotXLS, — и =A1=0 не отличает пустую от нуля. Шаблонам, которым надо знать, ввёл ли кто-то значение на самом деле, следует проверять через ISBLANK(A1). Форма =A1="" слабее: она TRUE и для формулы, возвращающей пустую строку
Почему SUMIF с одноячеечным sum range покрывает весь столбец?
Excel сохраняет форму критериального диапазона и использует sum range только ради его левой верхней ячейки, поэтому =SUMIF(A1:A10,">5",B1) означает B1:B10. На эту стенографию опирается масса ручных шаблонов, и авторы о том не знают. Очевидная реализация, зажимающая обход меньшим из двух диапазонов, свела бы пример к единственной проверке A1 против B1 и вернула 0. HotXLS идёт по критериальному диапазону и читает каждое значение с тем же смещением строк-столбцов от левого верхнего угла sum range. AVERAGEIF идёт тем же обходом и получает тот же resize, а sum range крупнее критериального обрезается до его формы
var
  Book: TXLSXWorkbook;
  Sheet: TXLSXWorksheet;
  Row: Integer;
begin
  Book := TXLSXWorkbook.Create;
  try
    Sheet := Book.Sheets.Add('Sales');
    for Row := 1 to 10 do
    begin
      Sheet.Cells[Row, 1].Value := Row;          // критериальный столбец: 1..10
      Sheet.Cells[Row, 2].Value := Row * 100;    // суммы: 100..1000
    end;
    Sheet.Cells[1, 4].Formula := '=SUMIF(A1:A10,">5",B1)';      // одноячеечный sum range
    Sheet.Cells[2, 4].Formula := '=SUMIF(A1:A10,">5",B1:B10)';  // явный sum range
    Sheet.Cells[3, 4].Formula := '=AVERAGEIF(A1:A10,">5",B1)';  // тот же resize
    if Book.Recalculate = lxOk then
      // D1 и D2: 4000 (600+700+800+900+1000); D3: 800
      Writeln(VarToStr(Sheet.Cells[1, 4].Value), ' ',
        VarToStr(Sheet.Cells[2, 4].Value), ' ', VarToStr(Sheet.Cells[3, 4].Value));
  finally
    Book.Free;
  end;
end;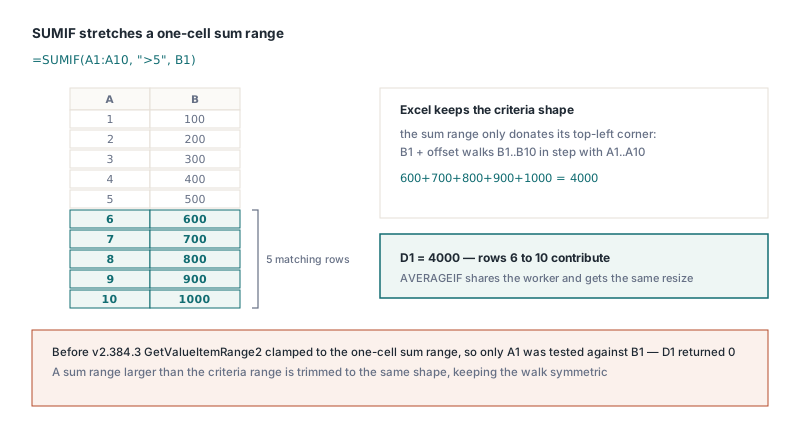
Для шаблонов, которые пишете сами, выписывайте полный sum range. Движок чтит стенографию, потому что от неё зависят существующие файлы, но B1 в формуле читается как одиночная ячейка для следующего человека, обслуживающего лист, и тот разумно решит, что складывается лишь одна сумма. Критерий посередине вычисляется как одиночное значение, тогда как два внешних аргумента — ссылки; этот раскол классов аргументов объяснён в статье о неявном пересечении и классах аргументов. Условные итоги, обязанные пропускать отфильтрованные или скрытые строки, следуют другим правилам снова — см. статью о SUBTOTAL и AGGREGATE и скрытых строках
Стили ссылок INDIRECT и YEARFRAC basis 0
Две функции поменьше несут капкан того же рода. INDIRECT принимает опциональный второй аргумент a1, и когда он FALSE, текст — ссылка R1C1: =INDIRECT("R2C3",FALSE) читает C2. Парсер, игнорирующий флаг, прочитает "R2" как столбец R, строку 2 — а это настоящая ячейка, поэтому формула вернёт правдоподобное значение не оттуда. HotXLS читает флаг как булево, число (ноль значит FALSE) или текст "FALSE" и конвертирует R1C1-текст перед разрешением, причём смещения в скобках вроде R[1]C[1] меряются от ячейки, держащей формулу. Текст с чем-то лишним после валидной ссылки, вроде "B2 junk", возвращает #REF! вместо тихого использования B2
YEARFRAC с basis 0 использует американский (NASD) счёт 30/360, включая февральские правила конца месяца, которые применяет DAYS360: когда обе даты — последний день февраля, конечный день становится 30, а затем старт на последнем дне февраля становится 30. С 2024-02-29 по 2025-02-28 это даёт 360 дней и долю ровно 1. Голый счёт 30/360 без тех правил даёт 359 дней и 0.99722, и разница всплывает в начислениях процентов через конец февраля
var
  Wb: IXLSWorkbook;
  Sh: TXLSWorksheet;
begin
  Wb := TXLSWorkbook.Create;
  Sh := Wb.Sheets.Add;
  Sh.Range['C2', 'C2'].Value := 'row 2, column 3';

  Writeln(VarToStr(Wb.Calculate('=INDIRECT("R2C3",FALSE)')));   // строка 2, столбец 3
  Writeln(VarToStr(Wb.Calculate('=ISERROR(INDIRECT("B2 junk"))')));  // True: #REF!
  Writeln(VarToStr(Wb.Calculate(
    '=YEARFRAC(DATE(2024,2,29),DATE(2025,2,28),0)')));           // 1
end;
Документируя или тестируя такое поведение, берите ожидаемые значения из самого Excel, а не из того, что формула как будто говорит. «1 меньше 2, а 2 меньше 3» намекает, что =1<2<3 — TRUE, и это ровно тот ответ, что даёт правоассоциативный парсер, и противоположность тому, что возвращает Excel. Короткая таблица формул со значениями, которые показывает Excel рядом, ловит все четыре случая этой статьи: цепочки, пустые, resize SUMIF и февральский счёт дней
HotXLS читает, пересчитывает и пишет XLS, XLSX, ODS и CSV из Delphi и C++Builder без Excel на машине, а правила сравнений, пустых ячеек и условных агрегатов выше принадлежат расчётному движку, который делят оба класса книг. Список поддерживаемых функций, редакции и лицензирование — на странице HotXLS Delphi spreadsheet component