Определённое имя, ссылающееся на целый столбец, Excel читает как одну ячейку, когда то стоит в скалярной позиции: =Vertical+1 в строке 7 значит «ячейка Vertical в строке 7», а не вся область. HotXLS Delphi Component применяет то неявное пересечение на двух уровнях — при вычислении и при извлечении зависимостей, потому что получить правильное значение ещё не всё. Обходчик зависимостей, раскрывающий имя в полную область, позволяет любой нижестоящей формуле, питающей ячейку той области, замкнуть цикл, которого нет, и TXLSXWorkbook.Recalculate пришлось бы тогда отказать всей книге как круговой
Книга амортизации кредита с 4805 формулами — стресс-случай, на котором всё это работает. Корректный пересчёт из устаревших кешей держится на трёх отдельных механизмах: неявном пересечении для имён, порядке scan-обходов и числовом типе вложенной арифметики. Ошибитесь в любом — и симптом либо lxErrorRef, код круговой ссылки, либо итоги, уплывающие от независимого построчного расчёта. Эта статья разбирает каждый механизм вместе с задействованным исходным кодом
Почему скалярная ссылка на имя столбца создаёт ложный цикл?
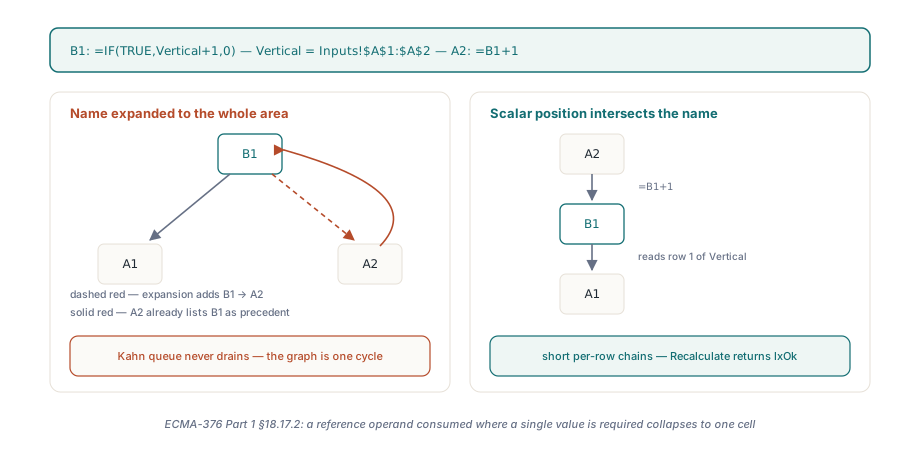
Потому что граф зависимостей знает только рёбра, а ребро от формулы к области в 480 строк — это 480 рёбер, одно из которых ведёт обратно через ячейку, зависящую от этой формулы. Возьмём =IF(TRUE,Vertical+1,0) в B1 при Vertical, определённом как Inputs!$A$1:$A$2, и =B1+1 в A2. Excel вычисляет B1 как A1+1, а A2 как B1+1 — прямая цепочка. Обходчик, который записывает B1 зависящей от A1:A2, делает A2 предшественником B1, тогда как A2 уже числит B1 своим предшественником, и очередь Кана, ведущая инкрементальный пересчёт в HotXLS, никогда не увидит, что у какого-то из узлов входная степень стала нулевой. Кредитные шаблоны именно из этого и состоят: каждая строка периода ссылается на именованные столбцы баланса, ставки и числа платежей, каждое имя охватывает весь график, и каждая строка ещё и пишет в эти столбцы. Раскройте имена — и граф превращается в одну гигантскую сильно связную компоненту. Вычислите их с неявным пересечением — и граф становится набором коротких цепочек, по одной на строку, что и описывает ECMA-376 Part 1 §18.17.2 для ссылочного операнда, потребляемого там, где требуется одно значение
var
  Book: TXLSXWorkbook;
  Sheet: TXLSXWorksheet;
begin
  Book := TXLSXWorkbook.Create;
  try
    Sheet := Book.Sheets.Add('Inputs');
    Book.DefinedNames.Add('Vertical', 'Inputs!$A$1:$A$2');
    Book.DefinedNames.Add('Alias', '=Vertical');
    Sheet.Cells[1, 1].Value := 1;
    // Скалярная позиция: Vertical схлопывается в A1, потому что формула в строке 1
    Sheet.Cells[1, 2].Formula := '=IF(TRUE,Vertical+1,0)';
    Sheet.Cells[2, 1].Formula := '=B1+1';
    // Имя, определение которого — другое имя, тоже пересекается, так что это A2
    Sheet.Cells[2, 2].Formula := '=Alias';
    // Аргумент ссылочного класса: суммируется вся область, без пересечения
    Sheet.Cells[3, 2].Formula := '=SUM(Vertical)';
    // Строка 6 лежит вне A1:A2, пересечение пусто, и его ловит IFERROR
    Sheet.Cells[6, 2].Formula := '=IFERROR(Vertical,42)';

    if Book.Recalculate = lxOk then
    begin
      // B1 = 2, A2 = 3, B2 = 3, B3 = 4, B6 = 42
      // Раскрой Vertical в A1:A2 здесь — и B1 -> A2 -> B1 стал бы ложным циклом
    end;
  finally
    Book.Free;
  end;
end;
Как HotXLS решает, что аргумент скалярный?
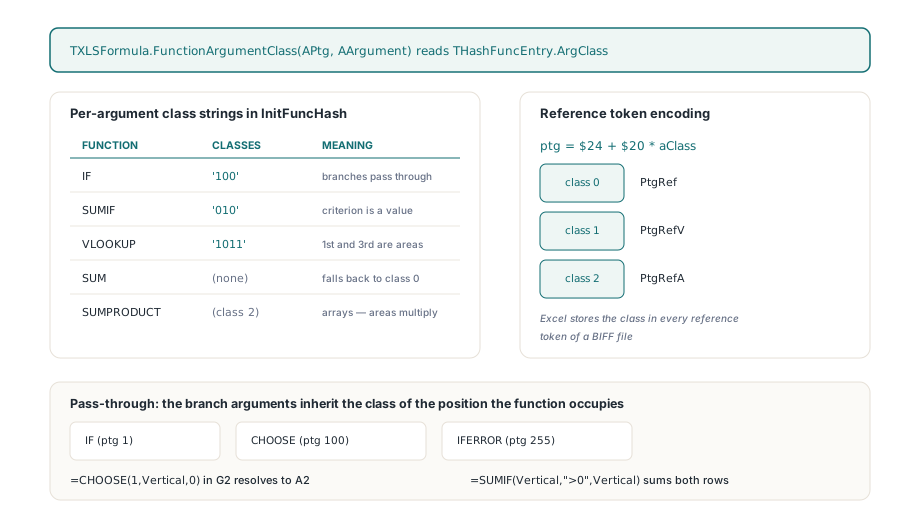
HotXLS берёт ответ из таблицы функций, а не из формы аргумента. Каждая запись в TXLSFormula.InitFuncHash регистрируется через THashFunc.SetValue с необязательной строкой классов по аргументам: 'IF' несёт '100', 'SUMIF' — '010', 'VLOOKUP' — '1011', а 'SUM' не несёт ничего, поэтому все его аргументы откатываются к классу 0 уровня функции. TXLSFormula.FunctionArgumentClass(APtg, AArgument) выставляет тот байт через THashFuncEntry.ArgClass, и результат 1 означает класс значения. Это те же три класса, что [MS-XLS] §2.2.2 назначает операндным токенам, и на них полагается и кодировщик: записывая ссылку, он вычисляет ptg как $24 + $20 * aClass, что даёт PtgRef для класса 0, PtgRefV для класса 1 и PtgRefA для класса 2. BIFF-файл, записанный Excel, хранит тот класс в каждом ссылочном токене, поэтому движок, чья таблица совпадает со спецификацией, может ответить на вопрос «скалярный ли этот аргумент», не глядя на данные. Средний аргумент SUMIF — критерий, значение; первый и третий — области, ссылки. SUMPRODUCT зарегистрирован с классом 2 уровня функции, массив, почему =SUMPRODUCT(Vertical,Vertical) всё ещё перемножает всю область
Три функции не смотрят в свою запись таблицы ни на что, кроме первого аргумента. IF (ptg 1), CHOOSE (ptg 100) и IFERROR (ptg 255) пропускают сквозь себя то, что выбирают, поэтому их аргументы-ветви наследуют класс той позиции, которую занимает сама функция. Именно это правило позволяет =CHOOSE(1,Vertical,0) в G2 свестись к A2, тогда как стоящий рядом =SUMIF(Vertical,">0",Vertical) всё равно суммирует обе строки, и именно это правило график амортизации нагружает больше всего, потому что его ячейки периодов опираются на IF, проверяя, открыт ли ещё кредит
Протаскивание класса через обход зависимостей
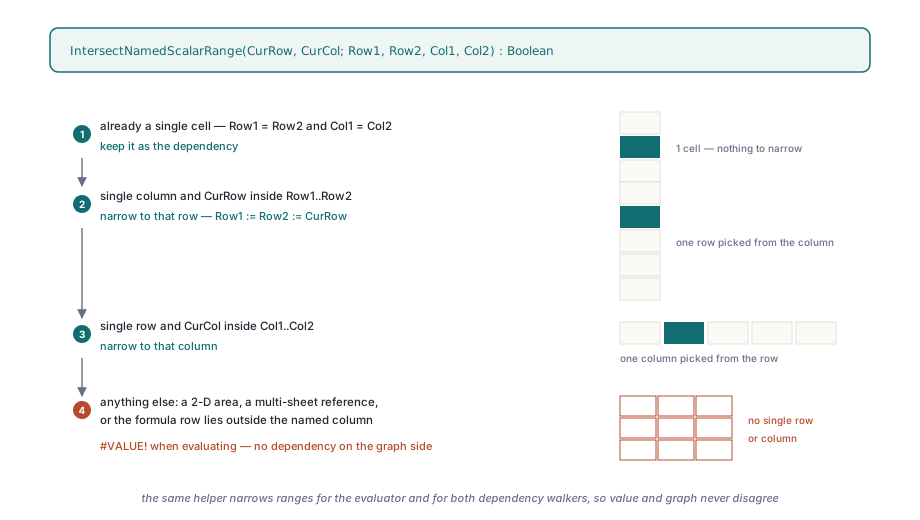
Извлекатель зависимостей в lxCalc.pas — это рекурсивный Walk по скомпилированному синтаксическому дереву, и он существует в двух экземплярах: один в TXLSCalculator.ExtractDependencies для графа в пределах книги, другой в ExtractWorkspaceDependencies для межкнижного графа. Оба обходчика несут два дополнительных параметра. AScalar стартует как True в корне формулы, пересчитывается для каждого дочернего вызова функции из FunctionArgumentClass и передаётся без изменений для аргументов-ветвей ptg 1, 100 и 255. ANameRoot становится True только когда обходчик спускается в скомпилированное определение имени, и выживает только через узлы SA_GROUP, то есть скобки, поэтому имя, определённое как =A1:A2+1, не принимается за простую область. Когда оба флага истинны в узле SA_RANGE, AddResolvedRange сужает область тем же хелпером, которым пользуется вычислитель, прежде чем записать зависимость. Хелпер достаточно короткий, чтобы привести его целиком
function IntersectNamedScalarRange(CurRow, CurCol: Integer;
  var Row1, Row2, Col1, Col2: Integer): Boolean;
begin
  Result := False;
  if (Row1 = Row2) and (Col1 = Col2) then Exit(True);   // уже одна ячейка
  if (Col1 = Col2) and (CurRow >= Row1) and (CurRow <= Row2) then
  begin
    Row1 := CurRow; Row2 := CurRow;                     // один столбец: берём эту строку
    Exit(True);
  end;
  if (Row1 = Row2) and (CurCol >= Col1) and (CurCol <= Col2) then
  begin
    Col1 := CurCol; Col2 := CurCol;                     // одна строка: берём этот столбец
    Result := True;
  end;
end;
Всё, что хелпер отвергает — двумерная область, ссылка на несколько листов или формула, чья строка лежит вне именованного столбца, — даёт #VALUE! на стороне вычисления и не даёт никакой зависимости на стороне графа, а это ровно то, что Excel делает при пустом пересечении. Сторона вычисления живёт в TXLSCalculator.GetValueItemName: метод снимает обёртки SA_GROUP со скомпилированного определения и, если корень — SA_RANGE, зовёт GetRangeInfo, пересекает и достаёт одну ячейку через FGetValue вместо вычисления всего определения. Внешние ссылки остаются на старом пути, потому что локальной строки, с которой можно пересекать, там нет. Откуда вообще берутся хранилище и область видимости имени, разобрано в статье про определённые имена и формулы между листами; здесь важно только то, что движок делает, когда имя разрешилось
Почему MATCH обязан ждать полупосчитанный столбец?
Потому что аргумент-массив поиска у MATCH — это scan-ссылка, а scan-ссылки намеренно держатся вне жёсткого порядка вычисления. Статья про scan при поиске вводит TXLSDepRange.LookupScan и проговаривает, чем вы платите за исключение scan-рёбер из упорядочивания: формула поиска может отработать раньше, чем пересчитана каждая ячейка её диапазона, и прочитать устаревшие значения. В интерактивном сеансе это сходится на следующем проходе. В однократном пакетном пересчёте шаблона с устаревшими кешами — нет: PaymentCount, определённое как =MATCH(0.01,Balances,-1)+1, прочтёт устаревшие значения, всё ещё сидящие в столбце баланса, и вернёт число периодов, которое правильным быть не может
Поэтому TXLSDepGraph.TopoOrder трактует scan-рёбра как мягкие рёбра упорядочивания. Наряду с жёсткой входной степенью он держит массив ScanInDeg, считая грязные scan-предшественники по узлам и уменьшая счётчик по мере выдачи этих предшественников, используя списки ScanPrecedents, ScanDependents и ScanPrecedentCount, которые граф уже хранит. На каждой итерации очередь Кана просматривает своё окно готовых узлов в поисках первого узла с нулевым ScanInDeg и переставляет его в голову; если все готовые узлы всё ещё ждут scan-предшественника, голова снимается в своём устойчивом порядке. Scan-рёбра никогда не попадают в жёсткую входную степень, поэтому самоссылочный VLOOKUP по собственному столбцу всё ещё законен, зато поиск, который может подождать завершимого предшественника, ждёт. С тремя ячейками баланса, держащими устаревшие значения, PaymentCount возвращается как 3; перещёлкните вход в ноль — и =IFERROR(PaymentCount,99) увидит #N/A и вернёт 99
Почему вложенная арифметика принуждается к Double
Потому что у Variant-арифметики Delphi есть ловушка, проявляющаяся только во вложенных позициях. Копирование + или - верхнего уровня в две локальные переменные Double держит =B1-A1 точным. Внутри =IF(TRUE,B1-A1,0) очевидная реализация гонит то же вычитание как Value := Value - SubValue над двумя Variant, и когда один операнд — значение ячейки Int64, а другой Double, наблюдаемый результат оказывается Currency — типом с фиксированной точкой и четырьмя знаками после запятой, — так что 1066.1854641400994 минус 120 вернётся усечённым до четырёх знаков. В графике, где каждый платёж наращивается с предыдущей строки, та ошибка проходит сотни периодов, прежде чем доберётся до итогов, почему TXLSCalculator.GetValueItem конвертирует оба операнда до запуска оператора
// TXLSCalculator.GetValueItem, ветка бинарной арифметики (lxCalc.pas)
if VarIsNull(Value) then Value := 0;
if VarIsNull(SubValue) then SubValue := 0;
// Смешанная арифметика Variant Int64/Double может повыситься до Currency.
// Арифметика таблицы должна сохранять точность с плавающей точкой.
if VarIsNumeric(Value) then Value := Double(Value);
if VarIsNumeric(SubValue) then SubValue := Double(SubValue);
Проверка идёт перед SA_ADD, SA_SUB, SA_MUL и SA_DIV одинаково, поэтому с Int64(120) в A1 и 1066.1854641400994 в B1 вложенные разность, сумма, произведение и частное сохраняют двойную точность. HotXLS не претендует на знание всех правил повышения типов, которые RTL применяет к смешанным Variant в разных версиях компилятора; он трактует табличную арифметику как IEEE double и делает оба операнда double до того, как их увидит оператор, — и вопрос снимается
Что движок гарантирует для именованных столбцов
С тремя механизмами на месте обе архитектуры движка пересчитывают шаблон амортизации из устаревших кешей до lxOk, и все 4805 значений совпадают с независимым построчным ожиданием в пределах 1E-7. Ни итерации не включены, ни один код ошибки не подавлен ради этого. Настоящий цикл через имя — =B1 в A1, где B1 всё ещё читает Vertical, — всё ещё возвращает ошибку, ровно как и должно
Правила следуют Excel. Неявное пересечение применяется к имени, чьё скомпилированное определение после снятия скобок — одностолбцовая или однострочная область на одном листе; двумерное имя в скалярной позиции даёт #VALUE!, как и в Excel, а функция, которой таблица не знает, получает от FunctionArgumentClass класс 0, поэтому её аргументы-имена раскрываются целиком. Мягкое упорядочивание — предпочтение, а не гарантия: цикл только из scan-рёбер вычисляется в устойчивом порядке и читает то, что закешировано, — компромисс, который статья про scan при поиске приняла сознательно. HotXLS — нативный компонент электронных таблиц для Delphi и C++Builder, читающий, пересчитывающий и пишущий XLS, XLSX, ODS и CSV без установленного Excel; пересечение имён, таблица классов аргументов и мягкое scan-упорядочивание действуют для всех форматов, потому что движок вычислений общий, а текущее покрытие функций перечислено на странице продукта HotXLS Delphi spreadsheet component