Энкодер Рида-Соломона, который хранит порождающий полином с константного члена и делит при этом со старшего, не вычисляет исправление ошибок вообще. HotPDF поставлялся ровно с таким в четырёх энкодерах 2D-штрихкодов — QR, Data Matrix, PDF417 и Aztec, — и каждый сгенерированный ими символ нёс проверочный блок, который не мог использовать ни один соответствующий стандарту сканер
Интересна не арифметическая ошибка, а её распространение. Один энкодер написали первым, его цикл деления скопировали в следующие три, и каждый новый формат унаследовал дефект, который ни разу не сверяли ни с одним опубликованным тестовым вектором. Символы по-прежнему рендерились, finder-паттерны сидели на своих местах, размеры были верными. Мусорными были только байты, которые позволяют 2D-штрихкоду пережить смазанность
Один перевёрнутый полином, скопированный в четыре энкодера
Корень — рассогласование порядка хранения внутри цикла синтетического деления. Все четыре энкодера HotPDF строят порождающий полином с коэффициентами от младшего к старшему, так что Gen[0] держит константный член, а Gen[High(Gen)] — монический старший коэффициент. Цикл деления индексировал Gen[J] вперёд, пока шёл по сообщению, что арифметически тождественно делению на перевёрнутый полином. Было и второе следствие, которое прятало первое: старший коэффициент никогда не попадал в позицию I, поэтому Work[I] никогда не обнулялся, и деление фактически ничего не сокращало. Цикл всё равно завершался и всё равно заполнял хвост массивом ровно нужной длины
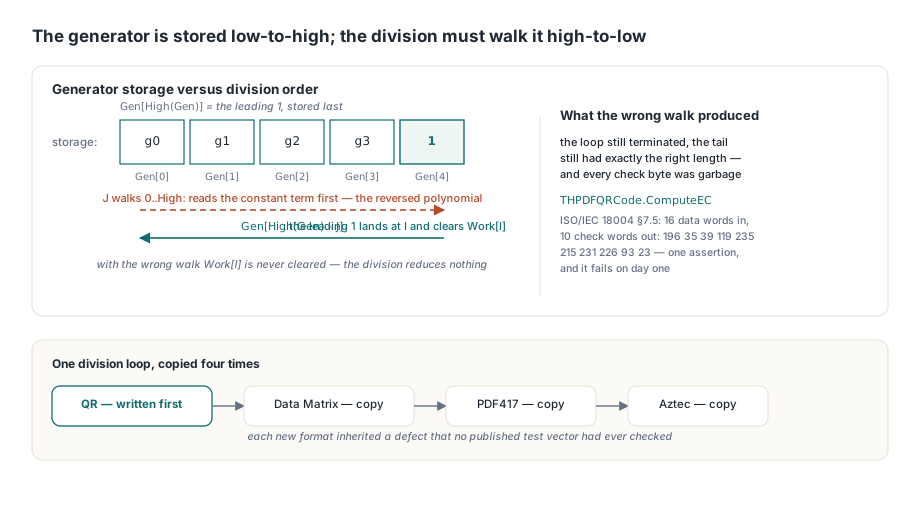
// THPDFQRCode.ComputeEC в HPDFQRCode.pas
Gen := GeneratorPoly(ECCount);            // Gen[0] — константный член
SetLength(Work, Length(Data) + ECCount);
for I := 0 to High(Data) do
  Work[I] := Data[I];
for I := Length(Data) to High(Work) do
  Work[I] := 0;
for I := 0 to High(Data) do
begin
  Factor := Work[I];
  if Factor = 0 then
    Continue;
  // Gen[High(Gen)] — старшая единица, которая обнуляет Work[I]; идти по Gen
  // вперёд — значит делить на перевёрнутый полином
  for J := 0 to High(Gen) do
    Work[I + J] := Work[I + J] xor GFMul(Gen[High(Gen) - J], Factor);
end;
Фикс — одно выражение индекса Gen[High(Gen) - J]. После него THPDFQRCode.ComputeEC воспроизводит разобранный пример из ISO/IEC 18004 §7.5: блок версии 1-M в byte-режиме 32 91 11 120 209 114 220 77 67 64 236 17 236 17 236 17 даёт десять проверочных слов 196 35 39 119 235 215 231 226 93 23. Это одна ассерция, и она бы упала в первый же день
Почему символ Aztec терял и полезные данные?
Aztec нёс более тяжёлую версию того же бага, потому что TAztecGF.Encode делит на месте. Руттина получает Words с сообщением и нулевыми слотами проверочных слов после него, а вызывающий эмитит весь этот массив в символ. Полиномиальное деление уничтожает делимое, пока его сокращает, так что после того, как цикл починили и он начал реально сокращать, слова сообщения перезаписывались по ходу. И полезная нагрузка, и mode message выходили испорченными — отказ, которого сломанная версия случайно избегала, никогда ничего не сокращая
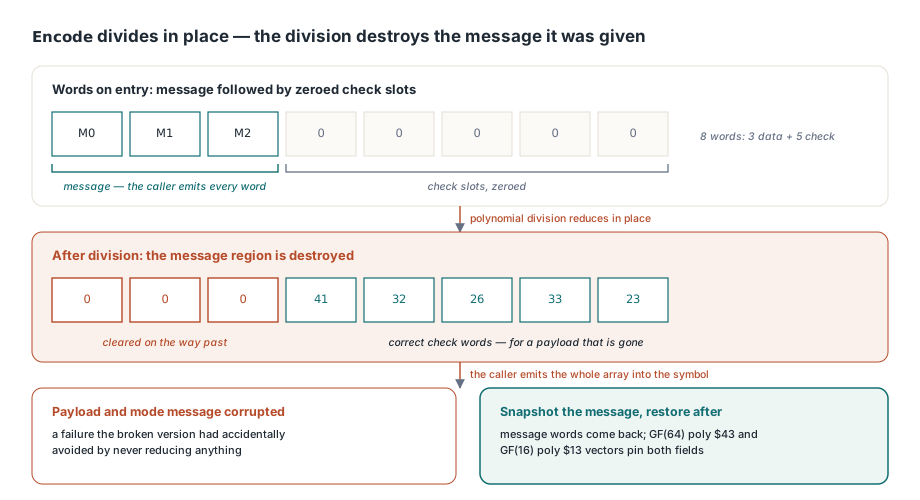
// TAztecGF.Encode в HPDFAztec.pas
SetLength(Message, DataCount);
for I := 0 to DataCount - 1 do
  Message[I] := Words[I];
for I := 0 to DataCount - 1 do
begin
  Factor := Words[I];
  if Factor = 0 then
    Continue;
  for J := 0 to ECCount do
    Words[I + J] := Words[I + J] xor Multiply(Gen[ECCount - J], Factor);
end;
// Деление затирает область сообщения, но вызывающий эмитит весь
// массив в символ, поэтому слова данных нужно вернуть
for I := 0 to DataCount - 1 do
  Words[I] := Message[I];
Aztec использует два разных поля, и регрессионный фикстур гоняет оба. В GF(64), поле шестибитового символа, построенного из примитивного полинома $43, слова 12 45 3 с пятью проверочными дают 41 32 26 33 23, а старшие три остаются нетронутыми. В GF(16), поле mode message с примитивным полиномом $13, слова 5 9 дают 11 15 6 8. Оба прогоняются через хук HPDFAztecTestEncode против ISO/IEC 24778
Почему Data Matrix требует двух фиксов вместо одного?
THPDFDataMatrix.ComputeEC наложил вторую, независимую ошибку поверх общей: он строил порождающий полином с корнями от α^0, тогда как ISO/IEC 16022, приложение E, задаёт корни от α^1. Если починить только индекс деления, для стандартного примера получаются проверочные слова 146 107 90 179 128 — выглядят ничуть не менее правдоподобно, чем правильные, и столь же нечитаемы. Чтобы числа сошлись, нужно было убрать оба дефекта
// THPDFDataMatrix.ComputeEC в HPDFDataMatrix.pas
Gen[0] := 1;
for I := 0 to ECCount - 1 do
begin
  // DMExp[I + 1]: корни идут alpha^1..alpha^ECCount, а не с alpha^0
  for J := ECCount downto 1 do
    Gen[J] := GFMul(Gen[J], DMExp[I + 1]) xor Gen[J - 1];
  Gen[0] := GFMul(Gen[0], DMExp[I + 1]);
end;
Точка отсчёта достаточно мала, чтобы держать её в комментарии. Строка '123456' кодируется в ASCII-кодовые слова 142 164 186, символ 10x10 несёт пять проверочных слов, и правильный блок — 114 25 5 88 102. HPDFDataMatrixTestComputeEC выставляет наружу классовую функцию за гейтом {$IFDEF HPDF_TESTING}, так что фикстур проверяет эти пять значений, не инстанцируя энкодер и не рендеря страницу. Само поле Галуа, построенное InitDMTables по примитивному полиному $12D в таблицы DMExp и DMLog, было верным всё это время — именно поэтому баг так хорошо прятался
PDF417 делит в простом поле, где знаки имеют значение
PDF417 потребовал четырёх изменений, а не одного, потому что GF(929) — простое поле, а не бинарное расширенное: сложение — это не xor, вычитание — не сложение, и знак каждого сомножителя генератора — настоящая арифметика, а не нотация. Каждый сомножитель должен быть (x - 3^i), что в коде означает умножение на 929 - GF929Pow(3, I); шаг сокращения должен вычитать; корни идут от 3^1 по ISO/IEC 15438 §5.5; а Factor нужно захватить в локальную переменную до внутреннего цикла, потому что проход J = 0 пишет в Work[I] и иначе поменял бы множитель у себя под ногами. HPDFPDF417TestComputeEC закрепляет исправленный результат: кодовые слова 5 453 178 121 239 с четырьмя словами коррекции дают 452 327 657 619
// THPDFPDF417.ComputeEC в HPDFPDF417.pas
for I := 1 to ECCount do
begin
  Root := (929 - GF929Pow(3, I)) mod 929;   // сомножитель — (x - 3^i)
  for J := ECCount downto 1 do
    Gen[J] := (GF929Mul(Gen[J], Root) + Gen[J - 1]) mod 929;
  Gen[0] := GF929Mul(Gen[0], Root);
end;
// ...
Factor := Work[I];                          // захват: J = 0 переписывает Work[I]
if Factor = 0 then
  Continue;
for J := 0 to ECCount do
  Work[I + J] := (Work[I + J] + 929 - GF929Mul(Gen[ECCount - J], Factor)) mod 929;
Finder Data Matrix был установлен наизнанку
Правильные проверочные слова не спасут символ с зеркальным finder-паттерном, и тот же релиз чинил и это. Код размещения рисовал сплошную левую колонку, сплошную правую колонку и чередующиеся модули по верхней и нижней строкам, тогда как ISO/IEC 16022 §5.2 требует сплошную левую колонку плюс сплошную нижнюю строку — L-образный finder — с чередующейся clock-дорожкой по верхней строке и правой колонке. Задом наперёд это получается из-за соглашения о координатах: HotPDF рендерит строки модулей в Y + I * ModuleSize, то есть с началом координат в левом верхнем углу, так что Modules[Size - 1, *] — нижняя строка напечатанного символа. Всякий, кто рассуждает в PDF user space, где Y растёт вверх, ставит сплошную ногу не на ту сторону и на экране не видит ничего подозрительного
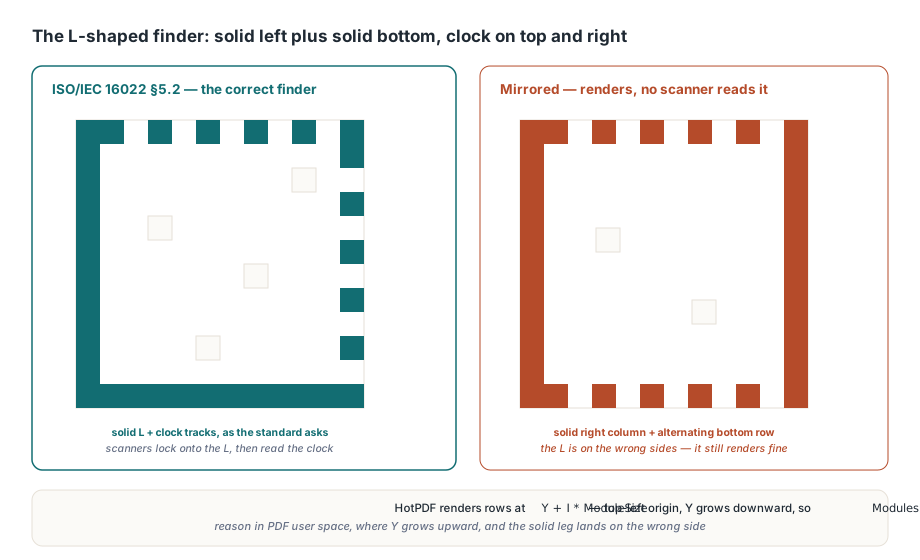
Почему четыре сломанных энкодера годами проходили тесты?
Потому что тесты проверяли структуру, а дефекты были в арифметике. Существующие кейсы QR, Data Matrix и Aztec сверяли модули finder, timing-паттерны и размеры символов — всё это было реально верным; ни один тест никогда не сравнивал проверочное слово с опубликованным вектором. Вторая причина обобщается дальше. HotPDF поставляет встроенный QR-декодер, и использовать его для проверки энкодера выглядит очевидным round trip, за одним исключением: этот декодер читает кодовые слова данных и не выполняет коррекцию Рида-Соломона, поэтому он считывал ровно то, что записал энкодер, и сообщал об успехе. Когда энкодер и декодер разделяют одно допущение, round-trip тест доказывает, что они согласны друг с другом, а не что кто-то из них прав. Код с исправлением ошибок обязан сверяться с векторами, напечатанными в стандарте, а не с собственным декодером. Фикстур THPDFBarcodeECCTests теперь держит по одному тесту на формат, каждый назван по тому, что закрепляет, и каждый доходит до арифметики через хук, компилируемый только под {$IFDEF HPDF_TESTING}:
QRCheckWordsMatchISO18004Exampleпроверяет десять проверочных слов примера версии 1-M в byte-режимеDataMatrixCheckWordsMatchISO16022Exampleпроверяет 114 25 5 88 102 для кодовых слов 142 164 186PDF417CheckWordsMatchGF929Referenceпроверяет 452 327 657 619 в GF(929) с корнями от 3^1 до 3^4AztecCheckWordsKeepMessageAndMatchReferenceпроверяет проверочные слова и то, что слова сообщения переживают деление на месте
Четыре вопроса ловят почти всё это семейство в любом энкодере, который вы сопровождаете. Порядок хранения генератора совпадает с порядком индексации в делении, и можете ли вы показать строку, которая это доказывает? Корни начинаются там, где говорит стандарт: α^1 для Data Matrix и 3^1 для PDF417? Восстанавливает ли деление на месте область сообщения после себя? Хотя бы один тест сравнивает проверочные слова, а не число модулей, с числом, напечатанным в спецификации? Масштаб тоже важен, когда решаете, что делать с существующими артефактами. Символы, сгенерированные до v2.748.0, рендерятся и часто сканируются в идеальных условиях, потому что чистой картинке для чтения не нужна коррекция; что они потеряли — это устойчивость к повреждениям, ради которой эти форматы и выбирают. Долгоживущие этикетки и архивные документы с затронутыми символами лучше перегенерировать, чем выборочно проверять камерой телефона. Энкодеры живут в поддержке штрихкодов в HotPDF, рядом с QR-декодированием и его обработкой ориентаций и слоем вывода отчётов, который кладёт символы на страницу; полный справочник barcode API поставляется с HotPDF Delphi Component для Delphi и C++Builder