OCR-текстовые слои, границы штрихкодов и боксы вымарывания лиц уезжают на обрезанных страницах PDF, когда пиксели битмапа мапятся обратно через MediaBox вместо бокса, который рендерер реально растрировал: CropBox, обрезанный по MediaBox (ISO 32000-1 §14.11.2). HotPDF мапит результаты ApplyLoadedOCRTextLayer, DecodeLoadedPageBarcodes и DetectLoadedRedactionFindings через этот видимый бокс, и любой ваш кастомный движок или детектор обязан делать то же
Симптом легко узнать, однажды увидев. Архив отсканированных договоров проходит OCR-конвейер, вывод searchable, и поисковое попадание по номеру пункта подсвечивается в полдюйма ниже и левее напечатанного номера. Большинство файлов в партии в порядке. Уехавшие все с одной сканирующей станции, которая пишет /CropBox, чтобы обрезать поле планшета. Эта одна деталь отделяет картинку, которую видел OCR-движок, от рамы, в которую лёг текстовый слой, и то же расхождение двигает границы штрихкодов и, что серьёзнее, боксы вымарывания лиц
Почему OCR-слой уезжает от отсканированных слов?
Текстовый слой уезжает, когда две половины конвейера расходятся во мнении, какой прямоугольник покрывает битмап. Рендеринг HotPDF, SVG-экспорт, вьюер и печать учитывают CropBox: страница отображается через свой CropBox, обрезанный по MediaBox, — как и предписывает ISO 32000-1 §14.11.2, — и GetLoadedPageVisibleBox возвращает этот видимый бокс. Трансформация устройство-в-страницу, построенная из GetLoadedPageBox(PageIndex, pbMediaBox, ...), наоборот, считает, что растр накрывает MediaBox, — растр и трансформация описывают разные прямоугольники, и каждая распознанная позиция возвращается со сдвигом на зазор между ними
Сделать это правильно — значит держать три вещи в согласии для каждой фичи распознавания: трансформацию, оценку пиксельного бюджета и бокс страницы, передаваемый кастомному движку в записи запроса. HotPDF выводит все три из видимого бокса, что заодно означает: распознавание видит только тот контент, который вьюеры реально показывают
Несколько случаев к расхождению невосприимчивы:
- Страницы без
/CropBoxили с CropBox, равным MediaBox, мапятся идентично через любой из боксов DecodeLoadedPageBarcodesс выставленнымHasRegionрендерит ровно переданную область и мапит через ту же область; проверка, что область лежит внутри страницы, использует MediaBox- Находки вымарывания по паттернам (имейлы, номера карт и прочее) приходят из извлечения текста в user space, а не из растра, так что от растрового маппинга зависят только находки детекции лиц
Три системы координат и какие API HotPDF какую используют
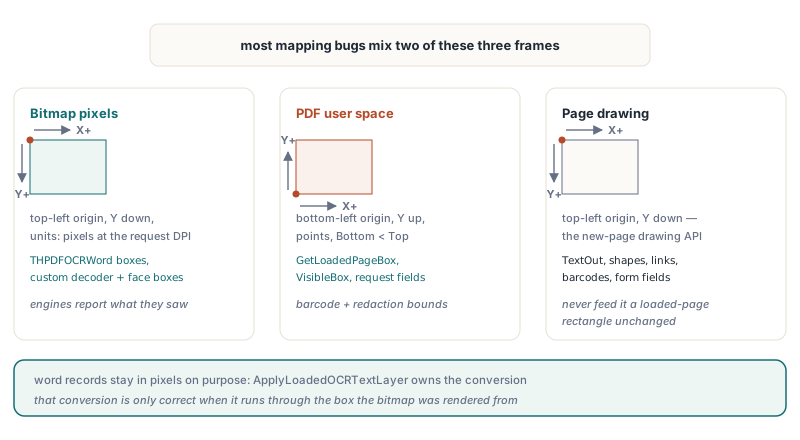
Код, трогающий распознавание HotPDF, имеет дело с тремя системами координат, и большинство ошибок маппинга рождаются из смешивания двух из них
- Пиксели битмапа: начало в левом верхнем углу, Y растёт вниз, единицы — пиксели при DPI запроса. В этой системе живут
THPDFOCRWord.Left,Top,RightиBottom, опциональные точки базовой линии, результаты кастомногоIHPDFBarcodeDecoderи боксы кастомногоIHPDFFaceDetector - User space PDF загруженной страницы: начало в левом нижнем углу, Y растёт вверх, единицы — пункты, с
Bottom < Top. В этой системеGetLoadedPageBoxиGetLoadedPageVisibleBoxвозвращают Left, Bottom, Right, Top, и то же верно для полейPageLeft,PageBottom,PageRightиPageTopзаписиTHPDFOCRRequest, границ вTHPDFDecodedBarcodeи прямоугольников вTHPDFRedactionFinding - Координаты рисования страницы HotPDF: API, которым вы строите новые страницы (вывод текста, фигуры, штрихкоды, ссылки, поля форм), работает с началом в левом верхнем углу и Y, растущим вниз. Эта система принадлежит генерации документов и не имеет ничего общего с API загруженных документов выше, так что никогда не скармливайте ей прямоугольник user space загруженной страницы без изменений
Запись слова OCR нарочно пиксельная: движок отчитывает то, что увидел в образе, а конверсия — вотчина ApplyLoadedOCRTextLayer. Это разделение работает, только когда конверсия берёт правильный бокс, — поэтому HotPDF строит её из видимого бокса
Трансформация устройство-в-страницу за OCR, штрихкодами и лицами
HotPDF мапит пиксели битмапа на страницу одной аффинной матрицей из пяти входов: поворота, масштаба DPI / 72, высоты битмапа и Left, Bottom, Right, Top отрендеренного бокса. OCR, декодирование штрихкодов и детекция лиц делят одну рутину, так что вход бокса определяет точность всех трёх разом. Для неповёрнутой страницы матрица страница-в-устройство [A B C D E F] такова:
A = ScaleиD = -Scale, гдеScale = DPI / 72; отрицательныйDпереворачивает user space (Y вверх) в пространство битмапа (Y вниз)B = C = 0, потому что неповёрнутая страница не имеет ни сдвига (shear), ни перестановки осейE = -Left * Scale— двигает левый край бокса в пиксельный столбец 0F = BitmapHeight + Bottom * Scale— мапит нижний край бокса в y = BitmapHeight, нижний край битмапа, так что верхний край приземляется в строку 0
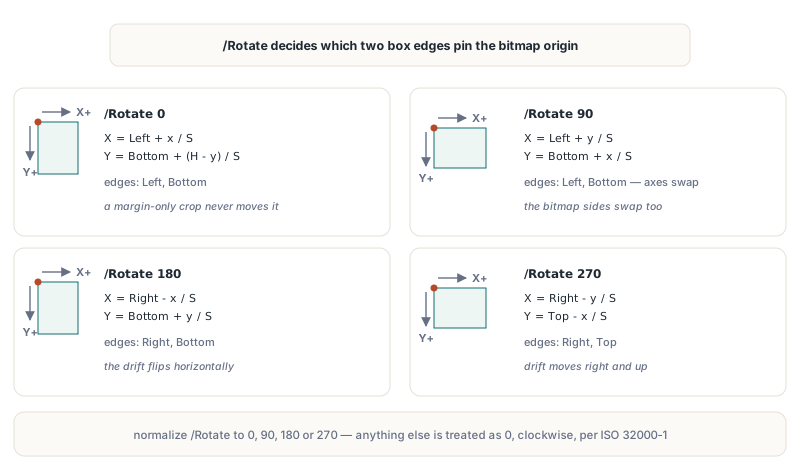
Пиксели возвращаются на страницу через обратную матрицу. Request.PageRotation несёт /Rotate страницы, нормализованный в 0, 90, 180 или 270 (любое значение, не кратное 90, трактуется как 0), а рендерер поворачивает страницу по часовой, как требует ISO 32000-1 §7.7.3.3. Под поворотом оси меняются местами, и к началу битмапа прикалывается другая пара краёв бокса. В виде обратных формул, с S = DPI / 72, x и y в пикселях и H — высотой битмапа:
| /Rotate | Страничный X | Страничный Y | Края бокса, на которых держится маппинг |
|---|---|---|---|
| 0 | Left + x / S | Bottom + (H - y) / S | Left, Bottom |
| 90 | Left + y / S | Bottom + x / S | Left, Bottom |
| 180 | Right - x / S | Bottom + y / S | Right, Bottom |
| 270 | Right - y / S | Top - x / S | Right, Top |
Последний столбец объясняет, почему маппинг по MediaBox выглядит в продакшене случайным. CropBox, обрезающий только верх страницы, не трогает Left и Bottom, так что прямые страницы выходят идеально, а уезжают лишь страницы с /Rotate 270. Поворот к тому же меняет местами размеры битмапа: при 90 и 270 битмап шириной (Top - Bottom) * S пикселей и высотой (Right - Left) * S пикселей
Что ломается с MediaBox [0 0 612 792] и CropBox [36 36 576 756]?
При обрезе в полдюйма с каждой стороны текстовый слой неповёрнутой страницы приземляется ровно в 36 пунктах левее и в 36 пунктах ниже отсканированных слов, если используется MediaBox. Возьмите страницу US Letter, чей CropBox обрезает 36 пунктов (0,5 дюйма) с каждого края. Видимый бокс — 540 на 720 пунктов, так что при дефолтном OCR-разрешении 300 DPI масштаб равен 300 / 72 ≈ 4,1667, а битмап — 2250 на 3000 пикселей
Пусть движок отчитал слово с пиксельным боксом Left 450, Top 600, Right 900, Bottom 660 и без базовой линии. HotPDF затем кладёт базовую линию в 20 процентов высоты слова над нижним краем, в пиксельной строке 648, и мапит стартовую точку (450, 648):
- Через видимый бокс: x = 36 + 450 / 4.1667 = 144.0 и y = 36 + (3000 - 648) / 4.1667 = 600.48 — там, где слово напечатано
- Через MediaBox: x = 0 + 108.0 = 108.0 и y = 0 + 564.48 = 564.48 — равномерный сдвиг на (-36, -36) пунктов
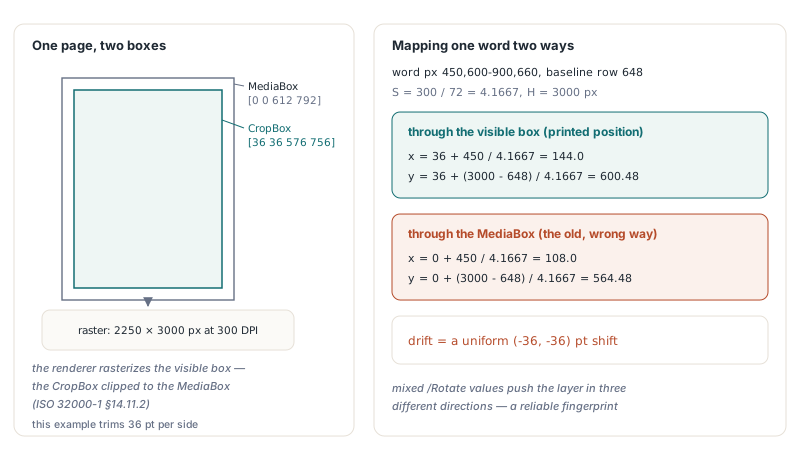
Поверните ту же страницу — и направление ошибки сменится, потому что в дело идут другие края. При /Rotate 180 X-член использует Right, и 612 вместо 576 толкает слой на 36 пунктов вправо, пока Bottom по-прежнему тянет его на 36 пунктов вниз. При /Rotate 270 слишком велики оба, Right и Top, так что слой уезжает на 36 пунктов вправо и на 36 пунктов вверх. Документ со смешанными ориентациями может показывать дрейф в трёх направлениях — надёжный отпечаток этой ошибки. Рукописный код, выводящий масштаб из бокса, вроде Bitmap.Width / (Right - Left), вдобавок растягивает каждую координату на 612 / 540, примерно 13 процентов, поверх сдвига
Какие из ваших PDF-страниц нуждаются в маппинге с учётом CropBox?
PDF-документ требует внимания, когда хотя бы одна страница имеет видимый бокс, отличающийся от MediaBox, и HotPDF может сообщить это в несколько строк. Сравнивайте GetLoadedPageBox с pbMediaBox против GetLoadedPageVisibleBox для каждой страницы и печатайте рядом GetLoadedPageRotation, чтобы предсказать направление дрейфа по таблице выше. THPDFPageBoundary к тому же предлагает pbCropBox, pbBleedBox, pbTrimBox и pbArtBox, но GetLoadedPageBox(pbCropBox) при отсутствии crop box откатывается к MediaBox и не обрезает, так что сравнивать надо именно с видимым боксом
uses
  System.SysUtils, HPDFDoc;

procedure ReportCroppedPages(const FileName: string);
var
  Pdf: THotPDF;
  I: Integer;
  ML, MB, MR, MT, VL, VB, VR, VT, Tmp: Single;
begin
  Pdf := THotPDF.Create(nil);
  try
    if Pdf.LoadFromFile(FileName) < 1 then
      raise Exception.Create('Cannot load ' + FileName);
    for I := 0 to Pdf.LoadedPageCount - 1 do
    begin
      if not Pdf.GetLoadedPageBox(I, pbMediaBox, ML, MB, MR, MT) then
        Continue;
      // сохранённый массив может перечислять углы в любом порядке
      if MR < ML then begin Tmp := ML; ML := MR; MR := Tmp; end;
      if MT < MB then begin Tmp := MB; MB := MT; MT := Tmp; end;
      // уже нормализован и обрезан по MediaBox
      if not Pdf.GetLoadedPageVisibleBox(I, VL, VB, VR, VT) then
        Continue;
      if (Abs(VL - ML) > 0.01) or (Abs(VB - MB) > 0.01) or
         (Abs(VR - MR) > 0.01) or (Abs(VT - MT) > 0.01) then
        Writeln(Format('Page %d  MediaBox [%g %g %g %g]  visible [%g %g %g %g]  /Rotate %d',
          [I + 1, ML, MB, MR, MT, VL, VB, VR, VT,
           Pdf.GetLoadedPageRotation(I)]));
    end;
  finally
    Pdf.Free;
  end;
end;
Для скриптов вроде этого важны две детали GetLoadedPageVisibleBox. Функция при неудаче оставляет out-параметры нетронутыми, так что предустановка дефолтного размера страницы перед вызовом — безопасный паттерн. А когда испорченный CropBox вообще не пересекается с MediaBox, функция возвращает MediaBox, а не пустой прямоугольник. Если отчёт перечисляет страницы, которые более ранний конвейер огласил через маппинг по MediaBox, помните: зафиксированный текстовый слой остаётся в сохранённом файле, и дефолтная опция SkipPagesWithText пропустит эти страницы на повторном прогоне, если вы её не выключите или сперва не удалите старый слой
Как кастомному IHPDFOCREngine мапить пиксели обратно в пространство PDF?
Кастомный IHPDFOCREngine должен возвращать боксы слов в пикселях битмапа и оставлять маппинг HotPDF; конвертируйте в user space только для собственных решений — и тогда берите бокс из запроса, никогда MediaBox. PageLeft, PageBottom, PageRight и PageTop запроса описывают отрендеренный видимый бокс, так что они совпадают с Request.Bitmap точно. Хелпер ниже — обратная величина трансформации библиотеки, включая её использование фактической высоты битмапа для прямых страниц, так что он сходится с HotPDF пиксель в пиксель
uses
  System.SysUtils, System.Math, Vcl.Graphics, HPDFDoc;

// Пиксель битмапа (начало в левом верхнем углу, Y вниз) в user space PDF
// (начало в левом нижнем углу, Y вверх) через бокс, из которого отрендерен битмап
procedure HotPixelToPage(Rotation, DPI, BitmapHeight: Integer;
  Left, Bottom, Right, Top: Single; X, Y: Double;
  out PageX, PageY: Double);
var
  S: Double;
begin
  S := DPI / 72.0;
  case Rotation of
    90:  begin PageX := Left + Y / S;  PageY := Bottom + X / S; end;
    180: begin PageX := Right - X / S; PageY := Bottom + Y / S; end;
    270: begin PageX := Right - Y / S; PageY := Top - X / S; end;
  else
    PageX := Left + X / S;
    PageY := Bottom + (BitmapHeight - Y) / S;
  end;
end;
Реальная причина нуждаться в user space внутри движка — зональное правило: накладные инвойсов, которые вы никогда не хотите searchable, или зона штампа, сбивающая распознаватель. Движок ниже, написанный на TInterfacedObject, чтобы подсчёт ссылок вёл его время жизни, фильтрует слова по тому, куда падают их центры на странице, и возвращает выживших нетронутыми в пиксельных координатах. RunRecognizer стоит за вашим собственным вызовом распознавателя
type
  TZoneFilterOCREngine = class(TInterfacedObject, IHPDFOCREngine)
  private
    FSkipLeft, FSkipBottom, FSkipRight, FSkipTop: Single;  // user space
    function RunRecognizer(Bitmap: TBitmap; MaxWords: Integer;
      out Words: THPDFOCRWords): boolean;  // ваш распознаватель, пиксельные боксы
  public
    constructor Create(SkipLeft, SkipBottom, SkipRight, SkipTop: Single);
    function GetName: AnsiString;
    function Recognize(const Request: THPDFOCRRequest;
      out Words: THPDFOCRWords; out Diagnostic: AnsiString): boolean;
  end;

function TZoneFilterOCREngine.Recognize(const Request: THPDFOCRRequest;
  out Words: THPDFOCRWords; out Diagnostic: AnsiString): boolean;
var
  Raw: THPDFOCRWords;
  I, Count: Integer;
  CX, CY: Double;
begin
  Diagnostic := '';
  SetLength(Words, 0);
  if not RunRecognizer(Request.Bitmap, Request.MaxWords, Raw) then
  begin
    Diagnostic := 'recognizer failed';
    Exit(False);
  end;
  SetLength(Words, Length(Raw));
  Count := 0;
  for I := 0 to High(Raw) do
  begin
    HotPixelToPage(Request.PageRotation, Request.DPI,
      Request.Bitmap.Height, Request.PageLeft, Request.PageBottom,
      Request.PageRight, Request.PageTop,
      (Raw[I].Left + Raw[I].Right) / 2, (Raw[I].Top + Raw[I].Bottom) / 2,
      CX, CY);
    if (CX >= FSkipLeft) and (CX <= FSkipRight) and
       (CY >= FSkipBottom) and (CY <= FSkipTop) then
      Continue;
    Words[Count] := Raw[I];  // всё ещё пиксели: HotPDF мапит их сам
    Inc(Count);
  end;
  SetLength(Words, Count);
  Result := True;
end;
Вручите движок ApplyLoadedOCRTextLayer(PageIndices, Engine, Options, Info) как всякому другому. Библиотека валидирует то, что возвращается, прежде чем доверять: слово отбрасывается и считается в Info.DroppedWordCount, когда его бокс покидает битмап, когда Right <= Left или Bottom <= Top, или когда Confidence вне 0..1 или ниже MinimumConfidence. Возврат большего числа слов, чем MaxWordsPerPage, или выталкивание бегущего итога за MaxTotalWords топит весь вызов ошибкой бюджета, так что уважайте Request.MaxWords в движке. Не конвертируйте боксы слов в user space перед возвратом; HotPDF трактует значения как пиксели, и слой сжимается к началу битмапа
Маппинг вывода собственного детектора
Тот же хелпер обслуживает самодельный конвейер поверх RenderLoadedPageToBitmap, который рендерит видимый бокс и применяет /Rotate точно как фичи распознавания. Прочитайте бокс через GetLoadedPageVisibleBox, нормализуйте поворот так же, как HotPDF, и мапьте два противоположных угла каждого пиксельного бокса. Ось Y переворачивается, а при 90 и 270 градусах оси меняются местами, так что смапленные углы выходят в произвольном порядке; берите минимум и максимум смапленных точек — ровно так HotPDF строит границы штрихкодов
const
  DPI = 200;
var
  Pdf: THotPDF;
  Bmp: TBitmap;
  VL, VB, VR, VT: Single;
  Rotation: Integer;
  PxL, PxT, PxR, PxB, X1, Y1, X2, Y2: Double;
begin
  Pdf := THotPDF.Create(nil);
  try
    Pdf.LoadFromFile('scanned-ids.pdf');
    if not Pdf.GetLoadedPageVisibleBox(0, VL, VB, VR, VT) then Exit;
    Rotation := Pdf.GetLoadedPageRotation(0) mod 360;
    if Rotation < 0 then Inc(Rotation, 360);
    if (Rotation <> 90) and (Rotation <> 180) and (Rotation <> 270) then
      Rotation := 0;
    Bmp := Pdf.RenderLoadedPageToBitmap(0, DPI);
    if Bmp = nil then Exit;
    try
      MyDetector(Bmp, PxL, PxT, PxR, PxB);  // ваш код, пиксельный бокс
      HotPixelToPage(Rotation, DPI, Bmp.Height, VL, VB, VR, VT,
        PxL, PxT, X1, Y1);
      HotPixelToPage(Rotation, DPI, Bmp.Height, VL, VB, VR, VT,
        PxR, PxB, X2, Y2);
      Writeln(Format('User-space box [%.2f %.2f %.2f %.2f]',
        [Min(X1, X2), Min(Y1, Y2), Max(X1, X2), Max(Y1, Y2)]));
    finally
      Bmp.Free;
    end;
  finally
    Pdf.Free;
  end;
end;
Поведение поворота разобрано глубже в статье о сплющивании поворота страницы без поломки боксов страниц, а конвейер декодирования штрихкодов, потребляющий ту же трансформацию, — в декодировании повёрнутых QR-кодов со страниц PDF. Если ваш движок оборачивает внешний распознаватель, адаптер Tesseract OCR для searchable PDF показывает изоляцию процессов и отмену на том же интерфейсе
Шпаргалка: координатный маппинг, безопасный при CropBox
- Рендерер растрирует видимый бокс — CropBox, обрезанный по MediaBox (ISO 32000-1 §14.11.2); каждый маппинг пиксель-в-страницу обязан использовать тот бокс, прочитанный через
GetLoadedPageVisibleBox ApplyLoadedOCRTextLayer, постраничныеDecodeLoadedPageBarcodesи находки лиц изDetectLoadedRedactionFindingsмапятся через видимый бокс, и любой кастомный движок или детектор обязан делать то же- Боксы
THPDFOCRWord— пиксели битмапа с началом в левом верхнем углу;GetLoadedPageBoxиGetLoadedPageVisibleBoxвозвращают user space PDF с началом в левом нижнем углу иBottom < Top - Масштаб —
DPI / 72; выводите его из DPI, никогда не из бокса страницы, делённого на ширину битмапа - /Rotate решает, какие края важны: Left и Bottom при 0 и 90, Right и Bottom при 180, Right и Top при 270
- Возвращайте OCR-слова в пикселях и позволяйте HotPDF их мапить; конвертируйте только ради собственной фильтрующей логики
- Перегоняя OCR по страницам, уже несущим текстовый слой, помните:
SkipPagesWithTextпропустит их, если вы не выключите опцию или не удалите старый слой сперва
Фичи распознавания, запросы боксов страниц и рендеринг загруженных документов, использованные здесь, поставляются в компоненте HotPDF для Delphi и C++Builder; лицензирование, триальные загрузки и полный список возможностей — на странице HotPDF Delphi PDF component