Положим, отчёт на 400 страниц встраивает один шрифт на 2 МБ: если списывать с каждой страницы всё, на что она ссылается, сумма выходит странная — страницы вместе насчитывают 800 МБ шрифта в файле, который на диске может занимать 30 МБ. Поделите шрифт поровну, и каждая страница станет стоить около 5 КБ, тогда ничто не выглядит дорогим, а память словно берётся из ниоткуда. Ни одно из двух чисел не отвечает на настоящий вопрос: сколько байтов освободится, если данный объект исчезнет
У этой величины есть имя в анализе куч — retained size, а в теории графов есть чистый способ её вычислить. Объект относят на счёт его доминатора — ближайшего объекта, через который обязан пройти каждый путь от корня к нему. Разделяемые объекты всплывают, пока не доберутся до узла, который действительно ими владеет, эксклюзивные остаются на месте, и итоги сходятся без двойного счёта
Shallow size, retained size и правило доминатора в HotPDF
Для загруженного документа HotPDF считает это через THotPDF.BuildLoadedObjectDependencyGraph. Вызов возвращает по одному THPDFObjectDependencyNode на каждый загруженный косвенный объект и по одному THPDFObjectDependencyEdge на каждую косвенную ссылку, а затем выполняет доминаторный анализ с корнем в Catalog документа — объекте, который назван записью /Root в trailer (ISO 32000-1 §7.7.2). У каждого узла два размера. EstimatedShallowBytes — то, что объект стоит сам по себе. EstimatedRetainedBytes — его собственная стоимость плюс shallow-стоимость каждого объекта, которым он доминирует
Вернёмся к шрифту. На него ссылается каждая страница, поэтому ни одна страница в отдельности им не доминирует; пути сходятся только в узле дерева страниц над этими страницами, которым в плоском дереве служит корневой объект /Pages. Два мегабайта шрифта оседают там, а затем закатываются в Catalog. Противоположный случай — image XObject, нарисованный на странице 12 и больше нигде: каждый путь к нему проходит через страницу 12, так что retained-размер страницы 12 включает весь образ целиком. Верх retained-списка — это поэтому список объектов, удаление которых действительно освободило бы память
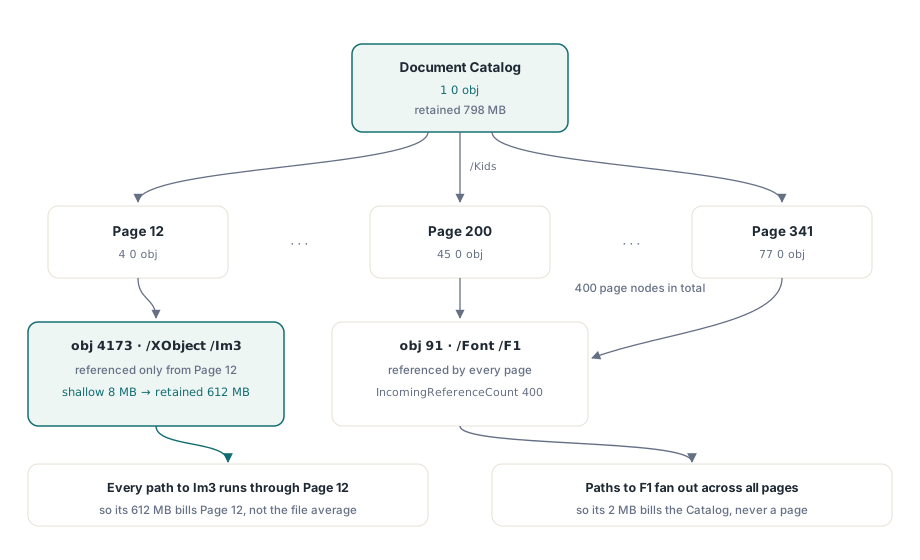
Та же арифметика дарит и одну перекрёстную проверку. THPDFObjectDependencyGraphInfo.CatalogRetainedBytes равен сумме shallow-размеров всех объектов, достижимых из Catalog, а TotalEstimatedBytes — сумме shallow-размеров всех загруженных объектов, достижимых или нет. Разница между ними — память, удерживаемая объектами, на которые документ больше не указывает
Запуск графа и чтение неудачного результата
Метод возвращает True, только когда весь анализ завершился, и именно это возвращаемое значение надо проверять. Результат False всё равно заполняет информационную запись, но массивы — не то, из чего стоит строить отчёт. Когда число объектов превышает MaxObjects (по умолчанию 250 000), метод останавливается до построения каких-либо узлов и выставляет ObjectCount на единицу больше лимита, так что вы узнаёте, что лимит был слишком мал, но не то, насколько велик документ. Когда в ходе сканирования исчерпывается бюджет рёбер (по умолчанию 2 000 000) или 256-уровневый лимит вложенности прямых объектов, узлы возвращаются с частичными shallow-размерами и вовсе без retained-размеров и достижимости
uses
  SysUtils, HPDFDoc;

procedure ProfileLoadedPdf(const FileName: string);
var
  Pdf: THotPDF;
  Nodes: THPDFObjectDependencyNodeArray;
  Edges: THPDFObjectDependencyEdgeArray;
  Info: THPDFObjectDependencyGraphInfo;
begin
  Pdf := THotPDF.Create(nil);
  try
    // LoadFromFile возвращает число страниц; 0 означает неудачную загрузку
    if Pdf.LoadFromFile(FileName) = 0 then
      Exit;

    // Поднятые лимиты для офлайн-криминалистического прогона
    if not Pdf.BuildLoadedObjectDependencyGraph(Nodes, Edges, Info,
      1000000, 8000000) then
    begin
      // Log — ваша собственная процедура логирования
      Log(Format('graph incomplete: %s (limit %s, invalid %s, objects %d)',
        [string(Info.Diagnostic), BoolToStr(Info.LimitExceeded, True),
         BoolToStr(Info.InvalidObjectGraph, True), Info.ObjectCount]));
      Exit; // не ранжируйте и не суммируйте частичный массив узлов
    end;

    Log(Format('%d objects, %d edges (%d unresolved), %d reachable',
      [Info.ObjectCount, Info.EdgeCount, Info.UnresolvedReferenceCount,
       Info.ReachableObjectCount]));
    Log(Format('estimated %d bytes, Catalog retains %d, unreachable %d',
      [Info.TotalEstimatedBytes, Info.CatalogRetainedBytes,
       Info.TotalEstimatedBytes - Info.CatalogRetainedBytes]));

    LogTopRetained(Nodes, Edges, 10);
  finally
    Pdf.Free;
  end;
end;
В той ветке неудачи заслуживают внимания ещё два флага. InvalidObjectGraph выставляется, когда объект Catalog не удаётся найти среди загруженных объектов или когда прямой объект внезапно оказывается сам себе содержимым — такое случается только на искажённом вводе. LimitExceeded покрывает и доминаторный анализ, который не сошёлся за 128 проходов. Diagnostic объясняет каждый случай одной строкой. Ноль или отрицательное значение MaxObjects, как и отрицательный MaxEdges, поднимают EArgumentOutOfRangeException вместо возврата False
Когда вызов спотыкается о лимит, выбросьте массивы и запустите его заново с большими границами. Частичные shallow-размеры выглядят в логе правдоподобно и ошибаются ровно так, что охота начинается не за тем объектом. Границы существуют потому, что граф сам имеет цену: каждое ребро хранит строку Path, значит прогон на восемь миллионов рёбер размещает восемь миллионов маленьких строк поверх документа, который измеряет. Ему место на диагностическом пути, который кто-то запускает намеренно
Что на самом деле считает EstimatedShallowBytes?
EstimatedShallowBytes оценивает резидентную память, а не байты в файле. Для каждого объекта он складывает размер экземпляра разобранного объекта и его прямых детей, слоты, занятые списками словарей и массивов, длину каждого ключа, имени и строки и полезную нагрузку потока, если она лежит в RAM: memory stream или лениво загруженный поток, уже прочитанный в память. Поток, чьи байты всё ещё сидят в исходном файле или вытеснены во временный файл, добавляет только накладные расходы своего объекта
Отсюда практическое следствие. Файл, перегруженный сканами, профилированный сразу после загрузки, может показывать скромные retained-размеры своих изображений, потому что никто их ещё не декодировал. Запустите граф после шага, на котором подрос процесс (рендеринг, извлечение текста, слияние), и материализованные потоки проявятся с реальным весом. Для воспроизводимой проверки профилируйте один и тот же файл дважды: сразу после LoadFromFile и после дорогой операции — и сравните верхние записи
ObjectType груб. Он сообщает тип значения PDF — otStream, otDictionary и так далее, поэтому изображение, программа шрифта и контентный поток страницы все читаются как otStream. Роль видна на входящем ребре. THPDFObjectDependencyEdge.Path записывает, где в исходном объекте нашлась ссылка, начиная с $: /Key для записей словаря, [n] для элементов массива и /dictionary для словаря потока. Путь $/Resources/XObject/Im3 от страницы или $/XObject/Im3 от отдельного словаря ресурсов означает, что объект используется как XObject с именем Im3; $/FontFile2 от дескриптора шрифта — встроенная программа TrueType; $/Contents[0] — контент страницы
// Ваш собственный помощник, не часть библиотеки: ранжирует верхние Count узлов по
// retained-размеру и печатает путь одной входящей ссылки для каждого
procedure LogTopRetained(const Nodes: THPDFObjectDependencyNodeArray;
  const Edges: THPDFObjectDependencyEdgeArray; Count: Integer);
var
  Taken: array of Boolean;
  I, J, Best: Integer;
  Via: AnsiString;
begin
  SetLength(Taken, Length(Nodes));
  for I := 1 to Count do
  begin
    Best := -1;
    for J := 0 to High(Nodes) do
      if (not Taken[J]) and ((Best < 0) or
         (Nodes[J].EstimatedRetainedBytes >
          Nodes[Best].EstimatedRetainedBytes)) then
        Best := J;
    if Best < 0 then
      Break;
    Taken[Best] := True;

    Via := '(no incoming reference)';
    for J := 0 to High(Edges) do
      if Edges[J].Resolved and
         (Edges[J].TargetObjectNumber = Nodes[Best].ObjectNumber) and
         (Edges[J].TargetGenerationNumber = Nodes[Best].GenerationNumber) then
      begin
        Via := Edges[J].Path;
        Break;
      end;

    Log(Format('%d %d obj  shallow %d  retained %d  refs in %d  via %s',
      [Nodes[Best].ObjectNumber, Nodes[Best].GenerationNumber,
       Nodes[Best].EstimatedShallowBytes, Nodes[Best].EstimatedRetainedBytes,
       Nodes[Best].IncomingReferenceCount, string(Via)]));
  end;
end;
Одного входящего пути хватает, чтобы классифицировать большинство объектов. Для разделяемого объекта IncomingReferenceCount говорит, сколько ссылок существует, а ImmediateDominatorObjectNumber с номером поколения — какой объект владеет им после доминаторного анализа. У Catalog и у каждого объекта, которого Catalog не может достичь, это поле равно -1. Ребро с флагом Resolved равным False указывает на не загруженный номер объекта; такие считаются в UnresolvedReferenceCount, и высокий счёт на в остальном здоровом файле обычно означает повреждённую секцию перекрёстных ссылок
Откуда берутся недостижимые объекты?
Узел с ReachableFromCatalog равным False загружен и стоит памяти, но ни одна цепочка ссылок от Catalog к нему не ведёт, поэтому ничто в структуре документа не приводит к нему просмотрщик. Его retained-размер равен shallow-размеру, потому что доминаторный анализ идёт только по достижимым объектам. Сумма EstimatedRetainedBytes по недостижимым узлам поэтому совпадает с TotalEstimatedBytes - CatalogRetainedBytes
Частый источник — инкрементальные обновления, хотя не так, как принято думать. Когда более поздняя ревизия переопределяет объект 2120, побеждает новейшая запись перекрёстных ссылок, а старое определение никогда не загружается, так что сменённые копии одного номера объекта в графе не появляются. Появляется другое: объект, на который поздняя ревизия просто перестала ссылаться — аннотация, выброшенная из переписанного массива /Annots, изображение, сменённое новым номером объекта, поле формы, убранное из AcroForm. Ничто в ISO 32000-1 §7.5.6 не обязывает обновление помечать такие записи свободными, и пока данные перекрёстных ссылок числят их занятыми, загрузчик считает их живыми объектами. Как наслаиваются ревизии, объясняет статья об object streams и инкрементальных обновлениях
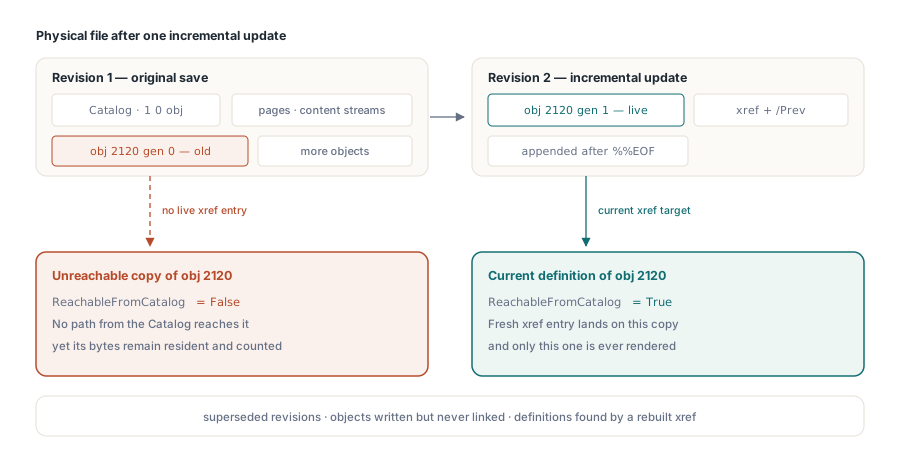
Два других источника — производители, которые пишут объекты и затем забывают их связать, и повреждённые файлы, чьи данные перекрёстных ссылок пришлось восстанавливать сканированием: оно может подхватить определения объектов, на которые ничто не ссылается. Когда крупная доля оценочного итога сидит в недостижимых узлах, чистая перезапись файла бьёт добавление очередной ревизии, и граф даёт вам счётчик байтов, чтобы оправдать более медленное сохранение
Может, память держит сам парсер?
Прежде чем обвинять документ, проверьте, как себя вела сама загрузка. Два вызова описывают парсер, а не содержимое, и оба сбрасываются в начале каждого LoadFromFile или LoadFromStream, поэтому всегда описывают самую свежую загрузку
GetLastParserArenaStatistics заполняет запись THPDFParserArenaStatistics о блочной арене, которая держит недолговечные токены и буферы во время разбора. Блоки по 64 КиБ (BlockSize), и размещение крупнее блока получает блок собственного размера. AllocationCount минус ReusedAllocationCount равно BlockAllocationCount — числу раз, когда арене пришлось просить у менеджера памяти новый блок. Блоки живут столько, сколько живёт экземпляр THotPDF, и освобождаются при его уничтожении. Если один экземпляр обрабатывает целую партию, RetainedBytes примерно отражает самый большой рабочий набор, который понадобился любому файлу партии, — отсюда плато, длящееся до освобождения компонента. TemporaryObjectElisionCount считает ключи словарей, прочитанные прямо в арену вместо построения временных объектов-имён
GetDocumentStringInternStatistics описывает пул на документ, дедуплицирующий PDF-имена, операторы контентных потоков и короткие строки. Кандидаты — строки от 1 до 64 байтов. Пул держит не более 65 536 записей и 4 МиБ, и эти потолки возвращаются в записи как MaxStringLength, MaxEntryCount и MaxRetainedBytes. Строка пустая, длиннее 64 байтов или новая при заполненном пуле — попадает в BypassCount и хранится как обычная строка. Файл, порождающий огромные числа уникальных имён, поэтому стоит примерно столько же, сколько стоил бы без пула, и не дороже
var
  Arena: THPDFParserArenaStatistics;
  Intern: THPDFDocumentStringInternStatistics;
begin
  if Pdf.GetLastParserArenaStatistics(Arena) then
    Log(Format('arena: %d blocks, %d bytes held, peak %d, ' +
      '%d new blocks for %d allocations, %d tokens',
      [Arena.RetainedBlockCount, Arena.RetainedBytes, Arena.PeakUsedBytes,
       Arena.BlockAllocationCount, Arena.AllocationCount, Arena.TokenCount]));

  if Pdf.GetDocumentStringInternStatistics(Intern) then
  begin
    Log(Format('intern: %d of %d requests hit, %d bypassed, %d bytes reused',
      [Intern.HitCount, Intern.RequestCount, Intern.BypassCount,
       Intern.ReusedBytes]));
    // Ваша собственная проверка, не вызов библиотеки: сигнализирует о пуле, упершемся в потолки
    if (Intern.EntryCount >= Intern.MaxEntryCount) or
       (Intern.RetainedBytes + Intern.MaxStringLength >
        Intern.MaxRetainedBytes) then
      Log('intern pool at its cap: later strings were not deduplicated');
  end;
end;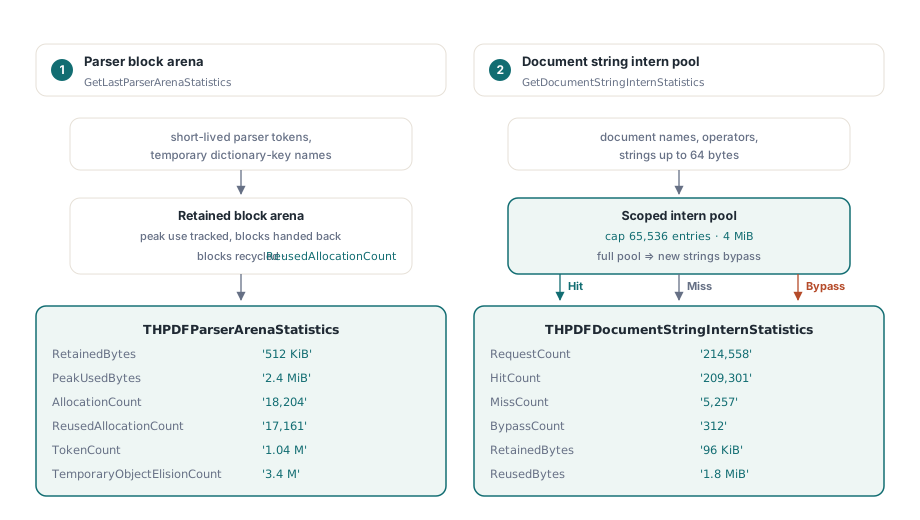
Типичные PDF повторяют небольшой словарь имён и операторов, поэтому HitCount сидит близко к RequestCount, а ReusedBytes растёт с числом страниц. BypassCount, приближающийся к RequestCount на скромном файле, — нештатно. На пути приёма недоверенных выгрузок занесите его в лог
Порядок сортировки при жалобе на память
Начните с CatalogRetainedBytes. Если он близок к приросту, который вы измерили в процессе, память сидит в документе, и верх retained-списка назовёт её. Если он сильно ниже, память живёт там, куда граф не заглядывает: ваши собственные кэши, отрисованные битмапы или арена парсера, и следующее, что стоит прочитать, — запись арены
- Ранжируйте узлы по
EstimatedRetainedBytesи читайте входящийPathпервой десятки. Цели-XObject наверху обычно указывают на контент, перегруженный сканами, где окупается даунсэмплинг; цели/FontFile,/FontFile2или/FontFile3— на полные программы шрифтов, встроенные там, где хватило бы сабсетов; большие потоки/Contentsобычно происходят из сгенерированного векторного вывода вроде карт или CAD-экспорта - Вычтите
CatalogRetainedBytesизTotalEstimatedBytes. Большой остаток — брошенные объекты, значит править надо шаг сохранения - Записи арены и интернирования читайте последними. Гигабайты они редко объясняют, но вполне объясняют процесс, который остаётся большим после закрытия всех документов
Пройдите эти шаги именно в таком порядке. Первый закрывает большинство жалоб, а для очень больших документов структурный ответ часто в том, чтобы вообще не держать весь граф объектов в памяти, — для этого построен воркфлоу прямого файлового API
Все три диагностики — обычные вызовы методов, возвращающие простые записи, так что они встраиваются в любой лог или телеметрию, которые приложение на Delphi или C++Builder уже имеет. HotPDF поставляется как нативный VCL-компонент с полным исходником; документация и пробная загрузка — на странице HotPDF Delphi PDF component