CMYK JPEG, вышедший из PDF с грязными, смещёнными или отрицательными цветами, почти всегда означает, что декодер перепутал один из двух фактов: хранились ли отсчёты как YCCK с необходимостью конверсии, и хранились ли они инвертированными по Adobe-соглашению. Декодеры HotPDF соблюдают параметр /ColorTransform фильтра DCTDecode для трёх- и четырёхканальных изображений, отвергают значения, которых спецификация не определяет, и позволяют маркеру Adobe APP14 внутри JPEG-данных иметь приоритет над записью словаря, как того требует ISO 32000-1 Table 13. Два соседних правила из той же семьи ловушек: multi-filter потоки обязаны нести массивы /DecodeParms, выровненные по стадиям, а JPEG 2000 сохраняет явное отображение /Decode
Все три случая объединяет тема: PDF уже сказал, что имеет в виду, а ловушка — рендерер, отвечающий на чуть другой вопрос
Почему CMYK JPEG рендерится в PDF инверсией или выцветшим?
CMYK JPEG ломается в PDF по одной из двух причин, и на экране они выглядят по-разному. Негатив, где белая бумага становится чёрной, а светлые оттенки темнеют, указывает на инвертированное хранение. Выцветшее или смещённое по оттенку изображение, где кожа зеленеет, а чёрный сереет при резком K-канале, указывает на трансформацию цвета, применённую зря, или пропущенную там, где была обязательна
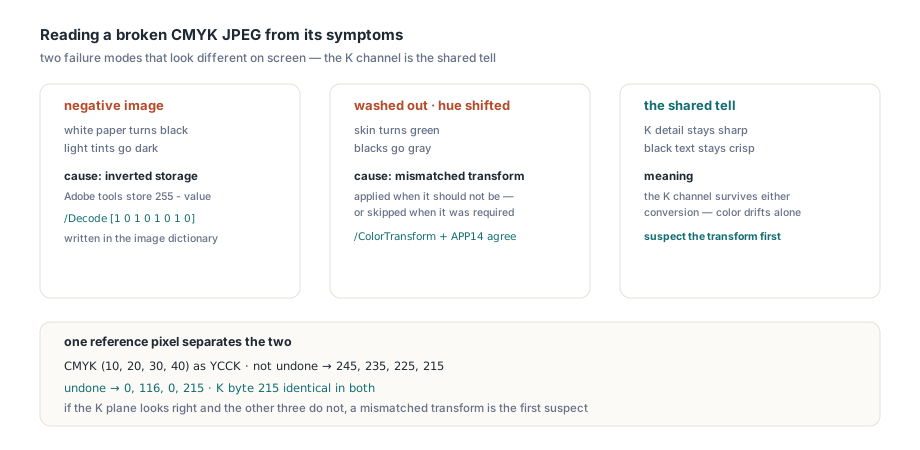
Проблема трансформации растёт из того, как JPEG сжимает цвет. Baseline JPEG сжимает лучше всего, когда яркость отделена от хромы, поэтому энкодеры обычно конвертируют RGB в YCbCr перед сжатием, а четырёхканальные энкодеры переводят CMY в YCC, пропуская K нетронутым, — это формат, называемый YCCK. Декодер обязан отменить ровно ту конверсию, которую применил энкодер. Отмените несостоявшуюся или пропустите состоявшуюся — и сдвинется каждый пиксель. Чёрный канал переживает оба сценария, потому у сломанного CMYK часто остаётся резкий чёрный текст, а дрейфует всё остальное
Проблема инверсии историческая. Photoshop и другие Adobe-инструменты пишут CMYK JPEG с каждым отсчётом, сохранённым как 255 - value, и помечают файл маркером Adobe APP14. Ничто в стандарте JPEG этого не требует — это соглашение, и каждый потребитель обязан о нём знать. В PDF от производителя ожидается, что инверсию он выразит в словаре изображения, а не оставит на догадках
Что декодеру говорит /ColorTransform?
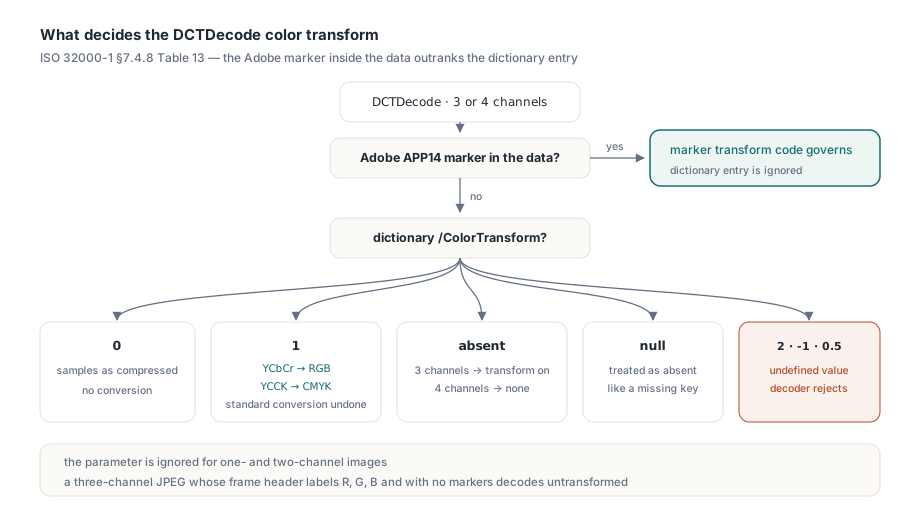
/ColorTransform — утверждение уровня PDF о том, какую конверсию декодер обязан отменить. ISO 32000-1 §7.4.8, Table 13, определяет два значения. Ноль — никакой трансформации: декодер возвращает отсчёты как сжато. Единица — энкодер применил стандартную конверсию, поэтому трёхканальное изображение идёт из YCbCr назад в RGB, а четырёхканальное — из YCCK назад в CMYK. Для одно- и двухканальных изображений параметр игнорируется. Table 13 также задаёт лёгкое к пропуску правило приоритета: когда кодированные данные несут Adobe-маркер с собственным кодом трансформации, управляет он, а запись словаря игнорируется. Только JPEG без такого маркера откатывается к словарю, а когда нет и записи — трёхканальное изображение по умолчанию получает трансформацию, четырёхканальное — нет
Лёгкая ошибка — путь изображения, принимающий словарь параметров, но так и не передающий его JPEG-декодеру. RGB JPEG в один пиксель цвета (128, 63, 31) вскрывает это немедленно: такой декодер вернёт [128, 63, 31] и для /ColorTransform 0, и для /ColorTransform 1, тогда как правильный ответ для нуля — сырая YCbCr-тройка [79, 101, 163]
HotPDF применяет параметр на уровне байтов. HPDFDecodeHeadlessTerminalImage сперва проходит структуру JPEG-сегментов до маркера start-of-scan и ищет сегмент Adobe APP14; байты, лишь похожие на него внутри сегмента комментария, не считаются. Если данные несут маркер, его код трансформации решает, а значение словаря игнорируется. Если не несут, декодер собирает приватную копию JPEG с вставленным сегментом APP14 прямо перед маркером start-of-scan — с кодом трансформации 0, 1 или, для четырёхканального изображения со значением 1, YCCK-кодом 2. Когда эффективная трансформация трёхканального изображения равна 0, копия заодно обезоруживает заголовок JFIF: JFIF-заголовок сам по себе велит libjpeg-turbo предполагать YCbCr. Буфер вызывающего не трогается, а когда сегмент вставлен, его 16 лишних байтов списываются с рабочего байтового бюджета до любых выделений декодера
Вставка только при отсутствии маркера важна из-за детали libjpeg: тот использует последний увиденный сегмент APP14. Вставьте сегмент после существующего маркера — и явное значение словаря молча перебьёт противоречащий маркер в данных, что ровно обратно правилу Table 13. HotPDF соблюдает порядок Table 13 на полном пути image XObject и на пути inline-изображений одинаково
Тот же терминальный декодер можно вызвать напрямую, когда одно изображение выглядит неправильно и хочется увидеть его отсчёты без рендеринга страницы. Функция живёт в юните HPDFHeadlessImageCodecs, принимает имя фильтра, кодированные байты, опциональный словарь параметров и геометрию из словаря изображения, которая обязана совпадать с заголовком кадра JPEG
uses
  SysUtils, HPDFObjs, HPDFHeadlessImageCodecs;

// ColorTransform < 0 означает "записи нет": решают маркеры JPEG
function DecodeDCT(const Encoded: TBytes; Width, Height, Channels,
  ColorTransform: Integer): TBytes;
var
  Parms: THPDFDictionaryObject;
begin
  Parms := nil;
  if ColorTransform >= 0 then
  begin
    Parms := THPDFDictionaryObject.Create(nil);
    Parms.AddNumericValue('ColorTransform', ColorTransform);
  end;
  try
    Result := HPDFDecodeHeadlessTerminalImage('DCTDecode', Encoded, nil, Parms,
      Width, Height, Channels, 8, 64 * 1024 * 1024, nil);
  finally
    Parms.Free;
  end;
end;
Декодер строг к тому, что считать легальным значением. Явный -1, 2 или нецелое вроде 0.5 поднимают EHPDFHeadlessImageError вместо отката к умолчанию: значение, которого спецификация не определяет, не даёт декодеру ничего надёжного, на что можно опереться. Проверка остаётся на месте даже когда Adobe-маркер в данных делает запись неважной — неопределённое значение структурная ошибка самого документа. Бюджет, слишком маленький для трансформированной копии, падает так же, с сообщением, называющим рабочий байтовый бюджет
Явный null — другой случай, потому что это вовсе не значение. ISO 32000-1 §7.3.9 говорит, что запись словаря со значением null эквивалентна отсутствующей, поэтому /ColorTransform null проваливается к маркеру или умолчанию по числу компонент ровно как при отсутствующем ключе. HotPDF трактует его так на каждом пути — headless и VCL, потоковом и inline
Ещё одно умолчание заслуживает упоминания, потому что HotPDF здесь намеренно идёт дальше буквы Table 13. Трёхкомпонентный JPEG без JFIF-заголовка и без Adobe-маркера, чей заголовок кадра подписывает компоненты R, G и B, самими своими байтами говорит, что держит RGB. Table 13 всё равно назначила бы ему трансформацию, но libjpeg и построенные на нём ридеры декодируют его без трансформации — и HotPDF тоже. Оба декодера, headless и VCL, трактуют его так, поэтому красный и синий остаются там, куда их положили данные. Явные словарные 0 или 1 по-прежнему перебивают этот вывод
uses
  System.IOUtils;

var
  Jpeg, Stored, Converted, ByMarkers: TBytes;
begin
  // сырые байты DCTDecode изображения CMYK 640 x 480, сохранённые из PDF-потока
  Jpeg := TFile.ReadAllBytes('suspect-image.jpg');
  try
    // С маркером Adobe APP14 в данных все три вызова согласны:
    // решает маркер, значение словаря игнорируется
    Stored    := DecodeDCT(Jpeg, 640, 480, 4, 0);   // без маркера: отсчёты как сжаты
    Converted := DecodeDCT(Jpeg, 640, 480, 4, 1);   // без маркера: YCCK отменён к CMYK
    ByMarkers := DecodeDCT(Jpeg, 640, 480, 4, -1);  // без маркера: умолчание на 4 канала, ничего
    Writeln(Format('pixel 0: stored %d,%d,%d,%d  converted %d,%d,%d,%d',
      [Stored[0], Stored[1], Stored[2], Stored[3],
       Converted[0], Converted[1], Converted[2], Converted[3]]));
  except
    on E: EHPDFHeadlessImageError do
      Writeln('Decoder refused the image: ', E.Message);
  end;
end;
Референсный четырёхканальный пиксель показывает, на что смотреть. CMYK-пиксель (10, 20, 30, 40), сохранённый как YCCK, возвращается как [245, 235, 225, 215], когда конверсия YCCK не отменена, и как [0, 116, 0, 215], когда отменена. K-байт, 215, в обоих случаях одинаков. Если K-плоскость выглядит верно, а остальные три нет — первым подозреваемым будет неподходящая трансформация
Инвертированное CMYK-соглашение живёт в /Decode
Терминальный декодер HotPDF возвращает CMYK-отсчёты ровно как их выдаёт libjpeg-turbo и не переворачивает их на основании Adobe-маркера. Числа выше делают соглашение видимым: 245, 235, 225, 215 — это просто 255 минус 10, 20, 30, 40, инвертированная форма, которую хранят энкодеры в стиле Adobe. Вернуть это в количества краски — работа словаря изображения, где производитель, встраивающий такой JPEG, должен написать /Decode [1 0 1 0 1 0 1 0]. Рендерер применяет массив /Decode к каждой компоненте, поэтому правильно написанный файл печатается правильно
Обратная сторона стоит прямых слов. PDF, встроивший Adobe-инвертированный CMYK JPEG без подобающего массива /Decode, отрендерится в HotPDF как негатив — потому что сам файл описывает изображение именно так. Некоторые вьюеры обнаруживают маркер APP14 и молча компенсируют. HotPDF такую эвристику не добавляет, поэтому починка такого файла живёт в софте, который его написал
Почему один словарь DecodeParms на два фильтра — ошибка?
Поток, чей /Filter — массив из нескольких стадий, обязан подавать /DecodeParms массивом той же длины: по словарю параметров или null на стадию. Это правило формулирует ISO 32000-1 §7.3.8.2, Table 5, и HotPDF его обеспечивает: multi-filter поток с одним общим словарём сообщается как недопустимый документ вместо декодирования
Снисходительная альтернатива хуже, чем кажется. Декодер, проверяющий длину только когда /DecodeParms уже массив, при одном словаре и двух фильтрах тихо переиспользует словарь на каждой стадии. С пустым словарём это безвредно, с непустым — разрушительно: /Predictor 12, предназначенный для внутреннего Flate-этапа, применится и к внешнему, и на выходе получится правдоподобная на вид ерунда вместо чистой ошибки. Поскольку намерение такого файла не восстановить, HotPDF его отвергает — даже в пустом случае, вроде content-потока страницы с /Filter [/FlateDecode /FlateDecode] и /DecodeParms << >>
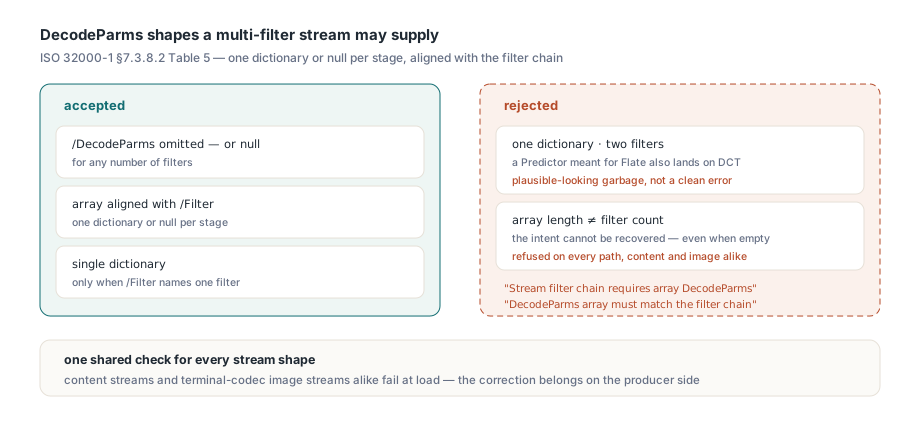
Принимаемые и отвергаемые формы легко перечислить:
- Принимается:
/DecodeParmsопущен илиnullпри любом числе фильтров - Принимается: массив, чья длина равна числу фильтров, каждая запись — словарь или
null - Принимается: одиночный словарь, когда
/Filterназывает ровно один фильтр - Отвергается: одиночный словарь, разделённый двумя и более фильтрами, с диагностикой "Stream filter chain requires array DecodeParms"
- Отвергается: массив, чья длина отличается от числа фильтров, с "DecodeParms array must match the filter chain"
Та же проверка гоняется для обычных content-потоков и для потоков изображений, чей последний фильтр — терминальный кодек вроде DCTDecode, поэтому кривая цепочка падает в одном месте, что бы ни нёс поток. Взаимодействие с лимитами декомпрессии раскрыто в статье о бюджетах цепочек фильтров и PDF-бомбах декодирования. Из кода приложения ошибка всплывает при рендеринге страницы
uses
  SysUtils, HPDFHeadlessDocument, HPDFHeadlessCairoDevice;

var
  Document: THPDFHeadlessDocument;
  Options: THPDFHeadlessRenderOptions;
  Info: THPDFHeadlessRenderResult;
begin
  Document := THPDFHeadlessDocument.Create;
  try
    try
      Document.LoadFromFile('catalog-cmyk.pdf');
      Options := THPDFHeadlessRenderOptions.Default;
      Info := HPDFRenderHeadlessPagePNGFile(Document.GetRenderAccess(0),
        'page1.png', Options);
      Writeln('images=', Info.Images, ' decoded bytes=', Info.DecodedBytes);
    except
      on E: Exception do
        Writeln('Rejected: ', E.ClassName, ': ', E.Message);
    end;
  finally
    Document.Free;
  end;
end;
JPEG 2000 хранит явный /Decode
JPEG 2000 игнорирует /Decode, только когда в его словаре нет /ColorSpace и он не image mask. Это условность ISO 32000-1 §8.9.5, и HotPDF её соблюдает. Выбрасывать /Decode для каждого не-stencil JPX — лёгкий путь, и он заставляет явную инверсию просто исчезнуть: JPX-сэмпл DeviceGray 64 под /Decode [1 0] обязан отрендериться как 191, а не 64
Поймать одно это условие недостаточно. Ветви color space вроде Lab и ICCBased, выставляющие диапазоны компонент по умолчанию при каждом JPX-изображении, перезаписали бы законно применённый массив вторично, поэтому рендерер запоминает, был ли реально применён валидный массив /Decode, и подставляет диапазоны по умолчанию, только если никакой не был. Явные диапазоны Lab и ICCBased поэтому выживают, а при молчащем словаре по-прежнему управляет декларация цвета кодового потока. Сторона декодера формата описана в статье о JPEG 2000 и JPXDecode
Какие пути декодирования следуют этим правилам?
Оба конвейера. На headless-стороне это загрузка THPDFHeadlessDocument, общий потоковый декодер и основанный на Cairo рендерер страниц за HPDFRenderHeadlessPagePNGFile. На VCL-стороне — извлечение загруженных изображений в TBitmap и VCL-рендеринг страниц, применяющие тот же порядок Table 13 при декодировании полных изображений и уменьшенных областей, поэтому JFIF-заголовок не продавит YCbCr против Adobe-трансформации 0, а нелегальное значение делает изображение недекодируемым и там. Inline DCT-изображения следуют тем же правилам маркера, null, умолчаний и отказов, что и image XObject, с сокращёнными и полными именами ключей — включая словарь /DP << … >> и сокращённые массивы фильтров вроде /F [/AHx /DCT], — а inline-изображение с нелегальными параметрами пропускается, пока остальная страница рендерится. Остальное поведение фильтров этого API раскрывает гид по извлечению изображений из загруженного PDF
Несколько практических заметок, прежде чем полагаться на это поведение:
- Декодирование JPEG требует совместимой библиотеки TurboJPEG в рантайме;
HOTPDF_TURBOJPEG_LIBRARYпереопределяет умолчальныеturbojpeg.dllилиlibturbojpeg.so.0 - Строгие структурные проверки отвергают файлы, которые снисходительные ридеры открывают, — в первую очередь общий пустой словарь
/DecodeParms; починка таких файлов — на стороне производителя
Для color-managed печатного конвейера практический вывод короток. Пишите CMYK JPEG с явным /ColorTransform, согласным с любым Adobe-маркером в данных, плюс массивом /Decode, отвечающим их хранению; давайте каждому multi-filter потоку выровненный по стадиям массив /DecodeParms; и ждите, что HotPDF будет требовать от файлов того, что они на самом деле говорят
Headless-загрузчик, потоковые декодеры и Cairo-рендерер страниц из этой статьи поставляются с HotPDF Delphi PDF component для Delphi, C++Builder и Lazarus — рядом с классическим VCL-движком документов