Пользователь вводит Müller в поисковое поле, не получает ничего, копирует то же имя из PDF, вставляет обратно в поле — и вдруг получает попадания. Проверьте обе строки в отладчике: Length возвращает 6 для набранной и 7 для вставленной. Набранное слово несёт U+00FC — единственный предсоставленный ü; документ хранит обычную u, за которой следует U+0308 COMBINING DIAERESIS. Оба рендерятся одними и теми же глифами, и сравнение кодовых единиц никогда не назовёт их равными
Почему визуально одинаковые строки сравниваются как неравные
Юникод нарочно допускает более одной кодировки для одного и того же абстрактного символа и называет такие кодировки канонически эквивалентными. Unicode Standard Annex #15 определяет две нормальные формы, важные для поиска: NFC, предпочитающую предсоставленные кодовые точки, и NFD, разбивающую каждый предсоставленный символ на базовую букву плюс её комбинирующие знаки в фиксированном порядке. Латинские буквы с диакритикой существуют в обеих формах. Так же и слоги хангыля — они могут выглядеть как один предсоставленный слог или как пробег из двух-трёх сочленяющихся чамо
Какая форма окажется в PDF, зависит от софта, который его произвёл, платформы, на которой он работал, а иногда и от того, как была построена карта ToUnicode шрифта. Документ, набранный на одной машине и отредактированный на другой, может смешивать обе формы на одной странице. Ничего из этого не видно человеку, который ищет. Его клавиатура и метод ввода обычно дают NFC, поэтому любой разложенный контент в файле становится для него ненаходимым
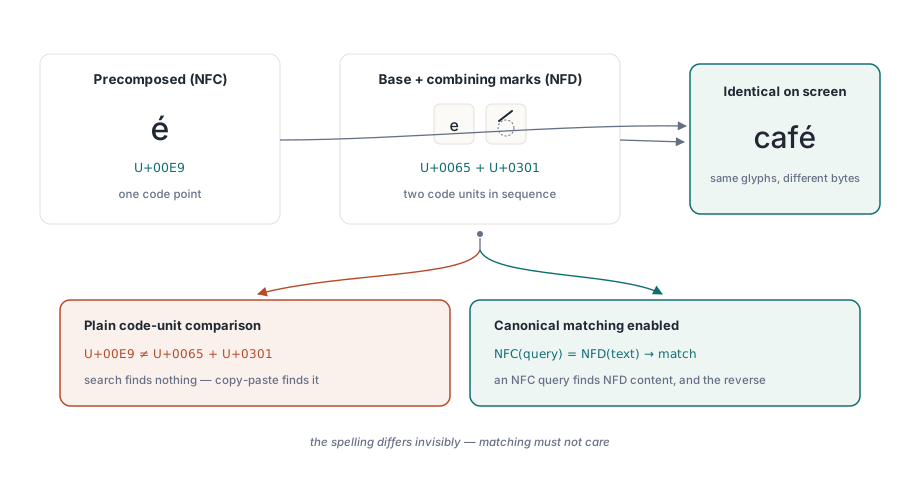
Очевидный обходной путь — бросить проблему в одну корзину со свёрткой регистра: привести обе стороны к нижнему регистру, снять акценты, сравнить. Это ломается по структурной причине. Свёртка регистра и снятие акцентов взаимно однозначны на уровне кодовых единиц, поэтому свёрнутый текст имеет ровно ту же длину, что оригинал, и совпадение на позиции 17 в свёрнутой копии — совпадение на позиции 17 в извлечённом тексте. Нормализация меняет длины. Одна предсоставленная буква становится двумя-тремя кодовыми единицами, разложенная последовательность схлопывается обратно в одну, слоги хангыля разворачиваются в чамо, и после этого преобразования возвращённые позиции больше не указывают на извлечённый текст
Поиск с soCanonicalEquivalent в PDF Library for Delphi
В PDF Library for Delphi член soCanonicalEquivalent из TPDFlibSearchOptions заставляет SearchText сравнивать канонические разложения запроса и текста страницы, так что NFC-запрос находит NFD-контент, а NFD-запрос — NFC-контент. Опция — часть множества, а значит сочетается с soWholeWord, soCaseSensitive, soWildcards и soDiacriticInsensitive без всякого отдельного API:
uses
  SysUtils, Math, PDFlibrary;

var
  Lib: TPDFlib;
  Hits: array of TPDFlibSearchHit;
  Found, Stored, I: Integer;
  Slice: WideString;
begin
  Lib := TPDFlib.Create;
  try
    Lib.LoadFromFile('contracts.pdf', '');
    Lib.SearchContextChars := 24;      // заполняет ContextBefore / ContextAfter
    SetLength(Hits, 500);

    Found := Lib.SearchText('Bäcker',
      [soCanonicalEquivalent, soWholeWord, soGraphemeClusters],
      '', Hits);                       // пустой диапазон страниц = все страницы

    // Found считает каждое совпадение; скопированы только первые Length(Hits)
    Stored := Min(Found, Length(Hits));
    for I := 0 to Stored - 1 do
    begin
      Slice := Copy(Hits[I].MatchText, Hits[I].MatchStart,
        Hits[I].MatchLength);
      Writeln(Format('page %d: [%s] %d code units, ...%s|%s|%s...',
        [Hits[I].Page, Slice, Hits[I].MatchLength,
         Hits[I].ContextBefore, Slice, Hits[I].ContextAfter]));
    end;
  finally
    Lib.Free;
  end;
end;
Две детали в том цикле на людей спотыкаются. SearchText возвращает общее число совпадений, даже когда буфер меньше, поэтому итерация до Found - 1 на большом документе уводит за конец массива из 500 элементов; обрезайте через Min или переходите на SearchTextEach, который передаёт каждое совпадение колбэку и вовсе не требует буфера. И MatchText — это весь текстовый блок, содержавший совпадение, с MatchStart как индексом с единицы в него, так что само найденное слово — тот Copy, что показан выше
Прогоните это по файлу, хранящему Bäcker разложённым, и напечатанная длина — 7; против NFC-файла — 6. Тот же запрос, тот же набор опций. Срез — всегда текст так, как он лежит в документе
Куда попадает совпадение в исходном тексте
То последнее свойство и делает нормализованный поиск пригодным для чего-то сверх ответа да/нет. PDF Library for Delphi записывает для каждой кодовой единицы, которую производит нормализатор, начало и конец исходного диапазона UTF-16, из которого она приехала. Рекурсивное разложение наследует диапазон родителя, композиция сливает диапазоны своих входов, а при нахождении совпадения поиск сканирует отображённый интервал на наименьшее начало и наибольший конец
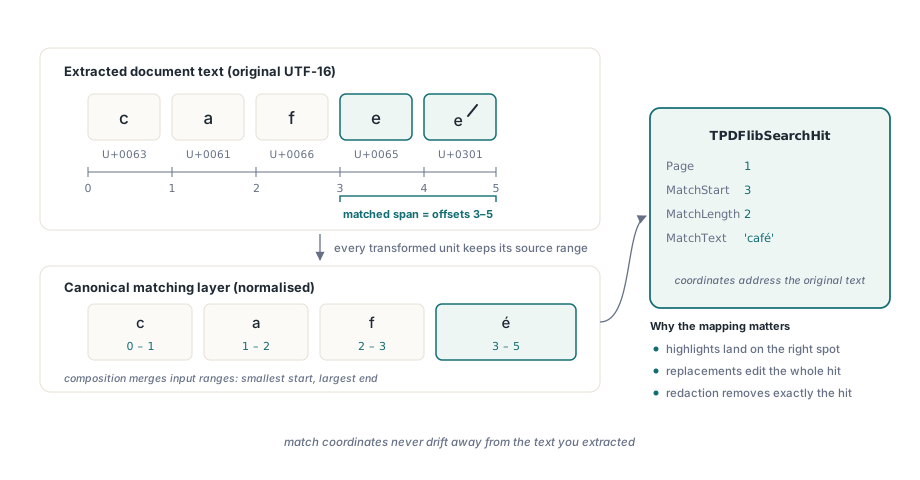
В результате MatchStart, MatchLength, ContextBefore, ContextAfter и обе точки входа замены адресуют извлечённый текст, который у вызывающего уже есть. Поиск, который мог бы сказать «в этом блоке есть совпадение», но не где именно, сойдёт для счётчика результатов и будет неправильным для всего остального: подсветка уплывала бы на символ-два за каждую букву с акцентом, а замена переписала бы не тот пробег текста
Нормализатор едет внутри библиотеки. Он несёт компактные таблицы канонического разложения, композиции и канонического класса комбинирования из Unicode 15.1, применяет алгоритмические правила для хангыля вместо табличных записей и стабильно переупорядочивает комбинирующие знаки при NFD. Никакой внешний файл данных не грузится и никакого вызова нормализации ОС не делается, поэтому служба Windows, демон Linux и сборка Free Pascal возвращают идентичные совпадения для одного файла. Мы предпочитаем именно так, хотя на Windows работу могла бы выполнить сама ОС: поисковый индекс, построенный на одном сервере и опрошенный на другом, не должен расходиться из-за разных версий Unicode на машинах
Опция по умолчанию выключена, и то умолчание разумно. Построение текста NFD и его карты позиций стоит времени, а поиск по счетам из одних ASCII никогда в этом не нуждается. Когда задан soCanonicalEquivalent, каждый текстовый блок держит две преобразованные копии — с комбинирующими знаками и без, так что партия запросов по одному блоку нормализует его один раз. Обычная свёртка регистра остаётся на более дешёвом взаимно однозначном пути
Что идёт не так, когда совпадение кончается внутри символа
Каноническая эквивалентность отвечает на вопрос «это тот же текст», но не говорит, где совпадению позволено остановиться. Поищите разложённый café по cafe с одним soCanonicalEquivalent — первые четыре кодовые единицы совпадут; следующий за ними комбинирующий акут останется вне совпадения. soWholeWord этого не поймает, потому что его словесные символы следуют правилам идентификаторов (ASCII-буквы, цифры и подчёркивание), а комбинирующий знак считается границей. Подсветка покроет cafe, а замена оставит висячий акцент над тем, что дальше
То же происходит далеко за пределами латинских акцентов. Эмодзи-флаг — это две кодовые точки регионального индикатора. Эмодзи-семья — несколько человечков, соединённых zero-width joiner. Деванагарская лигатура — согласная, вирама и ещё одна согласная, а вьетнамская гласная может нести две штабелированные метки. Всё за пределами базовой многоязычной плоскости — суррогатная пара в UTF-16, и разрез пополам даёт неспаренную суррогатную, которую многие текстовые конвейеры заменяют на U+FFFD
soGraphemeClusters требует, чтобы оба конца каждого совпадения — буквального или подстановочного — падали на границы расширенных графемных кластеров, определённые в Unicode Standard Annex #29. Сегментация покрывает спаривание CR/LF, управляющие символы, типы слогов хангыля, Extend и SpacingMark, Prepend, эмодзи-последовательности с ZWJ, пары региональных индикаторов и разрывы индийских конъюнктов, и никогда не кладёт границу внутрь суррогатной пары. С выставленным флагом cafe вообще перестаёт находить разложённый café; добавьте soDiacriticInsensitive, если вам на самом деле нужно сопоставление вслепую к акцентам
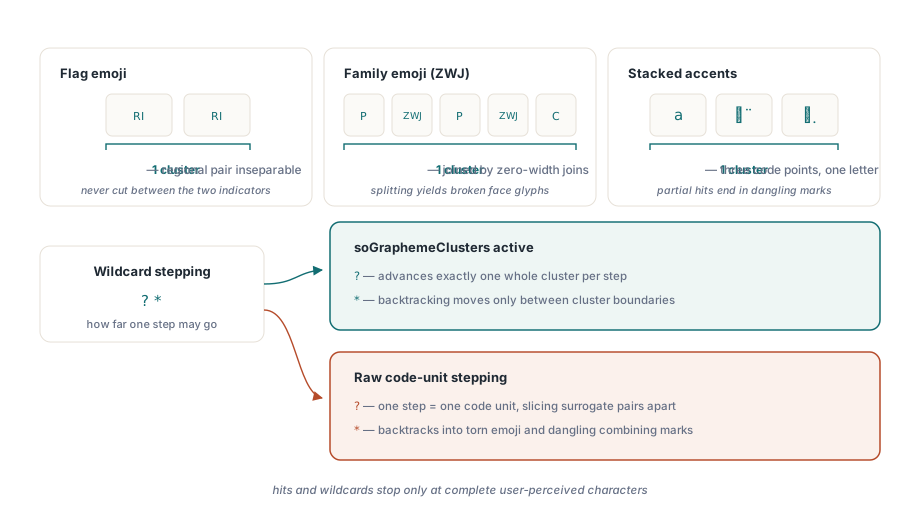
Подстановочные знаки — там, где флаг меняет результаты заметнее всего. Под soCanonicalEquivalent текст страницы сравнивается в NFD, поэтому côté становится c o U+0302 t e U+0301 независимо от того, как файл его хранил. Без soGraphemeClusters ? в c?té поглощает ровно одну кодовую единицу — o — затем ждёт t и находит U+0302. Совпадения нет. С флагом ? продвигается на целый кластер, и откат для * тоже двигается только между границами кластеров:
// "?" шагает на один воспринимаемый пользователем символ, поэтому это находит côté
// независимо от того, хранит ли PDF его предсоставленным или разложенным
Found := Lib.SearchText('c?té',
  [soWildcards, soCanonicalEquivalent, soGraphemeClusters], '', Hits);

// Замена использует те же кластеробезопасные диапазоны, поэтому она никогда
// не режет эмодзи и не оставляет осиротевший акцент
Replaced := Lib.SearchAndReplaceTextInContent('naïve', 'plain',
  [soCanonicalEquivalent, soGraphemeClusters], '1-20');
if Replaced = 0 then
  Writeln(Lib.GetLastUnicodeReplacementDiagnostics)
else
  Lib.SaveToFile('contracts-edited.pdf');
SearchAndReplaceTextInContent переписывает текст внутри потока содержимого страницы и возвращает число заменённых совпадений. Когда возвращает ноль, GetLastUnicodeReplacementDiagnostics говорит почему, например что совпадение не удалось отобразить обратно в содержимое, которое его нарисовало. Другая точка входа, SearchAndReplaceText, принимает тот же набор опций и рисует замену поверх найденного блока
Подбор набора опций под нагрузку
Три комбинации покрывают большинство приложений. Для поискового поля конечного пользователя внутри просмотрщика документов берите soCanonicalEquivalent плюс soDiacriticInsensitive: обе формы кодирования совпадают, как и написания с акцентами и без — то, чего люди ждут после лет веб-поиска. Для юридической или комплаенс-проверки, где ложное срабатывание стоит кому-то дня, берите soCanonicalEquivalent с soCaseSensitive и soWholeWord и оставьте свёртку акцентов выключенной, чтобы эквивалентность оставалась точной, игнорируя лишь то, как файл случайно её закодировал
Для всего, что меняет документ, добавляйте soGraphemeClusters каждый раз. Это единственное место, которое мы не оставили бы на вкус. Поиск, вернувший диапазон короче на одну кодовую единицу, лишь вводит в заблуждение читателя результатов; замена или удаление, использующие тот же диапазон, записывают ошибку в файл, и никто не заметит, пока страница не будет напечатана или извлечена заново. Удаление, обязанное уничтожать содержимое, а не накрывать его, — отдельная тема, раскрытая в статье настоящее редактирование и удаление содержимого
Когда против одного документа идёт несколько запросов, предпочитайте SearchTextBatch. Он вычисляет каждый непустой запрос, пока текстовые блоки страницы резидентны, так что каждая страница извлекается один раз и каждый блок нормализуется один раз, и каждый запрос несёт собственный набор опций:
var
  Queries: array[0..2] of TPDFlibSearchQuery;
  BatchHits: array of TPDFlibSearchBatchHit;
  Count, I: Integer;
begin
  Queries[0].Query := 'Müller';
  Queries[0].Options := [soCanonicalEquivalent, soDiacriticInsensitive];
  Queries[1].Query := '서울';                // хангыль: в файле NFC или чамо
  Queries[1].Options := [soCanonicalEquivalent, soGraphemeClusters];
  Queries[2].Query := 'Nguyễn';
  Queries[2].Options := [soCanonicalEquivalent, soCaseSensitive,
    soWholeWord, soGraphemeClusters];

  SetLength(BatchHits, 2000);
  Count := Min(Lib.SearchTextBatch(Queries, '', BatchHits),
    Length(BatchHits));
  for I := 0 to Count - 1 do
    Writeln(Format('query %d -> page %d',
      [BatchHits[I].QueryIndex, BatchHits[I].Hit.Page]));
end;
Совпадения возвращаются упорядоченными по странице, затем блоку, затем запросу, а QueryIndex — позиция с нуля в переданном вами массиве. SearchTextBatchEach — колбэковая форма для наборов результатов, которые нельзя заранее размерить. Как текстовые блоки извлекаются в первую очередь, описано в статье поиск текста и перечисление элементов страницы
Системы письма, где каноническая эквивалентность не опциональна
Для корейского каноническая эквивалентность решает, найдётся ли имя вообще, ведь предсоставленные слоги и разложенные чамо оба встречаются в реальных документах. Вьетнамский штабелирует тональную метку на гласную, которая уже может нести бревис или циркумфлекс, поэтому его композиционная форма целиком зависит от производителя. Для деванагари, бенгальского и прочих индийских систем письма правила конъюнктов решают, упадёт ли граница совпадения туда, где её узнает читатель. Японский и китайский на стороне поиска сравнительно легки, хотя на стороне вёрстки — нет, как разобрано в статье вертикальное письмо для японского и китайского
Наша рекомендация прямолинейна. Если в корпусе есть хоть один язык, кроме английского, включите soCanonicalEquivalent сперва и выключайте только после замеров на собственных документах и признания стоимости неприемлемой. Провал, который она предотвращает, падает ровно на те имена, которые ваши пользователи ищут чаще всего
Тот же движок с учётом Unicode гоняет поиск, извлечение, замену и редактирование из Delphi, C++Builder и Free Pascal; наборы опций, пакетный API и остальной текстовый инструментарий перечислены на странице продукта PDF Library for Delphi