Извлечь текст страницы - это простая половина задачи. В тот момент, когда пользователь вводит слово в поисковую строку и ожидает, что viewer прыгнет к нему и нарисует вокруг него желтый прямоугольник, вам нужно нечто, чего плоская строка текста дать уже не может: страницу, на которой сидит совпадение, и прямоугольник, который оно занимает в координатах PDF. Строка, склеенная по всей странице, потеряла эту геометрию. Подстроку вы найдете, а вот указать на нее уже не сможете
PDF Library for Delphi - это нативная Object Pascal PDF-библиотека для Delphi и C++Builder, и начиная с v3.78.0 она отвечает именно на этот вопрос. Поверх уже существующего extractor текстовых блоков стоят три query API: SearchText обходит диапазон страниц и возвращает каждое попадание с его страницей и axis-aligned rectangle, EnumPageElements перечисляет все, что есть на одной странице, текстовые блоки и встроенные изображения, а GetTextInAreaEx сообщает rectangle каждого блока внутри области вместо того, чтобы сплющивать их в простой список строк. Ни один из этих API не трогает write path; это чистые read-side дополнения поверх уже существовавшего механизма
Почему геометрия живет в списке text block, а не в funnel
Естественный инстинкт - переиспользовать то, что внутри уже делает GetPageText . Но этот путь идет через временную extraction "funnel", которая создает строку страницы и освобождается еще до возврата результата. К моменту, когда результат оказывается у вас в руках, координаты отдельных block уже исчезли. Они никогда вам не принадлежали
Координаты выживают в другой структуре. ExtractPageTextBlocks(3) возвращает handle списка text block, чьи элементы несут восьмидвойной bounding quad, имя шрифта, размер шрифта и текст блока. После извлечения именно этот handle остается единственным местом, где хранится геометрия. Поэтому все новые query API строятся на нем, а не на funnel. Повторное использование списка block означает, что search, enumeration и region query делят один extraction pass и одно и то же определение того, где именно расположен блок
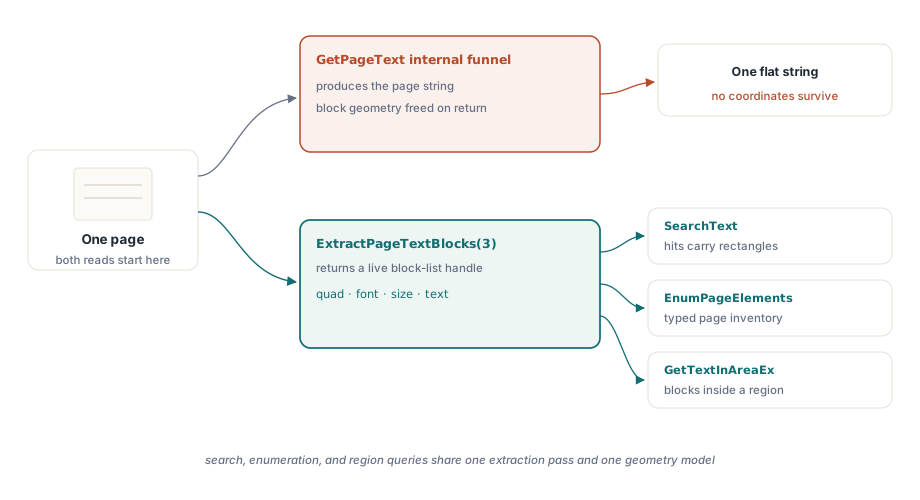
Именно это ограничение и определяет форму SearchText . Для каждой страницы диапазона метод извлекает список block, читает текст каждого блока через GetTextBlockText , сравнивает его с запросом и для совпавших block сводит quad к rectangle. Возвращаемое совпадение представляет собой небольшой record:
type
  TPDFlibSearchHit = record
    Page: Integer;                       // страница совпадения с нумерацией от 1
    Left, Top, Right, Bottom: Double;    // прямоугольник найденного фрагмента, выровненный по осям
    MatchText: WideString;               // текст блока, содержащего запрос
  end;
Массив bound чередует X/Y, а не хранит четыре угла подряд
Именно эта деталь чаще всего кусает первой. GetTextBlockBound(ListID, Index, BoundIndex) принимает BoundIndex от 1 до 8, и эти восемь значений - не "угол 1, угол 2, угол 3, угол 4" с двумя полями в каждой группе, как можно было бы предположить. Это X, Y, X, Y, X, Y, X, Y : нечетные индексы - это координаты X, четные - координаты Y, всего четыре точки. Если сгруппировать их неправильно, прямоугольник получится бессмысленным
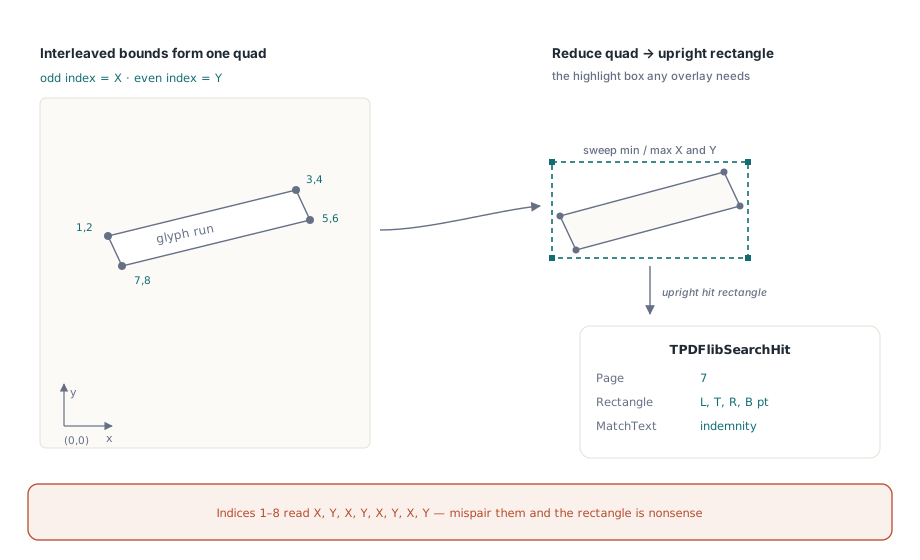
Причина, по которой здесь вообще используется quad, а не простой rectangle, - поворот. Текстовый block, выставленный под углом, действительно имеет четырехточечный bounding polygon, и восемь double описывают его честно. Но для задачи highlight-and-jump почти всегда нужен upright box, поэтому библиотека сводит quad к axis-aligned rectangle, проходя по четырем точкам и вычисляя minimum и maximum по X и Y. Повернутый текст схлопывается в upright box, который его содержит, а именно такой box и нужен highlight overlay:
var
  Pdf: TPDFlib;
  Hits: array[0..255] of TPDFlibSearchHit;
  Found, I: Integer;
begin
  Pdf := TPDFlib.Create;
  try
    Pdf.LoadFromFile('contract.pdf', '');
    // Search pages 1 to 10, case-insensitive, substring match.
    Found := Pdf.SearchText('indemnity', [], '1-10', Hits);
    for I := 0 to Found - 1 do
      if I <= High(Hits) then
        WriteLn(Format('p%d: [%.1f %.1f %.1f %.1f] %s',
          [Hits[I].Page, Hits[I].Left, Hits[I].Top,
           Hits[I].Right, Hits[I].Bottom, Hits[I].MatchText]));
  finally
    Pdf.Free;
  end;
end;
Обратите внимание, что rectangle возвращается в PDF user-space points с началом координат в левом нижнем углу страницы, в той же системе координат, которую вы передаете drawing и annotation вызовам. Это сделано специально: rectangle из search hit можно без каких-либо преобразований отдать в highlight annotation или в команду "прокрути сюда"
Чувствительность к регистру, whole word и отличие для CJK
Второй параметр - это set, составленный из TPDFlibSearchOptions и soCaseSensitive , drawn from soWholeWord . Пустой set [] - самый типичный случай: поиск подстроки без учета регистра. Добавьте soCaseSensitive , чтобы Indemnity и indemnity различались, добавьте soWholeWord , чтобы sign не совпадало внутри signature , или комбинируйте оба флага
Режим whole word требует определения того, что считать word boundary, и здесь правило стоит сформулировать прямо, потому что оно намеренно ASCII-centric. Символ считается частью слова, если это ASCII-буква, ASCII-цифра или underscore, то есть класс [A-Za-z0-9_] , знакомый по правилам идентификаторов. Совпадение квалифицируется как whole-word только тогда, когда символы непосредственно до и после него не являются word character, либо совпадение упирается в край блока
Следствие для не-латинских скриптов важно понимать до отправки multilingual search box. Поскольку иероглифы Han, kana и прочие не-ASCII буквы находятся вне этого класса, любая граница рядом с ними читается как не-словесный край. На практике это означает, что whole-word поиск по CJK ведет себя так, как будто каждая позиция является допустимой word boundary, и флаг фактически вырождается в substring matching. Это документированное ограничение, а не bug, и оно соответствует поведению модели, на которую ориентировалась функция. Если ваш корпус в основном CJK, режим whole-word не даст ту сегментацию, которую дал бы специализированный tokenizer. Планируйте это заранее, а не полагайтесь на него
Одна implementation footnote объясняет целый класс тонких сбоев в других местах: сравнение без учета регистра использует UpperCase на WideString , а не AnsiUpperCase . Ansi-вариант возвращает AnsiString , который не согласуется с WideString , используемым остальным путем, а смешивание двух типов дает и type mismatch, и, что хуже, потерю данных при folding символов за пределами активной code page. Unicode на входе, Unicode на выходе, на всем протяжении пути
Один parser диапазона страниц на всю библиотеку
Третий параметр - это строка диапазона страниц, например "1,3,5-9" . Ничего пользовательского в ее парсинге нет: тот же PLParsePageRangeList , который лежит под PrintPages и под page-copy routines, используется и здесь, поэтому диапазон, который корректно печатает, корректно и ищет. Пустая строка диапазона - это sentinel для "все страницы", и тогда SearchText сам строит полный список
Граница поиска важна и по стоимости. Поиск по десяти страницам внутри документа на тысячу страниц извлекает block только для десяти страниц, а не для всей тысячи, потому что цикл выбирает и извлекает лишь те страницы, которые названы в диапазоне. Если вы уже знаете, что нужный пункт живет в appendix, укажите диапазон сразу и пропустите остальной файл
Внутри и search, и enumeration изменяют selected page по мере итерации, поэтому каждый из них сохраняет выбранную страницу вызывающей стороны при входе и восстанавливает ее в блоке finally . Вызовите SearchText посреди построения страницы, и при возврате текущий выбор будет ровно там, где вы его оставили. Такой save-and-restore контракт замечают именно тогда, когда его нет, поэтому он и реализован
Перечисление всей страницы: текст и изображения в одном списке
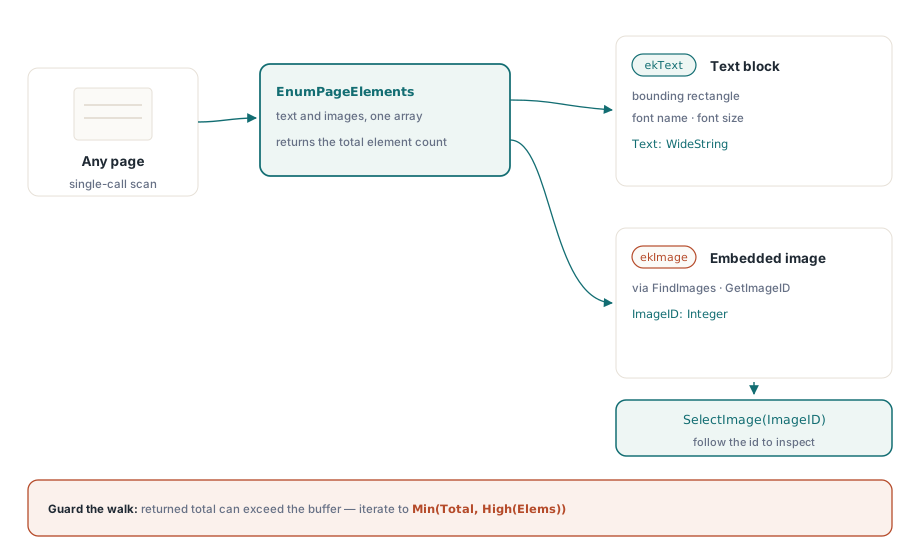
Search отвечает на вопрос "где находится это слово". Вторая половина introspection - это вопрос "что вообще находится на этой странице", и за него отвечает EnumPageElements . Он возвращает один единый список, где каждый элемент является либо text block, либо embedded image, а различаются они по полю Kind :
type
  TPDFlibPageElementKind = (ekText, ekImage);

  TPDFlibPageElement = record
    Kind: TPDFlibPageElementKind;
    Page: Integer;
    Left, Top, Right, Bottom: Double;
    Text: WideString;        // ekText
    FontName: WideString;    // ekText
    FontSize: Double;        // ekText
    ImageID: Integer;        // ekImage; доступен для SelectImage / GetImageID
  end;
Текстовые элементы приходят из того же прохода ExtractPageTextBlocks , поэтому каждый сразу получает свой rectangle, имя шрифта и размер. Элементы image приходят из списка embedded image страницы через FindImages и GetImageID ; ImageID , который они несут, - это handle, который затем передается в SelectImage для дальнейшего анализа изображения. Оба вида попадают в один массив, поэтому один проход по странице видит все ее содержимое
var
  Pdf: TPDFlib;
  Elems: array[0..511] of TPDFlibPageElement;
  Total, I: Integer;
begin
  Pdf := TPDFlib.Create;
  try
    Pdf.LoadFromFile('report.pdf', '');
    Total := Pdf.EnumPageElements(1, Elems);
    for I := 0 to Total - 1 do
      if I <= High(Elems) then
        if Elems[I].Kind = ekText then
          WriteLn(Format('text  %s/%.1f  "%s"',
            [Elems[I].FontName, Elems[I].FontSize, Elems[I].Text]))
        else
          WriteLn(Format('image id=%d', [Elems[I].ImageID]));
  finally
    Pdf.Free;
  end;
end;
Здесь есть соглашение о подсчете, которое следует остальной библиотеке, и его нужно уважать, иначе вы полезете в неинициализированную память. Возвращаемое значение - это общее число элементов, которое может быть больше массива, который вы передали. Функция заполняет только столько слотов, сколько помещается, и продолжает считать дальше, в точности как enumeration signature. Поэтому guard всегда одинаков: ограничивайте цикл меньшим из двух значений, возвращенного count и High(array) , и никогда не итерируйтесь до count вслепую. Примеры выше показывают проверку I <= High(...) именно по этой причине. Если возвращенное значение больше буфера, выделите больший массив и вызовите функцию еще раз
Если вы уже пользовались низкоуровневыми вызовами text block этой библиотеки, то это typed и geometry-aware слой поверх них; underlying extraction здесь тот же самый, что и в Delphi PDF text, image, and font extraction with PDF Library for Delphi . А если ваша цель не "где находится этот текст", а "как структурирован этот документ для assistive technology", то параллельная read-side история - это tagged-PDF structure tree , которое открывает логический порядок чтения, а не физический layout block
Запросы по области, когда вы уже знаете, где искать
Иногда у вас вообще нет search term, зато есть rectangle. Шаблон формы всегда кладет номер счета в правый верхний угол, или сканированный layout резервирует фиксированную полосу под таблицу. GetTextInAreaEx обслуживает именно этот сценарий. Это вариант GetTextInArea с сохранением bounds: старый вызов отдавал плоский список string внутри области, а новый возвращает text каждого сохраненного block вместе с его rectangle, так что вы узнаете не только, что находится в box, но и где именно внутри нее лежит каждая строка
var
  Pdf: TPDFlib;
  Hits: array[0..63] of TPDFlibSearchHit;
  Found, I: Integer;
begin
  Pdf := TPDFlib.Create;
  try
    Pdf.LoadFromFile('invoice.pdf', '');
    Pdf.SelectPage(1);
    // Left, Top, Width, Height в точках PDF на выбранной странице
    Found := Pdf.GetTextInAreaEx(360, 720, 180, 60, Hits);
    for I := 0 to Found - 1 do
      if I <= High(Hits) then
        WriteLn(Hits[I].MatchText);
  finally
    Pdf.Free;
  end;
end;
Здесь нужно держать в голове две вещи. GetTextInAreaEx работает на текущей selected page, поэтому сначала вызывайте SelectPage ; в отличие от SearchText , этот вызов не принимает диапазон. И block сохраняется, когда он пересекает query rectangle, а не только когда полностью в него попадает, поэтому строка, которая заходит за границу, все равно пройдет. Для вручную нарисованного selection box это обычно именно то, что нужно, но если вам требуется строгая вложенность, вы теперь можете сами отфильтровать возвращенные rectangle, потому что библиотека их уже дает
Как применять это на практике
Красная нить всех трех вызовов состоит в том, что геометрия больше не является чем-то, что вы восстанавливаете задним числом. Search hit знает свою страницу и свой box. Page element знает свой rectangle и, для текста, свой шрифт. Region query сообщает, где падает каждая строка. Этого достаточно, чтобы построить настоящий find-and-highlight, click-to-locate индекс или extractor, понимающий layout, не уходя ниже публичного API и не собирая text-extraction pipeline вручную
Эти query API входят в PDF Library for Delphi Delphi PDF Library , вместе с полным слоем text-block extraction, на котором они построены, и остальной read-side поверхностью introspection для Delphi и C++Builder