Решают полпункта. В отчёте с основным текстом 10 пунктов заголовок раздела, набранный 11-пунктовым жирным, конвертируется в Markdown как обычный абзац, а 12-пунктовая подпись на обложке обычного начертания возвращается как ### Quarterly figures. Это выглядит навыворот, пока не вспомнишь, что страница PDF на самом деле хранит: глифы на координатах, имя шрифта и размер. Ничто на странице не говорит "заголовок". Каждый заголовок, который выдаёт конвертер, — догадка, построенная из тех трёх фактов, и у догадки есть пороги
Почему на странице PDF нет абзацев для экспорта
Страница PDF содержит операторы показа текста, а не абзацы. Каждый оператор ставит прогон глифов на позицию, в том порядке, в каком их случилось выпустить породившему приложению, и ISO 32000-1 не обязывает производителя сообщать, что два прогона принадлежат одному предложению, не говоря уже об одном пункте списка или ячейке таблицы. Формат описывает печатную страницу точно — и добирается туда, выбросив структуру, которая эту страницу породила
Поэтому каждый конвертер заново строит то, что генератор выбросил. Строки выходят из общих базовых линий и вертикальных интервалов. Границы абзацев — из смен интервалов и отступов. Список — прогон блоков, начинающихся с маркера или числового шаблона. Таблица — сетка текстовых блоков, чьи края выстраиваются по строкам и столбцам. На документах, следующих обычным типографским привычкам, это работает хорошо; на брошюре, свёрстанной ради визуального эффекта, зацепиться почти не за что
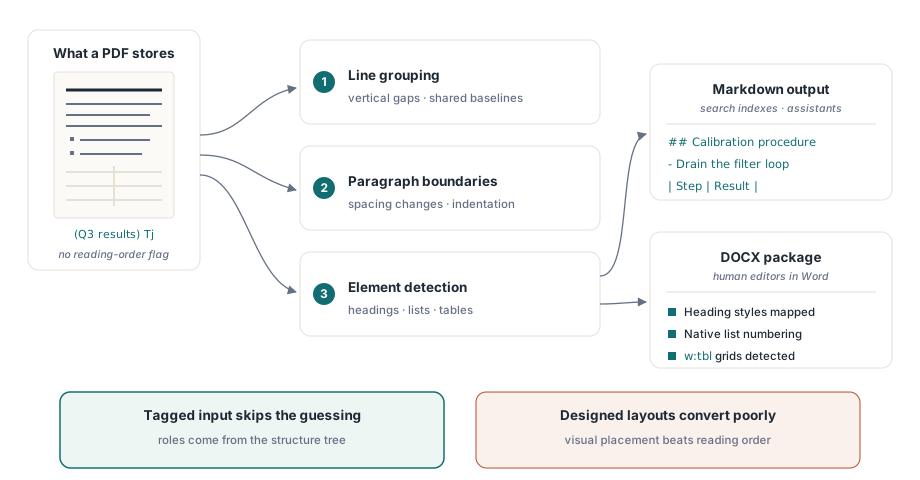
Тегированные PDF — большое исключение. Когда документ несёт дерево структуры, роли абзаца, заголовка, списка и таблицы записаны производителем, а не угаданы потом, — поэтому работа, описанная в статье структура доступности тегированного PDF, окупается ещё и качеством конвертации. Если вы контролируете производителя, тегирование вывода — самое дешёвое, что вы можете сделать для тех, кто будет конвертировать позже
Откуда берутся уровни заголовков
PDF Library for Delphi решает уровни заголовков двумя способами, в зависимости от входа. На тегированной странице блок, чья структурная роль — H1–H6, сохраняет тот уровень, а H или Title становится уровнем 1. На нетегированной странице экспорт откатывается к размеру шрифта относительно основного текста страницы и рассматривает только однострочные абзацы в 200 символов или меньше
Правилу размера нужны и отношение, и абсолютный зазор, отсчитанные от доминирующего размера основного текста:
| Вывод Markdown | Крупнейший текст в строке | При основном тексте 10 pt |
|---|---|---|
# | не менее 1.6 размера основного текста и не менее чем на 4 pt крупнее | 16 pt и выше |
## | не менее 1.35 и не менее чем на 2.5 pt крупнее | 13.5 pt и выше |
### | не менее 1.15 и не менее чем на 1.25 pt крупнее | 11.5 pt и выше |
Это объясняет пример из начала. 11-пунктовый жирный заголовок над текстом 10 пунктов не дотягивает до третьей ступени полпункта, и начертание в уровне не участвует. Подпись на обложке в 12 пунктов проходит. Абсолютный зазор существует ради мелких основных размеров: на тексте 6 пунктов, размера сноски, одно отношение повысило бы строку в 7 пунктов до заголовка, и требование дополнительных 1.25 pt это останавливает
Мы считаем этот размен правильным. Жирное слишком часто встречается внутри основного текста (вводные фразы, определяемые термины, итоги в строке сводки), чтобы быть надёжным сигналом заголовка само по себе, и конвертер, повышающий каждую жирную строку, производит Markdown с десятками ложных разделов. Пропустить несколько заголовков только из жирного стоит дешевле. Если ваши документы опираются на заголовки жирным основного размера, надёжный фикс — выше по потоку: тегируйте их или поднимите размер заголовка на полтора пункта
Жирное и курсивное в выводе читаются из имени шрифта. Прогон, чьё имя шрифта содержит Bold, Black или Demi, становится **bold**; Italic или Oblique становится *italic*. Производители, режущие шрифты под непрозрачными именами вроде F3 или имитирующие жирное обводкой обычных глифов, не дают экспорту ничего читать, и тот текст приходит неоформленным
Экспорт Markdown для конвейеров поиска
Путь Markdown — то, к чему тянуться, когда назначение — текстовый конвейер: сайт документации, поисковый индекс, нарезанный корпус для ассистента. ExportPageMarkdown возвращает одну страницу как WideString, ExportDocumentMarkdown возвращает диапазон страниц, а SaveMarkdownToFile и SaveMarkdownToStream пишут тот же текст как UTF-8 без метки порядка байтов. Отсутствие BOM намеренно: немало генераторов статических сайтов и diff-инструментов трактуют его как содержимое
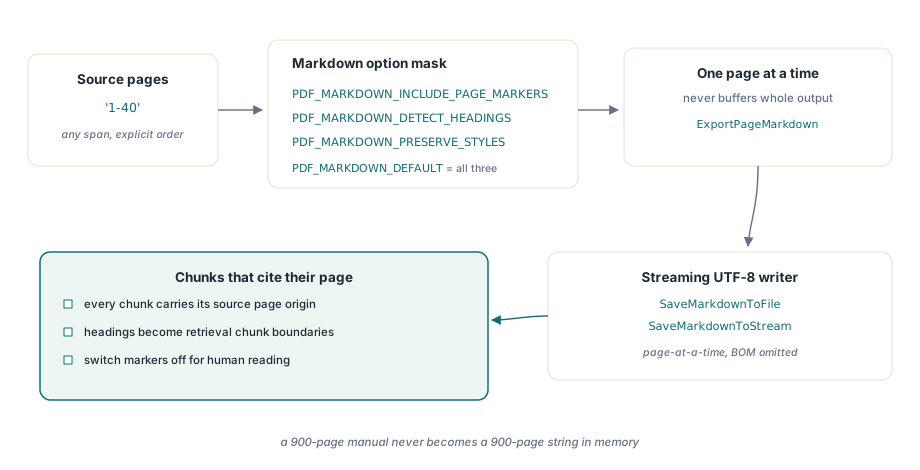
Опции — битовая маска: PDF_MARKDOWN_INCLUDE_PAGE_MARKERS (1), PDF_MARKDOWN_DETECT_HEADINGS (2) и PDF_MARKDOWN_PRESERVE_STYLES (4), где PDF_MARKDOWN_DEFAULT объединяет все три. Вторая, документная настройка управляет самим анализом: SetStructuredTextOptions принимает флаги PDF_STRUCTURED_*, и её умолчание детектирует колонки, детектирует бегущие колонтитулы и соединяет таблицы, продолжающиеся через разрыв страницы
uses
  SysUtils, PDFlibrary;

var
  Pdf: TPDFlib;
  Exported: Integer;
begin
  Pdf := TPDFlib.Create;
  try
    if Pdf.LoadFromFile('handbook.pdf', '') = 0 then
      raise Exception.Create('Cannot open handbook.pdf');

    // Детекция бегущих колонтитулов включена по умолчанию;
    // добавление EXCLUDE_FURNITURE также убирает их из вывода
    Pdf.SetStructuredTextOptions(PDF_STRUCTURED_ADVANCED_DEFAULT or
      PDF_STRUCTURED_EXCLUDE_FURNITURE);

    // Маркеры страниц и заголовки, но без выделения ** и *
    Exported := Pdf.SaveMarkdownToFile('1-40',
      PDF_MARKDOWN_INCLUDE_PAGE_MARKERS or PDF_MARKDOWN_DETECT_HEADINGS,
      'handbook.md');
    if Exported = 0 then
      raise Exception.CreateFmt('Markdown export failed, error %d',
        [Pdf.LastErrorCode]);

    // JSON с записью на страницу: readingSource — tagged, mixed,
    // geometric или geometric-columns
    Writeln(Pdf.GetLastStructuredTextDiagnostics);
  finally
    Pdf.Free;
  end;
end;
Для корпуса поиска мы отбрасываем PDF_MARKDOWN_PRESERVE_STYLES. Выделение применяется прогон за прогоном, поэтому жирная фраза, набранная несколькими прогонами, выходит как **Net** **revenue** — на экране читается нормально, а в каждое вложение добавляет шум. Маркеры страниц — обратный случай: оставляйте. Каждый маркер — HTML-комментарий, <!-- page: 12 -->, невидимый при рендеринге Markdown и тривиально разбираемый при нарезке на чанки, поэтому извлечённый отрывок может процитировать страницу, откуда пришёл. Когда таблица продолжается с предыдущей страницы, маркер новой страницы опускается, чтобы pipe-таблица осталась одной таблицей
Два поведения подлавливают тех, кто экспортирует страницу за страницей в цикле. Во-первых, бегущие колонтитулы распознаются по повторению: абзац в верхней или нижней 12 процентах страницы считается мебелью, когда совпадающий текст сидит в той же полосе на другой странице того же экспорта, причём цифры нормализуются, так что "Page 3 of 40" совпадает с "Page 4 of 40". Одностраничный вызов не имеет другой страницы для сравнения, поэтому нетегированный колонтитул остаётся в тексте. Во-вторых, картинки в Markdown встроены инлайн как data: URI, что держит файл самодостаточным и означает, что страница с большой фотографией может добавить сотни килобайтов base64. Если у вашего чанкера есть лимит размера, срезайте строки, начинающиеся с 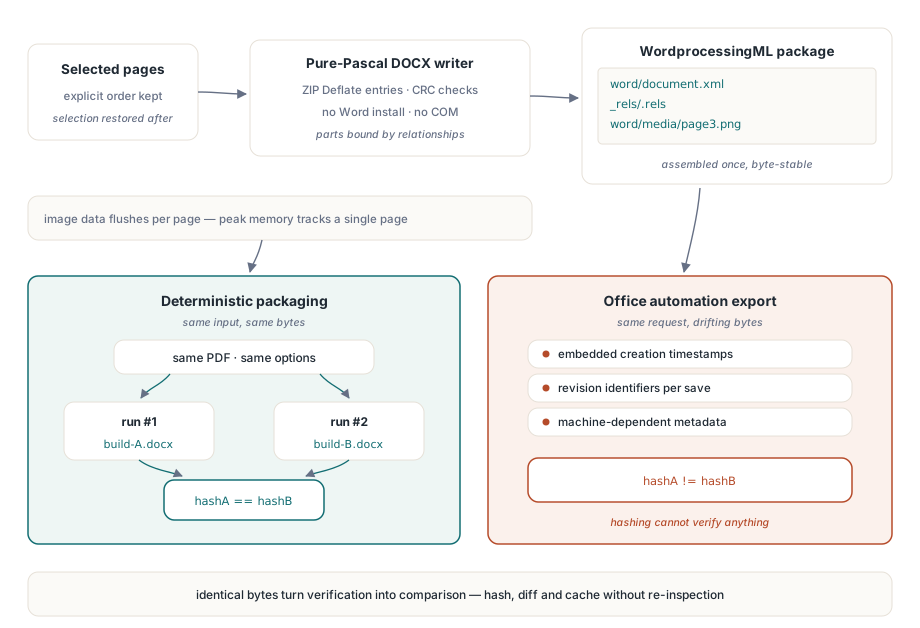
Этот результат держится на двух решениях. Каждая запись ZIP несёт одну и ту же фиксированную DOS-дату, 1 января 1980 года, вместо времени прогона, а часть core properties не имеет дат создания или изменения. Каждая запись сжимается сырым Deflate, только когда это реально делает её меньше, поэтому PNG-медиа, уже сжатая, хранится как есть. Первый пункт можно подтвердить через unzip -v handbook.docx: каждая строка показывает одну и ту же дату
Автоматизация Office такого не даст. Сохранение через Word штампует текущее время в метаданные пакета и заголовки ZIP, поэтому один документ, конвертированный дважды, различается так, что хеш бессмыслен. За тем же рассуждением стоят стабильные файловые идентификаторы из статьи детерминированные PDF ID для воспроизводимых сборок: когда вывод воспроизводим, проверка становится сравнением
Какие входы конвертируются хорошо, а какие не будут никогда
Качество конвертации сильнее зависит от входа, чем от конвертера, и стоит сказать пользователям об этом заранее. Тегированные PDF и чисто сгенерированные деловые документы (счета, отчёты, договоры) конвертируются хорошо: заголовки приземляются заголовками, таблицы выживают, списки перенумеровываются в Word. Двухколоночные академические вёрстки проходят в правильном порядке чтения, когда геометрия колонок регулярна, и диагностика сообщит для тех страниц geometric-columns. Таблицы, разрывающиеся между страницами, сшиваются выводом — проверяйте их выборочно. Тяжело свёрстанный маркетинговый материал, где текст размещён ради эффекта, а не в порядке чтения, оставляет любому конвертеру мало что восстановить; рассчитывайте дорабатывать результат руками
Отсканированные документы — отдельный случай. Страница, являющаяся одним большим изображением, не содержит текстовых объектов, поэтому экспортировать нечего, пока не появится текстовый слой, и запуск OCR — предпосылка для обоих форматов. Прежде чем браться за большой пакет, выберите дюжину показательных файлов и перечислите, что содержат их страницы, как описано в статье поиск текста и перечисление элементов страницы; страница с картинками и без текстовых прогонов расскажет больше за секунду, чем чтение конвертированного вывода
Выбирайте формат по тому, что случится дальше. Markdown подходит машинам и конвейерам: заголовки становятся границами чанков, таблицы остаются читаемыми как pipe-таблицы, а маркеры страниц дают каждому чанку цитату. DOCX подходит людям, которым надо менять документ: они хотят обратно редактируемый файл в Word, с настоящими списками и настоящими таблицами, и один лишь текст этого не даёт
PDF Library for Delphi поставляется для Delphi, C++Builder и Lazarus, с редакциями DLL и ActiveX, открывающими те же вызовы экспорта Markdown и DOCX хостам C#, C++ и скриптов. Справочник по каждому флагу опций и пробная загрузка — на странице продукта PDF Library for Delphi