Вот ошибка, которую рукописный читатель JBIG2 делает на первом необычном файле. Он разбирает заголовок файла, разбирает заголовок первого сегмента, читает четырехбайтовую длину данных и принимает столько байтов за тело сегмента. На большинстве .jb2-файлов это ровно правильно. На файле, у которого бит 0 байта флагов сброшен, те «телесные» байты — на самом деле второй, третий и четвертый заголовки сегментов, и арифметический декодер превращает их в битмап из шума или убегает за конец буфера. Файл не сломан. Он использует организацию произвольного доступа из ITU-T T.88 Annex D.2, где сначала идут все заголовки сегментов, а потом все данные сегментов, в том же порядке
Файлы произвольного доступа редки. Они выходят из архивных и документно-имиджевых систем, которые хотят, чтобы читатель увидел каждую страницу и каждую словарную зависимость, прежде чем тронуть сжатый байт. Если задание конвертации мешает файлы из такого источника с обычными сканами, один файл произвольного доступа может сидеть посреди батча, иначе полностью последовательного. Декодер, читающий их, — тот же нативный Pascal-декодер, что обрабатывает пользовательские таблицы Хаффмана JBIG2 и канонические префиксные коды, так что кодирующая сторона не изменилась; отличается только порядок, в котором находятся сегменты
Три раскладки файла за одним байтом флагов
PDF Library for Delphi читает автономные JBIG2-файлы через TPLJBIG2Decoder в модуле PDFlibJBIG2, и декодер сам вычисляет раскладку из заголовка файла. T.88 Annex D позволяет раскладывать одни и те же сегменты тремя способами: последовательная (D.1) кладет каждый заголовок прямо перед его данными, произвольный доступ (D.2) кладет все заголовки впереди и все данные после них, а встроенная (D.3) — беззаголовочная форма, используемая внутри других контейнеров. Автономный файл начинается с восьмибайтового идентификатора 97 4A 42 32 0D 0A 1A 0A, затем один байт флагов, затем четырехбайтовое число страниц, если флаги не говорят, что счетчик неизвестен
Бит 0 того байта флагов выбирает организацию: 1 значит последовательная, 0 значит произвольный доступ. Бит 1 выставлен — число страниц неизвестно и четырехбайтовый счетчик отсутствует, так что первый заголовок сегмента стартует с байта 9 вместо байта 13. Биты 2–7 зарезервированы; декодер принимает файлы, которые их выставляют, вместо отвержения, потому что блуждающий зарезервированный бит ничего не говорит о том, читаемы ли сами сегменты
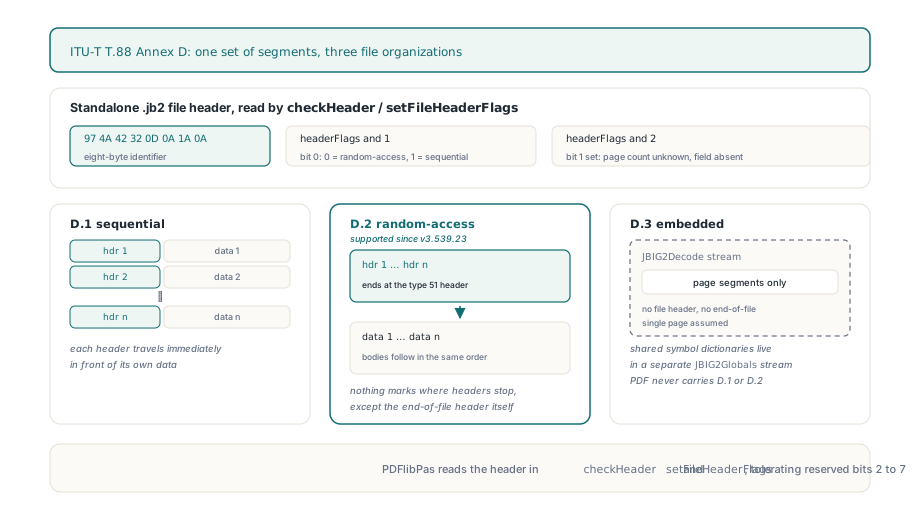
Сам PDF никогда не несет раскладку произвольного доступа. Поток изображения JBIG2Decode, описанный в ISO 32000-1 §7.4.7, держит только сегменты страниц во встроенной форме, с общими словарями символов, вынесенными в отдельный поток JBIG2Globals, и без заголовка файла, end-of-page или end-of-file сегментов. Когда декодер не находит восьмибайтовый идентификатор, он трактует вход как поток ровно такого сорта: последовательный, одна страница. В другую сторону, когда PDF Library for Delphi экспортирует изображение JBIG2Decode как нативный .jb2-файл, она пишет байт флагов $03 (последовательная, число страниц неизвестно) и дописывает заголовок end-of-file сегмента. Так что произвольный доступ приходит только снаружи — как автономный файл, отданный TPLJBIG2Decoder напрямую, обычно по пути конвертации или пережатия для PDF с помощью бэкендов JBIG2-энкодера в PDFlibPas
Почему нельзя читать файл произвольного доступа в порядке файла?
Потому что ничто в байтовом потоке не отмечает, где кончается блок заголовков и начинается блок данных, кроме самого заголовка end-of-file сегмента (тип 51). Заголовки сегментов JBIG2 не имеют фиксированного размера. Число ссылаемых сегментов — либо трехбитная короткая форма, либо длинная форма с битмапом удержания вслед за ней; каждый ссылаемый номер сегмента занимает один, два или четыре байта в зависимости от того, насколько велик собственный номер текущего сегмента; поле ассоциации страницы — один байт или четыре. Читатель обязан разобрать каждое поле заголовка, просто чтобы узнать, где начинается следующий
Последовательный читатель, идущий по файлу по порядку, берет первый заголовок правильно и все после него — неправильно. Хуже: он может не заметить какое-то время, потому что декодер generic region, накормленный байтами заголовков, производит пиксели, а не ошибку, пока какая-нибудь поздняя проверка длины или ссылок наконец не сработает. Наш взгляд: декодер, который не индексирует заголовки сначала, должен отказывать файлам произвольного доступа outright. Ясное отвержение стоит одного файла в батче; правдоподобный, но неверный битмап может попасть в архив и остаться там
Индексация каждого заголовка до первого тела
Когда байт флагов говорит «произвольный доступ», PDF Library for Delphi делает один проход по блоку заголовков, прежде чем декодировать что-либо. Каждый заголовок разбирается полностью и затем выбрасывается; единственное, что сохраняется, — его байтовое смещение в файле. Сжатые данные никогда не копируются во второй перемешанный буфер, что имеет значение на больших архивных сканах, где блок данных может быть большей частью файла. Проход останавливается на первом заголовке end-of-file, и в этот момент позиция чтения сидит на первом байте данных первого сегмента
У файла произвольного доступа меньше избыточности, чем у последовательного, поэтому предсканирование строгое. Оно отвергает файл, когда:
- заголовок обрезан концом буфера — репортится как
JBIG2 truncated random-access header at byte Nсо смещением, где тот заголовок начался - номера сегментов не строго возрастают (сравниваются как беззнаковые), потому что два заголовка, заявляющие один номер, делают список ссылаемых позднего региона двусмысленным
- длина данных несет выставленный старший бит, включая маркер «неизвестной длины»
0xFFFFFFFF; в этой раскладке нет другого способа найти, где начинается следующее тело, так что декодер отказывает ей сразу вместо сканирования вперед в поисках концевого маркера - заголовок end-of-file заявляет хоть какие-то данные или вообще не появляется (
JBIG2 random-access file is missing its end-of-file header) - заявленные длины в сумме дают больше оставшихся байтов или меньше
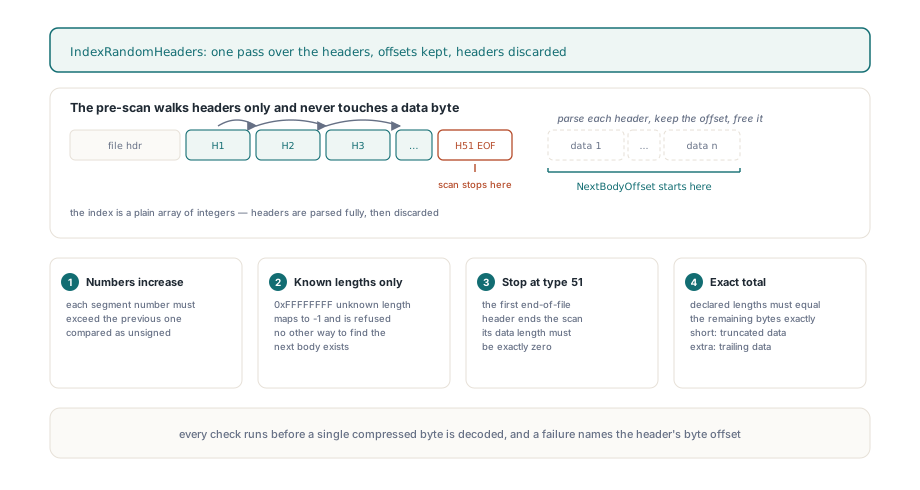
Последнее правило — то, о которое все спотыкаются. Один лишний байт после финального тела отказывает с JBIG2 trailing random-access data. Рядом с последовательным путем это выглядит жестко, где декодирование просто останавливается на сегменте end-of-file, а все после него игнорируется. Асимметрия имеет причину. В последовательной раскладке каждый заголовок сидит рядом со своими данными, так что мусор в конце не мог ничего сдвинуть. В раскладке произвольного доступа заголовки — единственная карта блока данных, и если длины не сходятся, декодер не отличит безобидный паддинг от байта, потерянного или добавленного намного раньше, сдвинувшего все тела после него
Почему цикл со счетчиком байтов теряет последний end-of-page сегмент?
Цикл «пока есть байты» кончается слишком рано на файле произвольного доступа, потому что данные кончаются раньше индекса заголовков. Сегменты end-of-page (тип 49) и end-of-file несут ноль байтов данных и обычно приходят последними. Когда финальное тело региона потреблено, позиция чтения — ровно в конце буфера; цикл со счетчиком байтов выходит там, и нулевой end-of-page сегмент никогда не диспетчеризуется, что оставляет страницу незавершенной
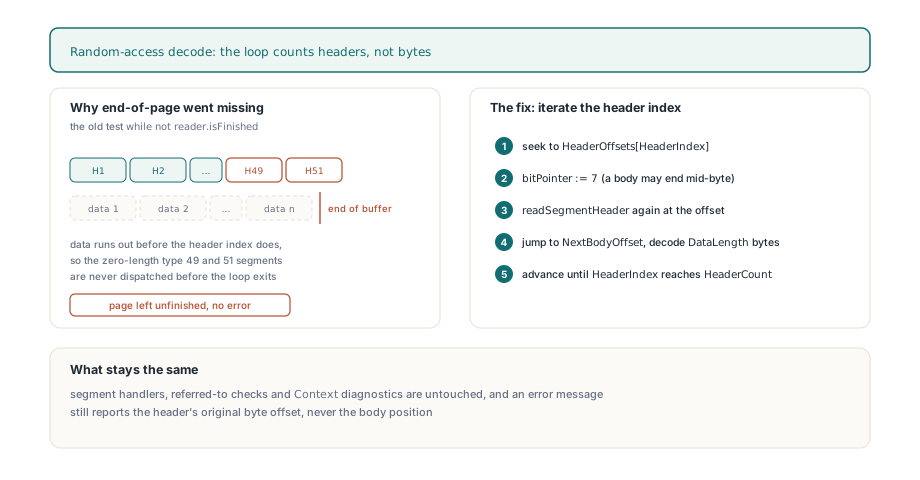
Так что для файлов произвольного доступа декодер считает заголовки, а не байты. Каждый шаг прыгает назад к следующему индексированному заголовку, выравнивается на границу байта (арифметически закодированное тело может кончиться посреди байта), разбирает заголовок снова, затем прыгает вперед к месту, где начинается следующее тело, и продвигается за него на заявленную длину. Тело, чей декодер закончил раньше, пропускается до заявленного конца; читающее дальше — отвергается. Оттуда сегмент идет через те же обработчики и проверки ссылок, что в последовательном файле. Ошибки, поднятые при декодировании тела, несут исходную позицию заголовка в форме JBIG2 segment N (type T) at byte B: ..., так что смещение в LastError указывает на то, что можно найти в hex-редакторе
Загрузка файла .jb2 произвольного доступа в Delphi
Код приложения не меняется вместе с организацией. TPLJBIG2Decoder.LoadFromByteArray распознает заголовок файла и раскладку, возвращает False на любом отвергнутом входе с причиной в LastError и выставляет декодированную страницу через Width, Height и GetScanline, который заполняет один байт на пиксель с 1 для черного
uses
  SysUtils, Classes, PDFlibJBIG2;

function ReadJb2(const FileName: string): TJBIG2ByteArray;
var
  FS: TFileStream;
begin
  FS := TFileStream.Create(FileName, fmOpenRead or fmShareDenyWrite);
  try
    SetLength(Result, FS.Size);
    if Length(Result) > 0 then
      FS.ReadBuffer(Result[0], Length(Result));
  finally
    FS.Free;
  end;
end;

function CountBlackPixels(const FileName: string): Integer;
var
  Decoder: TPLJBIG2Decoder;
  Row: TJBIG2ByteArray;
  X, Y: Integer;
begin
  Result := 0;
  Decoder := TPLJBIG2Decoder.Create;
  try
    // Последовательные и произвольнодоступные автономные файлы берут тот же вызов
    if not Decoder.LoadFromByteArray(ReadJb2(FileName)) then
      raise Exception.Create('JBIG2 rejected: ' + Decoder.LastError);
    for Y := 0 to Decoder.Height - 1 do
      if Decoder.GetScanline(Y, Row) then
        for X := 0 to Decoder.Width - 1 do
          if Row[X] = 1 then
            Inc(Result);
  finally
    Decoder.Free;
  end;
end;
Если хотите знать, какую раскладку использует файл — для журнала или для сортировки корпуса перед прогоном конвертации, — прочитайте байт флагов сами. Библиотека не выставляет распознанную организацию наружу, а девяти байтов достаточно. Хелпер ниже — то, что стоит добавить в собственный код; он просто пересказывает правила заголовка T.88:
type
  TJb2Layout = (jlNoFileHeader, jlSequential, jlRandomAccess);

// Ваш собственный помощник, не часть PDFlibJBIG2: классифицирует буфер по его файловому заголовку T.88
function DetectJb2Layout(const Data: TJBIG2ByteArray;
  out PageCountKnown: Boolean): TJb2Layout;
const
  Signature: array[0..7] of Byte = ($97, $4A, $42, $32, $0D, $0A, $1A, $0A);
var
  I: Integer;
begin
  Result := jlNoFileHeader;          // например, встроенный поток, вынутый из PDF
  PageCountKnown := False;
  if Length(Data) < 9 then
    Exit;
  for I := 0 to 7 do
    if Data[I] <> Signature[I] then
      Exit;
  PageCountKnown := (Data[8] and 2) = 0;   // бит 1 выставлен: четырехбайтового числа страниц нет
  if (Data[8] and 1) = 0 then
    Result := jlRandomAccess
  else
    Result := jlSequential;
end;
Батч-задания: паддированные буферы и отвергнутые файлы
Правило хвостовых данных — то место, где батч-код обычно идет не так, и когда файл, открывающийся в другом месте, отвергается этим способом, смотрите на буфер раньше, чем на файл. .jb2, вынутый из BLOB-колонки базы данных, из фиксированного по размеру сетевого чтения или из формата-контейнера с выравнивающим паддингом, может прийти с несколькими нулевыми байтами после реального конца. Последовательный файл на это плюет. Файл произвольного доступа с тем же паддингом отказывает с JBIG2 trailing random-access data, как и буфер, обрезанный на несколько байтов, который отказывает как усеченный. Передавайте ровно байты файла, размером из реальной длины источника, никогда из размера чанка или емкости
Отвергнутый файл также не оставляет ничего позади. LoadFromByteArray сбрасывает Width, Height и сканлайны до начала декодирования, так что провалившийся вызов репортит нулевые размеры вместо страницы предыдущего файла, и тот же экземпляр декодера может сразу идти к следующему файлу:
procedure DecodeBatch(const Files, Log, Quarantine: TStrings);
var
  Decoder: TPLJBIG2Decoder;
  I: Integer;
begin
  Decoder := TPLJBIG2Decoder.Create;
  try
    for I := 0 to Files.Count - 1 do
      if Decoder.LoadFromByteArray(ReadJb2(Files[I])) then
        Log.Add(Format('%s: %d x %d', [Files[I], Decoder.Width, Decoder.Height]))
      else
      begin
        // Width и Height здесь 0; от предыдущего файла не выживает ничего
        Log.Add(Files[I] + ': ' + Decoder.LastError);
        if Pos('trailing random-access data', Decoder.LastError) > 0 then
          Quarantine.Add(Files[I]);   // проверьте, как байты хранились, прежде чем винить файл
      end;
  finally
    Decoder.Free;
  end;
end;
Проверить это в собственном конвейере можно без редких образцов. Переорганизуйте последовательный .jb2 в раскладку произвольного доступа, сохранив каждый заголовок и каждый сжатый байт, передвиньте заголовки end-of-page и end-of-file в конец блока заголовков — и декодированные пиксели обязаны совпасть с последовательным оригиналом в точности, как с полем числа страниц, так и без него. Затем скормите ему каждый усеченный префикс, дублированный номер сегмента, один лишний хвостовой байт и длину 0xFFFFFFFF; каждый должен вернуть False с Width и Height на нуле
Что декодер возвращает и чего он ожидает
Произвольный доступ здесь — свойство раскладки файла. TPLJBIG2Decoder возвращает битмап первой страницы, какую бы организацию файл ни использовал, а Width и Height описывают ту страницу. Каждый сегмент обязан заявлять длину своих данных; T.88 позволяет immediate generic region использовать маркер 0xFFFFFFFF, и декодер отвергает тот маркер в обеих раскладках с unknown or oversized segment length is not supported. Длины префиксов пользовательского Хаффмана и счетчики записей таблиц ограничены так же, как в последовательных файлах
Декодирование JBIG2 — одна стадия более длинного пути изображений, покрывающего еще извлечение изображений PDF, пережатие и JBIG2-кодирование; страница продукта PDF Library for Delphi покрывает остальное того конвейера и поддерживаемые форматы изображений