Высыпьте сегмент JBIG2 Tables (тип 53) побайтно, и первый сюрприз — то, чего в нём нет: сами коды Хаффмана. Вы получаете байт флагов, две границы и серию маленьких чисел, и эти числа — длины кодов. Кодировщик и декодер оба восстанавливают реальные битовые шаблоны из длин по процедуре из ITU-T T.88 Annex B.3. Восстановите их в чуть другом порядке — и вы всё ещё получите валидный префиксный код, каждый шаблон всё ещё декодируется, и каждое значение выходит прицепленным не к тому шаблону
На странице, закодированной символьными ID Хаффмана с таблицами от кодировщика, такое несовпадение выглядит как плохой скан: глифы на пару пикселей в стороне, символы, собранные из не тех символов, или правдоподобные числа, пока ширина не выйдет за диапазон несколькими сегментами позже. Большинство JBIG2 в PDF-файлах — арифметическое, и большинство хаффмановского JBIG2 держится стандартных таблиц B.1–B.15. Файлы со своими таблицами редки, и они обычно нагружают разом парсер таблиц, хаффмановское уточнение и несжатые коллективные битмапы
Что сегмент Tables несёт на самом деле
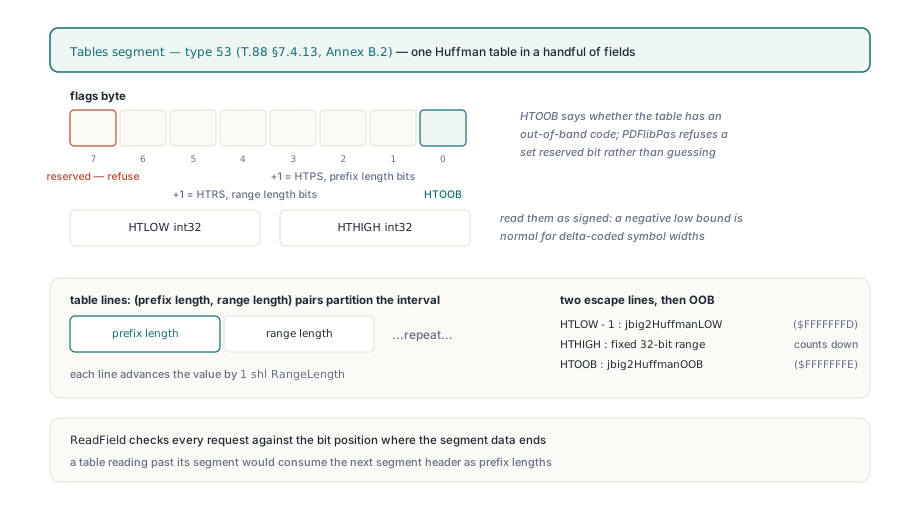
Сегмент Tables описывает ровно одну таблицу Хаффмана. T.88 §7.4.13 и Annex B.2 раскладывают её как один байт флагов, знаковый 32-битный HTLOW, знаковый 32-битный HTHIGH и затем пары (длина префикса, длина диапазона), которые выстилают интервал от HTLOW до HTHIGH. Бит 0 флагов — HTOOB, он говорит, есть ли у таблицы out-of-band код. Биты 1–3 плюс один дают HTPS — ширину каждого поля длины префикса. Биты 4–6 плюс один дают HTRS — ширину каждого поля длины диапазона. Бит 7 зарезервирован
На границах обычно падает написанный вручную парсер. Прочтите HTLOW как беззнаковый — и таблица, начинающаяся с −2, что обычное дело для дельта-кодированных ширин и высот символов, внезапно заявляет о старте чуть ниже 4.3 миллиарда. PDF Library for Delphi читает обе границы как знаковые, отвергает таблицу, у которой HTLOW не меньше HTHIGH или длина диапазона превышает 32, и сверяет каждое прочитанное поле с битом, где объявленные данные сегмента кончаются. Последняя проверка важнее, чем звучит: таблица, читающая за своим сегментом, проглатывает заголовок следующего сегмента как длины префиксов и разбирается в полную бессмыслицу. Установленный бит 7 валит разбор с сообщением reserved custom Huffman table flag. Мы предпочитаем этот отказ догадке, потому что угаданная таблица даёт неправильные пиксели, которые никто не сможет отследить до причины
После регулярных строк идут эскейп-строки Annex B.2. Нижняя строка диапазона стартует с HTLOW минус один и отсчитывает вниз 32-битным смещением, верхняя строка диапазона стартует с HTHIGH с 32-битным диапазоном, а out-of-band строка существует только при установленном HTOOB. Эти строки несут те же маркеры, что встроенные стандартные таблицы, поэтому своя таблица и Table B.6 проходят через один цикл декодирования. Своя таблица может держать до 65536 строк
Почему префиксные коды нужно присваивать в порядке строк таблицы?
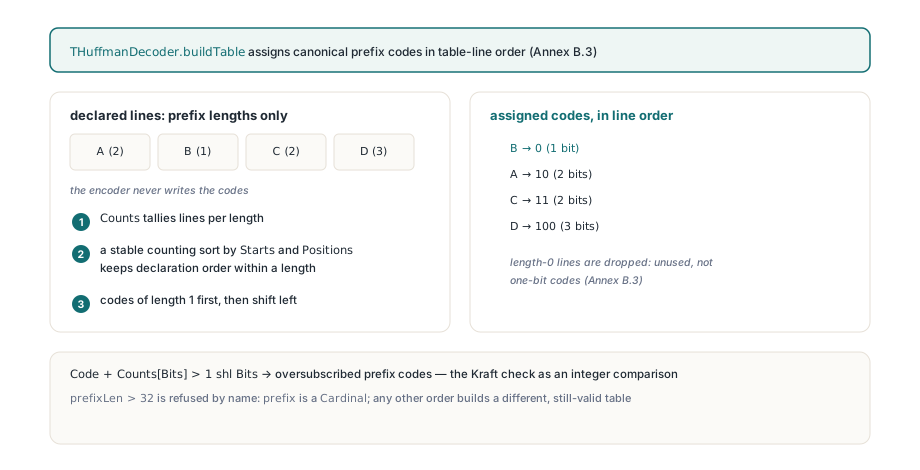
Потому что порядок объявления — единственное, что связывает битовый шаблон с диапазоном значений. Annex B.3 считает, сколько строк используют каждую длину префикса, раздаёт сначала коды длины 1, сдвигает влево для перехода к длине 2 и так далее; внутри одной длины коды достаются строкам в порядке их появления в сегменте. Маленькая таблица делает это конкретным. Шесть строк, помеченные A–F в файловом порядке, с такими длинами префиксов:
| Строка | Длина префикса | Код (файловый порядок) | Код, если поменять B и D |
|---|---|---|---|
| A | 2 | 00 | 00 |
| B | 3 | 100 | 101 |
| C | 2 | 01 | 01 |
| D | 3 | 101 | 100 |
| E | 3 | 110 | 110 |
| F | 0 | не используется | не используется |
Оба столбца — валидные префиксные коды. Левый — то, что имел в виду кодировщик: со переставленными B и D шаблон 100 даёт диапазон значений D, и декодер продолжает уже с числом из чужого интервала. Строка F имеет длину 0, что B.3 определяет как неиспользуемую; дайте ей однобитный код — и каждое последующее присваивание сдвинется
Лёгкий способ получить правый столбец — универсальная сортировка по длине префикса. TArray.Sort и TList<T>.Sort в Delphi не устойчивы, поэтому равные длины могут вернуться в любом порядке. Для канонических кодов в собственном инструменте идите по строкам в файловом порядке один раз на каждую длину:
uses
  System.SysUtils;

type
  TCodeLine = record
    PrefixLen: Integer;   // как прочитано из сегмента Tables
    Code: Cardinal;       // присваивается ниже
  end;

// Каноническое присваивание по Annex B.3, написано для вашего инструментария.
// Равные длины сохраняют файловый порядок; длина 0 кода не получает.
procedure AssignCanonicalCodes(var Lines: array of TCodeLine);
var
  LenCount: array[0..32] of UInt64;
  FirstCode: array[0..32] of UInt64;
  NextCode: UInt64;
  CurLen, I: Integer;
begin
  FillChar(LenCount, SizeOf(LenCount), 0);
  for I := 0 to High(Lines) do
  begin
    if (Lines[I].PrefixLen < 0) or (Lines[I].PrefixLen > 32) then
      raise Exception.Create('prefix length out of range');
    Inc(LenCount[Lines[I].PrefixLen]);
  end;
  LenCount[0] := 0;
  FirstCode[0] := 0;
  for CurLen := 1 to 32 do
  begin
    FirstCode[CurLen] := (FirstCode[CurLen - 1] + LenCount[CurLen - 1]) shl 1;
    // Проверка Крафта: кодов больше, чем вмещает эта длина
    if FirstCode[CurLen] + LenCount[CurLen] > (UInt64(1) shl CurLen) then
      raise Exception.Create('oversubscribed prefix lengths');
    NextCode := FirstCode[CurLen];
    for I := 0 to High(Lines) do       // файловый порядок разрешает ничьи
      if Lines[I].PrefixLen = CurLen then
      begin
        Lines[I].Code := Cardinal(NextCode);
        Inc(NextCode);
      end;
  end;
end;
Скормите ему шесть строк выше — и A получит 00, C получит 01, B получит 100, D получит 101, E получит 110; F кода не получит. PDF Library for Delphi делает ту же работу проходом подсчёта, который устойчив по построению и не перематывает таблицу 32 раза, и применяет те же две защиты. Переподписанные длины валят разбор с сообщением oversubscribed Huffman prefix codes; пропустить их — и один шаблон может совпасть с двумя строками. Префиксы длиннее 32 бит тоже валят по имени, хотя T.88 на бумаге их разрешает. Мы считаем этот потолок правильным компромиссом: каждый код влезает в одно машинное слово, а файл, которому нужно больше, куда вероятнее повреждён, чем хитёр
Значениям нужна та же аккуратность. Нижняя строка диапазона декодируется как HTLOW минус один минус 32-битное беззнаковое смещение, и с 32-битным промежуточным Integer это вычитание может завернуться в обычный с виду положительный размер. Декодер делает это в 64 битах и поднимает Huffman value exceeds signed integer range, когда истинный результат не влезает
Порядок селекторов и две ловушки, которые прикрывают друг друга
Текстовый регион или словарь символов не называют свои таблицы. Он несёт двухбитные селекторы, и каждый селектор, выставленный в custom, берёт следующий сегмент Tables из списка referred-to, в порядке referral. T.88 §7.4.3.1.2 упорядочивает селекторы текстового региона как FS, DS, DT, RDW, RDH, RDX, RDY и RSIZE; §7.4.2.1.1 упорядочивает селекторы словаря символов как DH, DW, BMSIZE и AGGINST. Значения 0 и 1 берут стандартные таблицы, 3 — свою, а 2 зарезервировано на полях всего с двумя стандартными таблицами. PDF Library for Delphi отвергает зарезервированные значения селекторов и валит разбор с сообщением missing custom Huffman table reference, когда селекторы хотят больше своих таблиц, чем регион ссылает
Если пишете свой декодер, здесь легко сделать две ошибки, и каждая прячет другую. Первая кусается в Delphi или FPC в режиме Delphi (objfpc-режим отвергает такой код как дубликат идентификатора): сеттер флагов, чей параметр носит то же имя, что поле. Параметр затеняет поле, Flags := Flags присваивает его самому себе, и поле остаётся нулём. Каждый селектор тогда читает ноль, текстовый регион берёт стандартные таблицы B.6, B.8 и B.11 для FS, DS и DT, что бы файл ни просил, и свой путь не запускается вообще
Вторая сидит в словаре символов. Хаффмановский словарь может хранить символы как несжатый коллективный битмап (BMSIZE нулевой), где каждая строка кончается частичным байтом. Значение пэддинга — число валидных битов в этом байте, и соблазнительно прочитать его как позицию младшего валидного бита:
// Последний байт одной строки коллективного битмапа, биты читаются от MSB.
// Padding := TotalWidth mod 8  -> число ВАЛИДНЫХ битов в этом байте

// Неверно: считает Padding младшим индексом бита для копирования
for BitPos := 7 downto Padding do
  CopyPixel((LastByte shr BitPos) and 1);

// Верно: младший валидный индекс бита равен 8 - Padding (0 при Padding = 0)
for BitPos := 7 downto ((8 - Padding) and 7) do
  CopyPixel((LastByte shr BitPos) and 1);

// CopyPixel — что угодно в вашем декодере, что пишет пиксель
Проверьте граничные ширины. Строка в 63 пикселя имеет пэддинг 7: неверный цикл копирует один бит последнего байта, верный — семь. Строка в 9 пикселей имеет пэддинг 1: неверный копирует семь, верный — один. При 64 пикселях оба копируют все восемь, поэтому кратные 8 никогда её не вылавливают. Синтетические коллективные битмапы шириной 7 и 9 пикселей прикалывают обе стороны байтовой границы. И повреждение путешествует дальше, потому что уточнение использует эти символы как референсы
Если в вашем декодере обе ловушки, отладка становится мрачной. Почините один сеттер — свой путь наконец запустится, прямо в битые коллективные битмапы, и страница всё равно выглядит неправильно. Почините один пэддинг — видимых изменений нет, потому что свой путь всё ещё недостижим. Проверяйте оба на синтетических входах, прежде чем доверять любому из изменений. Смежная деталь: хаффмановский словарь символов, у которого входные и новые символы в сумме дают один, получает из формулы log2 длину символьного кода 0, но хаффмановский вариант пишет каждый символьный ID минимум одним битом. PDF Library for Delphi поднимает эту длину до 1 в хаффмановском режиме
Откуда уточнение по Huffman берёт размер своей растровой карты?
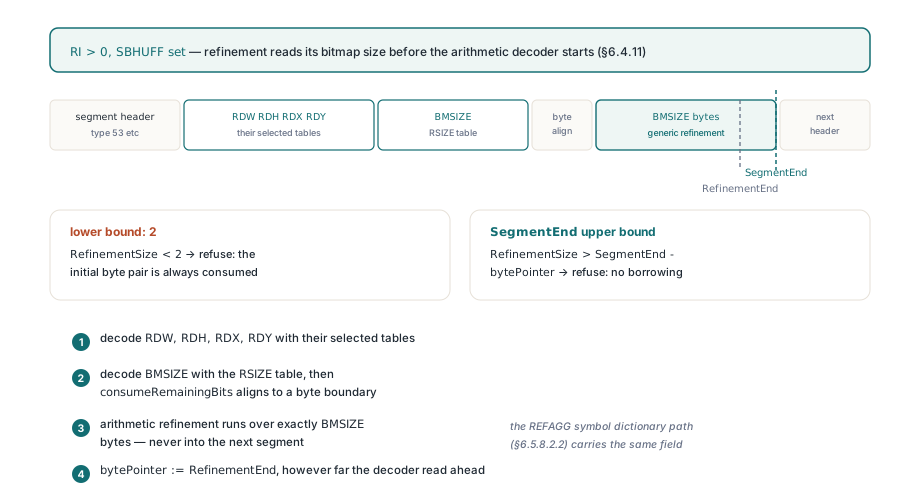
Из поля BMSIZE, которое существует только в хаффмановском режиме и декодируется впереди арифметических данных уточнения. Когда экземпляр текстового региона имеет уточнение (RI не ноль) и выставлен SBHUFF, T.88 §6.4.11 велит декодеру прочитать RDW, RDH, RDX и RDY их выбранными таблицами, затем BMSIZE таблицей RSIZE, затем перескочить на границу байта и только потом гонять общее уточняющее декодирование ровно по BMSIZE байтам. У арифметических текстовых регионов такого поля нет, поэтому декодер, делящий один путь кода между режимами, его пропускает, рано запускает арифметический декодер и уточняет каждый символ по шуму. Путь словаря символов с REFAGG и одиночным уточняющим экземпляром (§6.5.8.2.2) имеет то же поле
PDF Library for Delphi ограничивает BMSIZE с обеих сторон. Минимум — 2, начальная пара байтов, которую арифметический декодер потребляет всегда. Максимум — то, что осталось от текущего сегмента, нарочно не всего потока: BMSIZE, который влезает, только позаимствовав байты из следующего сегмента, — признак кривого файла, и проверка по длине всего потока позволила бы арифметическому декодеру читать в следующий заголовок. Размеры вне диапазона валят разбор с сообщением invalid refinement bitmap size. После этого хаффмановский читатель продолжит ровно на BMSIZE байтов дальше поля, что бы там ни успел прочитать арифметический декодер
Объявленная длина сегмента — вот граница
Каждый заголовок сегмента заявляет, сколько байтов данных следует за ним, и декодер держит сегмент в этих пределах в обе стороны: чтение за конец — ошибка, раннее завершение — норма, а следующий заголовок всегда читается оттуда, куда указал файл. Из этого следуют правила поменьше. Неизвестная длина данных из T.88 §7.2.7 отвергается сразу, вместо поиска терминатора. Сегменты referred-to должны нести меньшие номера, чем текущий, и уже существовать. END_OF_PAGE и END_OF_FILE обязаны заявить ноль байтов данных. Сегмент Profiles (тип 52) обязан быть ровно 4 плюс 4 на число идентификаторов; его пропускают, но сохраняют, чтобы поздние сегменты могли на него ссылаться, и неизвестный идентификатор профиля разбор не останавливает
Классический случай раннего завершения — MMR. MMR-декодер закончен, как только выдал последний пиксель последней строки, а это может случиться раньше терминатора EOFB, который T.88 §6.2.5.7 кладёт в конец данных. Читатель, считающий, что он теперь стоит на следующем заголовке, разберёт оставшиеся байты EOFB как номер сегмента и упадёт несколькими байтами позже, далеко от настоящей причины. Прыжок к объявленному концу снимает вопрос. Та же привычка проходит через то, как PDF Library for Delphi вообще разбирает недоверенные PDF-структуры
Декодирование потока изображения JBIG2 из Delphi
Декодер живёт в юните PDFlibJBIG2 как TPLJBIG2Decoder. LoadFromByteArray принимает встроенные JBIG2-данные изображения /JBIG2Decode и, опционально, данные его потока /JBIG2Globals, где обычно живут свои таблицы и разделяемые словари символов. При любом отказе он возвращает False и оставляет причину в LastError; вывод предыдущего вызова очищается в начале каждого, так что проваленный декод никогда не оставит старые пиксели, которые вызывающий примет за результат
uses
  System.SysUtils, PDFlibJBIG2;

// ImageBytes: данные потока изображения, из которых уже убраны
//   все фильтры перед JBIG2Decode
// GlobalBytes: данные потока /JBIG2Globals или пустой массив
function DecodeAndCountBlack(const ImageBytes, GlobalBytes: TJBIG2ByteArray;
  out BlackPixels: Int64): Boolean;
var
  Decoder: TPLJBIG2Decoder;
  Line: TJBIG2ByteArray;
  Row, Col: Integer;
begin
  BlackPixels := 0;
  Decoder := TPLJBIG2Decoder.Create;
  try
    Result := Decoder.LoadFromByteArray(ImageBytes, GlobalBytes);
    if not Result then
    begin
      // Формат: 'JBIG2 segment <n> (type <t>) at byte <offset>: <reason>'
      Writeln('JBIG2 refused: ', Decoder.LastError);
      Exit;
    end;
    for Row := 0 to Decoder.Height - 1 do
    begin
      Decoder.GetScanline(Row, Line);   // один байт на пиксель, 0 или 1
      for Col := 0 to Decoder.Width - 1 do
        Inc(BlackPixels, Line[Col]);    // 1 = чёрный в JBIG2
    end;
  finally
    Decoder.Free;
  end;
end;
Счёт чёрных пикселей — ваша собственная проверка, дешёвый отпечаток для сверки со вторым рендерером. Сегментные отказы приходят с префиксом из номера сегмента, типа и байтового смещения, поэтому (type 53) перед сообщением oversubscribed Huffman prefix codes показывает прямо на сегмент Tables. Держите два канала ошибок раздельно: TPLJBIG2Decoder.LastError — диагностический текст этого декодера, а TPDFlib.LastErrorCode — числовой код API уровня библиотеки. Выбор страницы следует за потоком: декодер возвращает битмап первого встреченного сегмента page-information и не ищет ассоциацию страницы 0, потому что JBIG2 внутри PDF несёт одну страницу, и кодировщики обычно нумеруют её единицей
Сравнение рендереров на таких файлах требует некоторой скромности, потому что независимые декодеры JBIG2 не всегда согласны по файлам со своими таблицами и хаффмановским уточнением. Два несовпадающих декодера ничего не решают. Решают поля формата: какие таблицы выбрали селекторы, что заявил BMSIZE, где кончается каждый сегмент
Кодирование разобрано в статье про бэкенды JBIG2-энкодера и то, как они линкуются. Путь чтения обязан принимать то, что выдал чужой энкодер, и делит правила с встроенным TIFF-декодером и его проверками BigTIFF и tiled-раскладки: отказ по имени, никаких заимствований байтов за объявленной границей, промежуточная арифметика в широкой разрядности. Если папка отсканированных PDF постоянно валит другие тулкиты, проверьте, не JBIG2 ли это с хаффмановским кодированием и своими таблицами, и прогоните их через нативный путь чтения Delphi и C++Builder, описанный на странице продукта PDF Library for Delphi