Экранируйте комментарий клиента как положено, чтобы <b>urgent</b> попадал в HTML-шаблон как <b>urgent</b>, отдайте его рендереру, разбирающему разметку дважды, — и PDF может вернуться со словом urgent жирным. Экранирование было верным. Рендерер декодировал его по разу за проход. Любой путь HTML-to-PDF, который разбирает, выписывает результат обратно как HTML и разбирает снова, обязан декодировать сущности ровно один раз за всю поездку
Хелпдесковая версия этой истории заурядна. Тикеты экспортируются в PDF, комментарий клиента сидит внутри <p>, и кто-то набирает угловые скобки в поле комментария. Неизвестное имя тега просто исчезает со страницы. Экранированный анкор становится кликабельной link-аннотацией в документе, которому ваш персонал доверяет. Файл валиден и открывается везде; он просто говорит не то, что в данных
Где экранированный текст снова становится разметкой
Экранированный текст становится разметкой в точке, где двухпроходный рендерер пишет уже декодированный текст обратно в HTML, не экранируя его снова. Всё, что декодировал первый разбор, становится живым синтаксисом для второго
Два прохода в DrawHTMLText и DrawHTMLTextBox PDF Library for Delphi (PDFlibPas) существуют по веской причине. Первый разбор делит вход на теги и слова. Затем рендерер разрешает каскад стилей: правила из блоков <style> матчятся против каждого тега, сливаются с inline-атрибутами style, и весь список элементов выписывается обратно одной нормализованной HTML-строкой, где каждый тег несёт свой финальный стиль. Проход вёрстки разбирает эту строку. Матчинг селекторов, flexbox, grid и остальная CSS-поддержка из статьи flexbox, CSS grid и вёрстка сносок в HTML-рендеринге PDFlibPas — всё висит на этом промежуточном шаге
Опасность сидит в том, как слова возвращаются наружу. Теги можно записать обратно из их исходной формы, но слова держатся как декодированный текст, потому что именно его мерит разбиватель строк. Допишите слово, пришедшее из <unsafe>, в нормализованную строку как есть — и <unsafe> приедет на второй разбор элементом. Дизайн с одним декодированием обязан закрыть ещё три меньшие течи:
- Если
&не входит в декодируемый набор,R&Dпечатается буквально, и вообще никак не положить на страницу написание<как текст - Если стадия рисования заменяет
ещё раз после того, как разбор закончился, буквальное написание сущности исчезает в самый последний момент - Если HTML-продюсер выше по течению — конвертер Markdown или экспортёр датасета — экранирует только угловые скобки, написание сущности внутри кодового сэмпла или значения ячейки декодируется в разметку
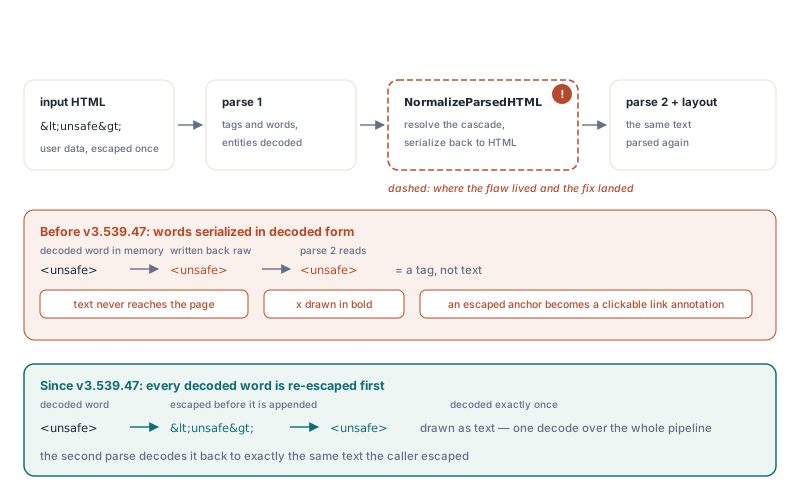
Таблица ниже перечисляет, что доезжает до страницы для горстки входов, сравнивая наивный двухпроходный рендерер с конвейером PDFlibPas
| Вход, доезжающий до рендерера | Наивный двухпроходный рендерер | PDFlibPas |
|---|---|---|
<unsafe> | Разобрано как тег, текст до страницы не доезжает | <unsafe> нарисовано как текст |
<b>x</b> | x нарисовано жирным | <b>x</b> нарисовано как текст |
R&D | R&D напечатано буквально | R&D |
&lt; | &lt; напечатано буквально | < |
Markdown code span, содержащий | Неразрывный пробел | нарисовано как текст |
Значение ячейки датасета < | < | < |
Как PDF Library for Delphi декодирует каждую сущность ровно один раз?
PDF Library for Delphi декодирует каждую сущность ровно один раз, держа одновременно три правила: парсер декодирует & последним, стадия рисования не декодирует ничего, и каждое место, превращающее декодированные слова обратно в HTML, сначала экранирует их. Выбросьте любое из трёх — и одна из строк таблицы выше перевернётся в наивный столбец
Начните с того, что декодируется. В текстовом содержимом парсер распознаёт <, >, & и . Числовые ссылки вроде A и именованные сущности вроде " остаются буквальным текстом. Этот короткий список решает, как экранировать собственный ввод — к этому вернёмся ниже
Порядок внутри декодера важен даже внутри одного прохода. Декодируйте & первым — и вход &lt; станет <, а самая следующая замена превратит его в <: двойное декодирование без всякого второго разбора. Поэтому 8-битный путь слов заменяет <, > и первыми, а & — последней, чтобы произведённый амперсанд больше никогда не рассматривался. UTF-16-путь слов идёт другим маршрутом к тому же результату — один проход слева направо двухбайтовыми шагами, переписывающий каждое совпадение на месте и перепрыгивающий через него
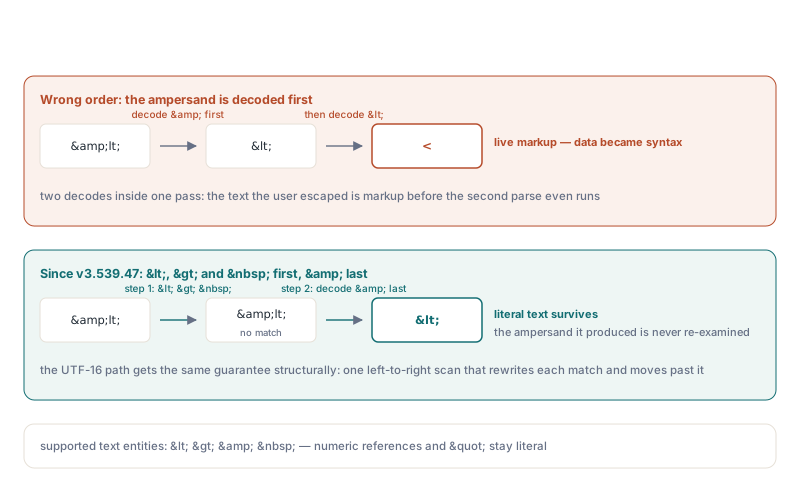
Стадия рисования поздней замены не получает. Слово, доехавшее до разбивателя строк, — финальный текст, а декодирование живёт в парсере и нигде больше
Пограничное правило весит больше всех. Когда рендерер пишет нормализованный HTML, он экранирует &, < и > в каждом декодированном слове перед добавлением, а второй разбор декодирует обратно в те же символы. Суммарный эффект за оба прохода: одно декодирование. Строка продолжения, которую возвращает DrawHTMLTextBox, следует тому же правилу. Слова, не влезшие, экранируются прежде, чем уйти в остаток, а остальная часть остатка копируется из нормализованного HTML, который уже экранирован. Бокс, взявший всё, возвращает пустую строку
Почему экранирование UTF-16BE не может работать побайтово?
Экранирование UTF-16BE не может работать на уровне байтов, потому что два байта амперсанда могут стоять поперёк двух несвязанных символов. Весь 16-битный кодовый юнит — единственная безопасная единица работы
Рендерер держит Unicode-слова как big-endian UTF-16, упакованный в байтовые строки, старший байт первым, поэтому амперсанд — это 00 26. Возьмите U+0100 (латинская заглавная A с макроном, байты 01 00) и следом U+2603 (снеговик, байты 26 03). Буфер читается как 01 00 26 03, и байты два-три складываются в 00 26. Байтовый поиск #0'&' найдёт амперсанд, которого не содержит ни один символ, вторит & в середину двух кодовых точек и сдвинет каждый дальнейший символ на байт
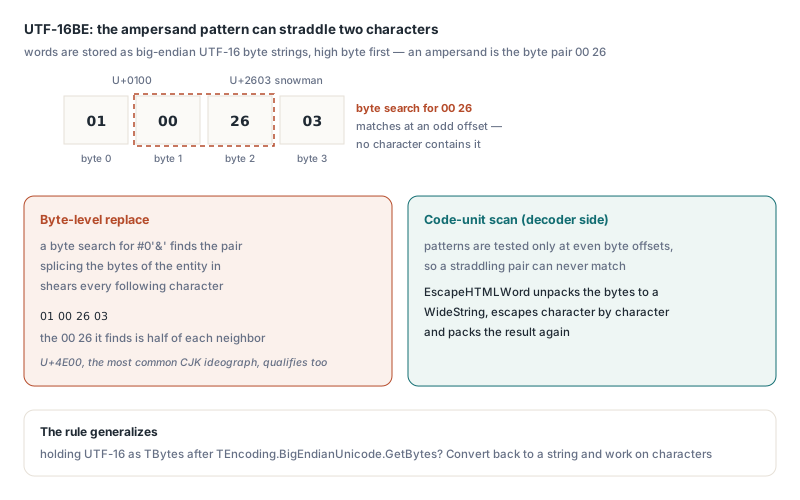
Это не экзотический угол. Любой символ с нулевым младшим байтом может дать первую половину, и U+4E00 — один из самых частых CJK-идеографов — такой символ. Угловые скобки выставлены тем же способом: 00 3C и 00 3E всплывают всякий раз, когда за таким символом следует символ из диапазона U+3C00–U+3EFF в CJK Extension A. Поэтому PDFlibPas экранирует Unicode-слова, распаковывая их в WideString, экранируя посимвольно и упаковывая результат обратно. Декодер безопасен по зеркальной причине: он проверяет паттерны только на чётных смещениях
Ваш собственный код может стукнуться о ту же стену. Как только UTF-16-текст живёт в TBytes — скажем, после TEncoding.BigEndianUnicode.GetBytes, — поиск в нём байтовых паттернов это баг, ждущий нужной пары символов. Конвертируйте обратно в строку и работайте по символам
Markdown-код и ячейки датасета: амперсанд идёт первым
Оба HTML-продюсера внутри PDFlibPas — конвертер Markdown и экспортёр датасета — экранируют амперсанд раньше угловых скобок, поэтому единственное декодирование в рендерере восстанавливает исходный текст побайтно
В MarkdownToHTML inline code span'ы и ограждённые или индентированные кодовые блоки отображают & в &, < в < и > в >. Пробелы становятся , а табуляция — четырьмя такими, что сохраняет индентацию. Обычная проза экранирует только угловые скобки: сырой HTML, набранный в прозе, не может впрыснуть теги, а автор, нарочно написавший &, всё равно получит амперсанд — как и ожидают авторы Markdown. DrawMarkdownText и DrawMarkdownTextBox гоняют ту же конверсию, поэтому кодовый блок выглядит ровно как набран:
uses
System.SysUtils, PDFlibrary;
procedure RenderCodeSample;
var
Lib: TPDFlib;
Md, Html: WideString;
begin
Md := 'Comparison helper:' + sLineBreak + sLineBreak +
'```' + sLineBreak +
'if (A < B) and (Flags <> 0) then' + sLineBreak +
' WriteLn(''<tag> & R&D'');' + sLineBreak +
'```';
Lib := TPDFlib.Create;
try
// Загляните в HTML: внутри кода '&' становится '&', а '<' — '<'
Html := Lib.MarkdownToHTML(Md);
Lib.SetOrigin(1); // origin слева сверху, Y растёт вниз
Lib.SetMeasurementUnits(0); // пункты
// Страница показывает код ровно как набран, включая написания сущностей
Lib.DrawMarkdownText(50, 50, 495, Md);
Lib.SaveToFile('code-sample.pdf');
finally
Lib.Free;
end;
end;Экспортёр датасета — там, где живёт соблазнительный короткий путь. Если бы рендерер не декодировал &, экранирование амперсанда печатало бы & в каждой ячейке, где он есть, поэтому экранирование одних угловых скобок выглядит более дружелюбным выбором. Он разваливается на первой ячейке, чьё значение случайно содержит <, которая доезжает до страницы как <. Поскольку рендерер декодирует &, экспортёр за PDFlibExportDataSet экранирует & первым, и значение вроде R&D < & попадает в PDF дословно. Остальная часть экспортёра разобрана в статье экспорт TDataSet в PDF-отчёт в Delphi
Почему первым, а не просто где-то в цепочке? Экранируйте < первым — получите <. Экранируйте & вторым — то превратится в &lt;, что корректное одиночное декодирование покажет как <, а не <. Последовательная цепочка замен работает, только когда экранирующий символ сам обрабатывается раньше любого шага, который его вводит
Как экранировать недоверенный текст для DrawHTMLTextBox?
Экранируйте недоверенный текстовый контент для PDFlibPas заменой &, затем <, затем >, ровно один раз, и держите недоверенные данные вовсе в стороне от значений атрибутов. Хелпер ниже — ваш собственный; это обычный RTL-код:
uses
System.SysUtils, PDFlibrary;
// Ваш хелпер (не часть библиотеки): экранирует недоверенный текст
// для HTML-текстового контента PDFlibPas. '&' заменяется первой,
// иначе амперсанд внутри свежепорождённого '<'
// будет экранирован второй раз
function EscapeHTMLText(const S: string): string;
begin
Result := StringReplace(S, '&', '&', [rfReplaceAll]);
Result := StringReplace(Result, '<', '<', [rfReplaceAll]);
Result := StringReplace(Result, '>', '>', [rfReplaceAll]);
end;
procedure RenderTicket(const CustomerComment: string);
var
Lib: TPDFlib;
Html: WideString;
begin
Lib := TPDFlib.Create;
try
Lib.SetOrigin(1);
Lib.SetMeasurementUnits(0);
Html := '<p><b>Customer comment</b></p>' +
'<p>' + EscapeHTMLText(CustomerComment) + '</p>';
Lib.DrawHTMLText(50, 50, 495, Html);
Lib.SaveToFile('ticket.pdf');
finally
Lib.Free;
end;
end;Скормите ему комментарий Try <a href="https://example.com">this</a> & <b> — и страница покажет эти символы один к одному. Под рендерером, декодирующим дважды, тот же экранированный вход становится живой link-аннотацией. Это шаг от косметического глитча к проблеме безопасности: комментарий тикета никогда не должен уметь сажать кликабельный URL в PDF, идущий вашему же персоналу
Заметьте, что хелпер оставляет в покое. Универсальные экранировщики также превращают " в " и ' в ' — для браузера верно, здесь неверно: декодирование текста в PDFlibPas знает только четыре сущности, перечисленные ранее, поэтому эти два печатались бы буквально как " и '. Не переиспользуйте браузерный экранировщик для этого. Кавычки безвредны в текстовом содержимом; они важны только внутри значений атрибутов, а рендерер вообще не декодирует сущности в атрибутах. Для атрибутов мы предпочитаем правило хитрому экранировщику, поскольку никакая схема экранирования там всё равно не проверяется: держите пользовательские значения в стороне от href, src и style. Если цель ссылки всё же должна приходить из пользовательского ввода, валидируйте её сами по allow-list схем и символов и отвергайте всё, содержащее кавычки или угловые скобки
Из однопроходного декодирования прямо следуют две привычки:
- Всегда экранируйте
&. Пропустите — и пользовательский текст с<покажется как<— безвредно, но не то, что набрал пользователь - Экранируйте в одной точке. Текст, прошедший через два экранировщика, отрисует
<видимым написанием<, поэтому найдите единственное место, где ваши данные въезжают в HTML-строку, и экранируйте там
Пагинация через LeftOverText без поломки экранирования
DrawHTMLTextBox возвращает не влезший HTML, обычно называемый LeftOverText, и этот остаток сохраняет буквальные написания сущностей и экранированные угловые скобки целыми, когда уезжает в следующий бокс. Возвращайте его в точности как получили
const
  BoxLeft = 50;
  BoxTop = 50;
  BoxWidth = 495;    // под страницу A4 в пунктах
  BoxHeight = 740;
  MaxPages = 500;    // ваш собственный предохранитель

procedure RenderLongHTML(Lib: TPDFlib; const Html: WideString);
var
  Rest: WideString;
  Pages: Integer;
begin
  Lib.SetOrigin(1);
  Lib.SetMeasurementUnits(0);
  Rest := Lib.DrawHTMLTextBox(BoxLeft, BoxTop, BoxWidth, BoxHeight, Html);
  Pages := 1;
  while (Rest <> '') and (Pages < MaxPages) do
  begin
    Lib.NewPage;
    Inc(Pages);
    // Остаток — уже экранированный HTML: не экранируйте и не разэкранируйте его
    Rest := Lib.DrawHTMLTextBox(BoxLeft, BoxTop, BoxWidth, BoxHeight, Rest);
  end;
  if Rest <> '' then
    raise Exception.CreateFmt('Content still left after %d pages', [MaxPages]);
end;
Обращайтесь с остатком как с непрозрачным. Это нормализованный HTML со стилями, уже разложенными на каждый тег, поэтому прогон через собственный экранировщик превратит каждый < в &lt;, а его декодирование вручит следующему боксу живые теги. Вклейка свежего пользовательского текста в него имеет те же два режима отказа. Потолок страниц стоит одного сравнения: если какой-то элемент никогда не влезет в бокс, цикл без потолка не имеет естественного выхода
У Markdown своё продолжение. DrawMarkdownTextBox возвращает остаток, начинающийся с комментария-маркера, который велит Markdown-точкам входа пропустить конверсию при следующем вызове. Возвращайте его в DrawMarkdownTextBox или DrawMarkdownText — так же, как вы скормили бы LeftOverText обратно DrawHTMLTextBox. Остаток Markdown принадлежит Markdown-точкам входа, поэтому держите его на той стороне и пропускайте через HTML-вызовы только остатки DrawHTMLTextBox
Форма за всем этим — разобрать, записать обратно в тот же синтаксис, разобрать снова — всплывает и в шаблонных движках, HTML-санитайзерах и цепочках Markdown-to-HTML-to-PDF, и отказ приходит в двух направлениях. Слишком слабое пере-кодирование превращает данные в синтаксис. Слишком сильное кодирование или декодер, исполняющийся дважды, показывает читателю написания сущностей или съедает их. Латать одно направление поодиночке — значит сломать другое, поэтому рендерер PDFlibPas держит декодирование &, его последним, отсутствие позднего декодирования и переэкранирование на каждой границе единым пакетом. Экспортное направление следует тому же правилу в статье PDF в Markdown и DOCX семантический экспорт из Delphi, где каждый литеральный символ экранируется для целевого синтаксиса ровно один раз
Рисование HTML и Markdown, экспортёр датасет-отчётов и остальная часть движка вёрстки идут как нативные Pascal-исходники в PDF Library for Delphi, для Delphi и Free Pascal. Редакции, покрытие платформ и пробная загрузка перечислены на странице продукта PDF Library for Delphi