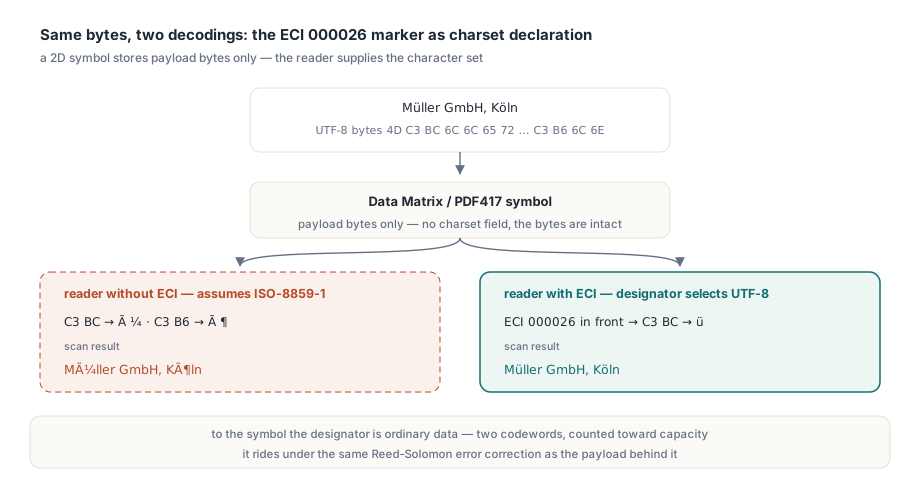
Складская этикетка хранит получателя Müller GmbH, Köln в UTF-8 внутри символа Data Matrix, и каждый терминал сбора данных в цехе читает её обратно как Müller GmbH, Köln. Свойство BarcodePayloadEncoding библиотеки PDFlibPas, выставленное в bpeUTF8WithECI, ставит перед данными маркер ECI 000026, который велит читалкам Data Matrix и PDF417 декодировать байты как UTF-8
Почему полезная нагрузка UTF-8 декодируется как Müller?
Символ не несёт объявления кодировки, поэтому читалка откатывается к умолчальной однобайтной кодовой странице той символики — для Data Matrix это ISO-8859-1. UTF-8-овская ü — это два байта C3 BC, которые ISO-8859-1 отображает в Ã и ¼; ö тем же путём превращается в ö. Сами байты целы. Extended Channel Interpretation — это объявление кодировки в мире штрихкодов. Реестр ECI организации AIM присваивает номера кодировкам, 000026 закреплён за UTF-8, и обозначение ECI в начале символа говорит совместимой со стандартом читалке: всё, что дальше, декодируй в этой кодировке. Для самого символа обозначение — обычные данные. В обеих обсуждаемых здесь символиках оно занимает два кодовых слова, учитывается в ёмкости и защищено той же коррекцией ошибок Рида — Соломона для 2D-штрихкодов, что и полезная нагрузка позади него
Позиции кодовых слов ECI в Data Matrix и PDF417
У каждой символики для маркера есть фиксированный слот. Поставите его куда-то ещё — символ либо не декодируется вовсе, либо декодируется с мусором в начале:
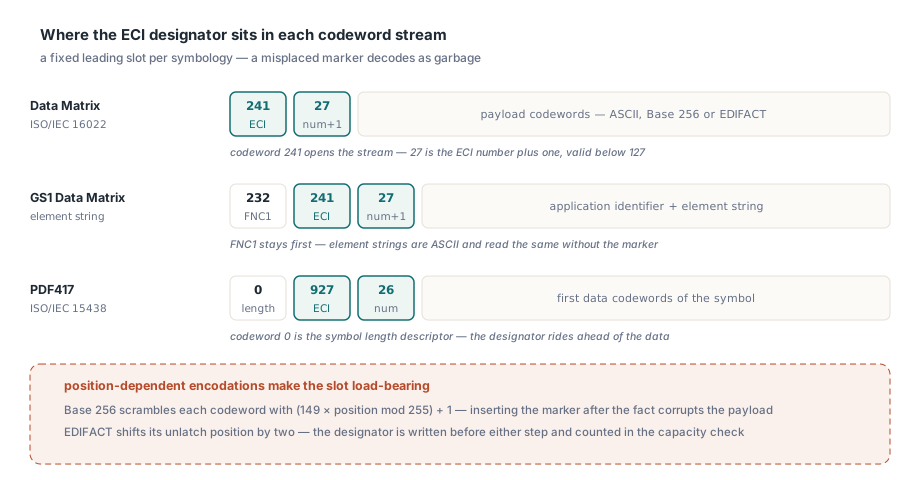
- Data Matrix (ISO/IEC 16022): кодовое слово 241, затем номер ECI плюс один в форме одного кодового слова, применяемой для значений ниже 127, то есть 27 для UTF-8. Оно открывает поток данных
- GS1 Data Matrix: FNC1 (кодовое слово 232) обязана стоять первой, поэтому PDFlibPas ставит маркер сразу после неё, если вы его запросили; впрочем, элементные строки GS1 набираются из подмножества ASCII и без маркера читаются так же
- PDF417 (ISO/IEC 15438): кодовое слово 0 — дескриптор длины символа, а маркер идёт следом кодовыми словами 927 и 26, перед первым кодовым словом данных
Base 256 — самый коварный случай. Это кодирование — компактный режим Data Matrix для произвольных байтов — перемешивает каждое кодовое слово псевдослучайной величиной, производной от его абсолютной позиции в символе: (149 × position mod 255) + 1. Вставить маркер после перемешивания — и каждый байт позади него окажется перемешанным для позиции на две раньше той, что видит читалка, так что вся полезная нагрузка распакуется в неверные значения. Кодирование EDIFACT несёт мягкую версию той же зависимости: позиция выхода из режима сдвигается на два, когда маркер встаёт вперёд. PDFlibPas пишет маркер в поток кодовых слов до того, как запустится любой из этих шагов, и проверка ёмкости, выбирающая размер символа, уже учитывает его. Код этикетки для обеих символик:
uses
  SysUtils, PDFlibrary;

procedure PrintConsigneeLabel(const FileName: string);
var
  Pdf: TPDFlib;
begin
  Pdf := TPDFlib.Create;
  try
    Pdf.NewDocument;                                // создаёт и выбирает страницу 1
    Pdf.SetPageSize('A4');
    Pdf.SetMeasurementUnits(1);                     // миллиметры
    Pdf.SetOrigin(1);                               // Top отсчитывается от верхнего края

    Pdf.BarcodePayloadEncoding := bpeUTF8WithECI;   // байты UTF-8 + ECI 000026
    if Pdf.DrawDataMatrixSymbol(20, 20, 0.5, 'Müller GmbH, Köln',
      1,      // Encoding: 1 = кодирование ASCII
      0,      // SymbolSize: 0 = первый размер из таблицы, куда влезает поток
      100) <> 1 then                                // обычная ориентация, свободная зона в 1 модуль по умолчанию
      raise Exception.CreateFmt('Data Matrix failed (%d)', [Pdf.LastErrorCode]);

    if Pdf.DrawPDF417SymbolEx(20, 50, 'Zustellung: Müller GmbH, Köln',
      0, 0, 0,  // ориентация, столбцы, строки: автоматически
      -1,       // уровень коррекции автоматически
      0.3, 3.0) <> 1 then
      raise Exception.Create('PDF417 failed');

    // Сканер с поддержкой ECI должен вернуть немецкий текст для обоих символов
    Pdf.BarcodePayloadEncoding := bpeSystemANSI;    // обратно к умолчанию
    Pdf.SaveToFile(FileName);
  finally
    Pdf.Free;
  end;
end;
NewDocument уже создаёт страницу 1 и выбирает её, поэтому символы попадают на первую страницу без вызова NewPage. SetOrigin(1) переносит начало координат в левый верхний угол, и Top становится расстоянием от верхнего края символа до верха страницы. При умолчальном начале в левом нижнем углу Top в 10 мм поднимает этот край на 10 мм над низом листа, и символ высотой 11 мм свисает с него. DrawDataMatrixSymbol возвращает 1 при успехе. Для данных, которые она не может закодировать — полезная нагрузка, переросшая самый большой символ после подсчёта маркера, или заказанный фиксированный размер, — она возвращает 0, выставляет LastErrorCode в 302 и ничего не рисует, поэтому пример трактует всё, кроме 1, как ошибку
Должна ли каждая этикетка нести маркер ECI?
Нет, и умолчание это отражает. У BarcodePayloadEncoding три значения, и каждое рассчитано на свою популяцию читалок:
bpeSystemANSI(умолчание) прогоняет текст через системную ANSI-кодовую страницу и не пишет маркер — именно этого ждут макеты этикеток, собранные с функциями QR, PDF417 и Data Matrix библиотеки PDFlibPasbpeUTF8пишет байты UTF-8 без маркера — для закрытых систем, где штрихкод читает ваш собственный софт, заранее считающий данные UTF-8bpeUTF8WithECIпишет байты UTF-8 и помечает их ECI 000026
Цена пометки всего подряд — поддержка со стороны читалок. Обработка ECI на многих сканерах — настройка, и в зависимости от неё устройство может отказаться от символа или передать обозначение на хост как текст: конвенция AIM — обратный слеш и шесть цифр, так что приложение получит \000026Müller GmbH, Köln. Включайте маркер по символу, для полезных нагрузок с не-ASCII текстом, и выкатывайте его вместе с изменением профиля сканеров. Однобайтовая нагрузка остаётся разумным выбором, пока каждое имя влезает в кодовую страницу, на которую рассчитаны ваши читалки. ü — байт FC и в Windows-1252, и в ISO-8859-1, поэтому немецкий адрес, записанный под bpeSystemANSI на западноевропейской Windows, корректно декодируется читалкой Data Matrix, никогда не слыхавшей про ECI. У японского текста такого запасного пути нет
Размер символа: автоподбор, фиксированные шаблоны и прямоугольники
Два кодовых слова маркера редко действуют в одиночку. При ASCII-кодировании строка получателя под bpeSystemANSI держит ü и ö одиночными байтами выше 127 по два кодовых слова за каждый, и вся строка стоит 19 кодовых слов — влезает в символ 20×20 с его 22 кодовыми словами данных. В UTF-8 обе буквы превращаются в четыре старших байта, и строка стоит 23. Маркер доводит до 25. Это уже 22×22, и скачок — от самих байтов UTF-8, ведь 23 переполняет 20×20. Шаблон, жёстко задающий SymbolSize в 9 (20×20), получает 0 и ошибку 302 от DrawDataMatrixSymbol сразу же, как сменит кодировка, и в слоте штрихкода не рисуется ничего
Автоподбор может сменить форму. При SymbolSize в 0 PDFlibPas идёт по списку размеров ISO/IEC 16022 в порядке следования и берёт первую запись, чья ёмкость данных вмещает поток. Шесть прямоугольных размеров стоят в этом списке между квадратами. Нагрузка, занимавшая символ 26×26 (44 кодовых слова данных), с маркером требует 46, и следующая запись, вмещающая 46, — 16×48 с 49, впереди 32×32 с 62. При 0,5 мм на модуль квадрат 13 мм превращается в полосу 8 × 24 мм. Заполненный 22×22 делает то же: 30 кодовых слов плюс два ложатся в 16×36. Малые нагрузки остаются квадратами — три кодовых слова, занимавших 10×10, превращаются в пять и влезают в 12×12, который в списке стоит перед 8×18. Если макет резервирует квадратный слот, прибейте SymbolSize к квадрату, который можете себе позволить (16 для 32×32), и пусть ошибка 302 сообщает, когда имя для него слишком длинное; автоподбор подходит макетам, готовым к любой форме
PDF417 растёт по другому правилу. При ErrorLevel в -1 кодировщик планирует коррекцию ошибок по рекомендованным минимальным уровням ISO/IEC 15438, которые ступенчато повышаются на 41, 161 и 321 кодовом слове, включая дескриптор длины. Поток из 39 кодовых слов с маркером превращается в 41, минимальный уровень смещается с 2 на 3, и блок коррекции ошибок, который он планирует, растёт с 8 до 16 кодовых слов. Это десять лишних кодовых слов. При автоматических столбцах и строках кодировщик раскладывает прямоугольник от этой увеличенной суммы, так что нагрузка, сидевшая у самой ступеньки, прирастает площадью сильнее, чем обещают её два кодовых слова маркера
Какое кодирование держит UTF-8 Data Matrix компактным?
Сравните обе цены напрямую. ASCII-кодирование упаковывает пару цифр в одно кодовое слово и простой ASCII по одному на символ, но каждый байт выше 127 стоит двух: Upper Shift (235) и байт минус 127. Base 256 один раз платит за переключение режима и поле длины — одно кодовое слово длины до 249 байтов, два сверх того — а дальше по одному кодовому слову на байт, без упаковки цифр. Для текста без длинных цифровых серий Base 256 выигрывает, как только нагрузка набирает три старших байта. Строка Müller уже набирает: 21 кодовое слово против 23. Длинные числовые серии тянут баланс обратно к ASCII, ведь там каждая пара цифр экономит кодовое слово. Вспомогательная функция ниже считает обе цены и рисует более дешёвым режимом; чистый ASCII вовсе не получает маркера, поскольку под любой кодировкой читается одинаково:
// Рисуем Data Matrix для Unicode-текста более дешёвым кодированием
function DrawUnicodeDataMatrix(Pdf: TPDFlib; Left, Top, ModuleSize: Double;
  const Text: WideString): Integer;
var
  Bytes: UTF8String;
  I, HighBytes, AsciiCost, Base256Cost, Mode: Integer;
  Saved: TPDFlibBarcodePayloadEncoding;
begin
  Bytes := UTF8Encode(Text);
  HighBytes := 0;
  AsciiCost := 0;
  I := 1;
  while I <= Length(Bytes) do
  begin
    if (I < Length(Bytes)) and (Bytes[I] >= '0') and (Bytes[I] <= '9') and
       (Bytes[I + 1] >= '0') and (Bytes[I + 1] <= '9') then
    begin
      Inc(AsciiCost);                    // пара цифр: одно кодовое слово
      Inc(I, 2);
      Continue;
    end;
    if Ord(Bytes[I]) > 127 then
    begin
      Inc(HighBytes);
      Inc(AsciiCost, 2);                 // Upper Shift + (байт - 127)
    end
    else
      Inc(AsciiCost);
    Inc(I);
  end;
  if Length(Bytes) <= 249 then
    Base256Cost := Length(Bytes) + 2     // переключение + одно кодовое слово длины
  else
    Base256Cost := Length(Bytes) + 3;    // переключение + два кодовых слова длины

  Saved := Pdf.BarcodePayloadEncoding;
  try
    if HighBytes = 0 then
    begin
      Pdf.BarcodePayloadEncoding := bpeSystemANSI;  // чистый ASCII: без маркера
      Mode := 1;
    end
    else
    begin
      Pdf.BarcodePayloadEncoding := bpeUTF8WithECI;
      if Base256Cost < AsciiCost then
        Mode := 3                        // Base 256
      else
        Mode := 1;                       // ASCII
    end;
    Result := Pdf.DrawDataMatrixSymbol(Left, Top, ModuleSize, Text, Mode, 0, 100);
  finally
    Pdf.BarcodePayloadEncoding := Saved;
  end;
end;
Для 東京都千代田区 UTF-8-форма — это 21 байт, все выше 127. С маркером Base 256 требует 25 кодовых слов данных, а ASCII-кодирование — 44, что по таблице ёмкости даёт символ 22×22 против 26×26 при том же размере модуля. Тот 26×26 забит под завязку. Ещё одно кодовое слово — и он прыгает в 16×48. Нагрузки GS1 (режим 7) остаются вне вспомогательной функции: их элементные строки — ASCII. QR-коды выбирают режим данных через аргумент EncodeOptions метода DrawQRCode, а Aztec-символы PDFlibPas несут флаг ECI 26 автоматически всякий раз, когда байты нагрузки — валидный UTF-8 хотя бы с одним не-ASCII символом
Для строки Müller маркер стоит два кодовых слова, а переход с 20×20 на 22×22 — с 10 мм до 11 мм при модулях 0,5 мм — вызван самими байтами UTF-8. Если в слоте этикетки есть этот лишний миллиметр, выставьте BarcodePayloadEncoding в bpeUTF8WithECI на экземпляре TPDFlib PDF-библиотеки PDFlibPas для Delphi прямо перед отрисовкой символа получателя и верните bpeSystemANSI для прочих, унаследованных символов на той же странице