PDF Library for Delphi scrie intervale de etichete de pagini cu AddPageLabels, iar din v3.539.10 apelul acela funcționează și pe fișiere încărcate al căror number tree /PageLabels e împărțit în noduri /Kids: rădăcina e aplatizată într-o singură frunză /Nums înainte să intre intervalul nou, ca eticheta să apară de fapt în vizualizator în loc să fie ignorată în tăcere. Victima tipică e un PDF în stil de carte provenit dintr-o unealtă de layout, cu cifre romane în paginile preliminare, numerotare arabă în corp și o anexă etichetat A-1, A-2, caz în care voiați să reetichetați doar anexa și nimic nu s-a schimbat
Ce sunt etichetele de pagini PDF și cum sunt stocate?
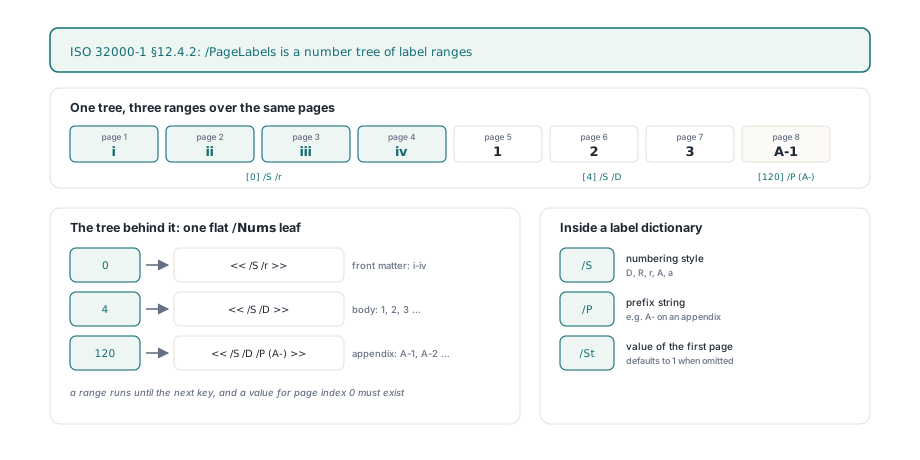
Etichetele de pagini sunt șirurile pe care un vizualizator le arată în caseta lui de pagini în locul indexului fizic de pagină, iar ISO 32000-1 §12.4.2 le stochează ca number tree sub cheia de catalog /PageLabels. Fiecare cheie e un index de pagină bazat pe zero care pornește un interval de etichetare, iar fiecare valoare e un dicționar de etichete de pagină cu cel mult trei intrări: /S pentru stilul de numerotare (D, R, r, A sau a), /P pentru un șir de prefix și /St pentru valoarea numerică a primei pagini din interval, care implicit e 1. Un interval rulează până la următoarea cheie, iar specificația cere ca arborele să conțină o valoare pentru indexul de pagină 0, deci fiecare pagină e acoperită de un interval
var
  Lib: TPDFlib;
begin
  Lib := TPDFlib.Create;
  try
    if Lib.LoadFromFile('handbook.pdf', '') <> 1 then
      Exit;
    // Paginile 1-4: i, ii, iii, iv (roman cu litere mici)
    Lib.AddPageLabels(1, 3, 1, '');
    // Paginile 5-120: 1, 2, 3 ... (zecimal)
    Lib.AddPageLabels(5, 1, 1, '');
    // Paginile 121 înainte: A-1, A-2 ... (zecimal cu prefix)
    Lib.AddPageLabels(121, 1, 1, 'A-');
    WriteLn(Lib.GetPageLabel(5));    // 1
    WriteLn(Lib.GetPageLabel(122));  // A-2
    Lib.SaveToFile('handbook-labeled.pdf');
  finally
    Lib.Free;
  end;
end;
TPDFlib.AddPageLabels(Start, Style, Offset, Prefix) își maphează argumentele pe acel dicționar fără surprize odată ce cunoașteți trei reguli. Start e bazat pe 1 ca orice alt argument de pagină din bibliotecă și e scris în arbore ca Start - 1. Style rulează de la 0 la 5, unde 0 înseamnă doar prefix, iar 1 până la 5 devin valori /S D, R, r, A și a; orice în afara intervalului întoarce 0 și nu atinge nimic. Offset devine /St doar când e mai mare decât zero, deci transmiterea lui 0 pur și simplu omite cheia și vizualizatorul revine la implicitul 1. Pentru că etichetele de pagini au sosit în PDF 1.3, apelul rulează și EnsureMinVersion('1.3', '/PageLabels'), care ridică versiunea de output a unui fișier mai vechi, cu excepția cazului în care ați blocat explicit versiunea de salvare
De ce dispar etichetele de pagini noi când arborele are /Kids?
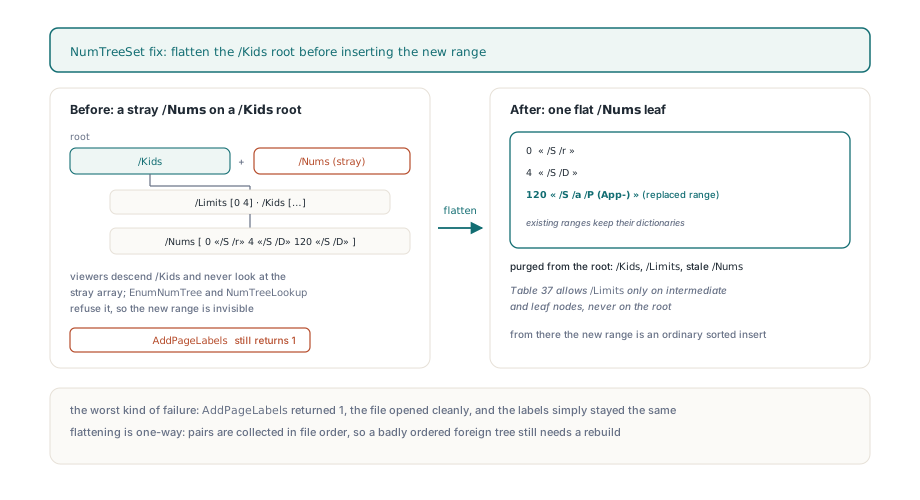
Etichetele noi dispar pentru că ISO 32000-1 §7.9.7 (Tabelul 37) face ca rădăcina unui number tree să care fie /Kids, fie /Nums, niciodată ambele, iar vechiul helper NumTreeSet știa doar să caute /Nums. Producătorii care emit documente lungi împart adesea arborele în noduri intermediare, fiecare cu o pereche /Limits, și îi atârnă de o rădăcină care are doar /Kids. Vechiul cod nu găsea niciun /Nums pe rădăcina aceea, crea unul proaspăt lângă /Kids-ul existent și inserea intervalul nou acolo. Rezultatul era o rădăcină cu două puncte de intrare mutual exclusive. Vizualizatoarele coboară prin /Kids și nu se uită niciodată la tabloul rătăcit, EnumNumTree al bibliotecii verifică și el /Kids primul, iar NumTreeLookup refuză un nod unde HasKids xor HasNums e fals. AddPageLabels întorcea în continuare 1, iar fișierul salvat se deschidea în continuare curat, ceea ce e cea mai rea specie de eșec: nimic nu se plânge, etichetele pur și simplu rămân aceleași
Reparația din NumTreeSet transformă rădăcina într-o frunză înainte să insereze ceva. Când rădăcina cară /Kids, EnumNumTree parcurge fiecare frunză în ordine și colecționează fiecare pereche cheie-valoare, se construiește un tablou plat /Nums nou din lista aceea, iar /Kids, /Limits și orice /Nums perimat sunt curățate din rădăcină înainte ca tabloul plat să fie atașat. Renunțarea la /Limits nu e cosmetică, căci Tabelul 37 permite acea intrare doar pe noduri intermediare și frunze, niciodată pe rădăcină. Din acel moment inserția e o inserție sortată obișnuită într-un singur tablou, iar intervalele existente supraviețuiesc cu dicționarele lor de etichete originale. Compromisul e deliberat: arborele nu e reconstruit în noduri /Kids echilibrate după aceea. Pentru etichete de pagini nu costă nimic, pentru că chiar și un manual de referință mare are rar mai mult de câteva zeci de intervale, iar o singură frunză e oricum ce scriu majoritatea producătorilor
// Reetichetarea anexei într-un fișier al cărui rădăcină /PageLabels folosește /Kids
if Lib.LoadFromFile('vendor-manual.pdf', '') = 1 then
begin
  WriteLn('Before: ', Lib.GetPageLabel(121));  // ex. A-1
  // Înlocuirea intervalului care începe la pagina 121: App-a, App-b ...
  if Lib.AddPageLabels(121, 5, 1, 'App-') = 1 then
    Lib.SaveToFile('vendor-manual-relabeled.pdf');
  // Intervalurile roman și zecimale existente sunt în continuare în frunza aplatizată
  WriteLn('After: ', Lib.GetPageLabel(121));   // App-a
  WriteLn('Front: ', Lib.GetPageLabel(2));     // ii, neschimbat
end;
Cum poate fi citit greșit un tablou /Nums ca fiind chei?
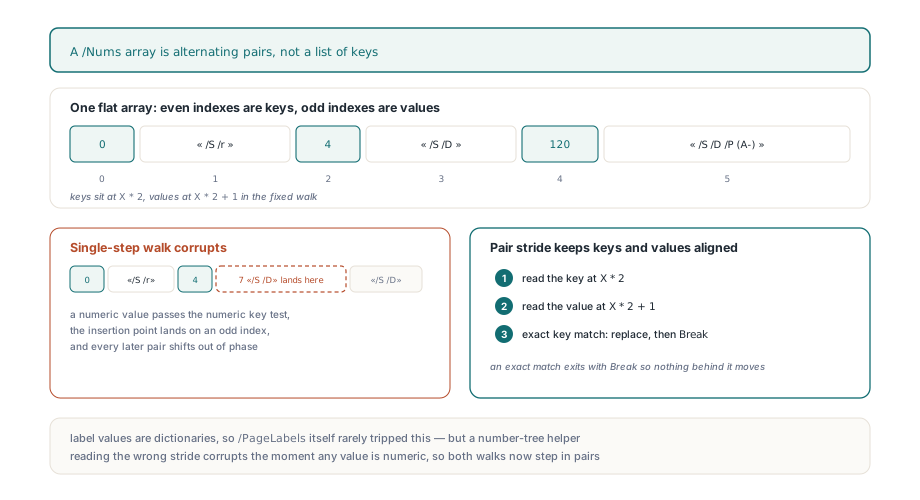
Un tablou /Nums e citit greșit când codul îl parcurge element cu element, pentru că tabloul e o secvență plată de perechi alternante, [key0 value0 key1 value1 ...], și doar pozițiile pare sunt chei. Vechiul loop din NumTreeSet testa fiecare element pentru tip numeric, deci o valoare care se întâmpla să fie un număr era comparată ca și cum ar fi fost o cheie; o potrivire de tip mai-mic putea muta punctul de inserție pe un index impar și putea lăsa perechea nouă în mijlocul uneia existente, scoțând din fază fiecare pereche ulterioară. EnumNumTree avea aceeași parcurgere în pas unic. Ambele iterează acum perechi cu pas de doi, citind cheia la X * 2 și valoarea la X * 2 + 1, iar o potrivire exactă de cheie înlocuiește valoarea și iese cu Break. Dreptate fie spusă, valorile etichetelor de pagini sunt dicționare, deci acest al doilea bug se declanșa rar pe /PageLabels însuși, dar un helper de number tree care citește pasul greșit e corupt în momentul în care orice valoare e numerică, și a fost reparat în aceeași trecere
Citirea etichetelor înapoi și dus-întorsul lor
TPDFlib.GetPageLabel(Page) întoarce eticheta pentru o pagină bazată pe 1 și are două fallback-uri care merită știute. Fără nicio intrare /PageLabels întoarce numărul zecimal al paginii, deci un apelant îl poate folosi necondiționat. Cu un arbore prezent dar fără interval care acoperă pagina întoarce un șir gol, exact ce se întâmplă când un fișier sare peste intrarea obligatorie de index 0; documentația de referință spune că un interval care pornește la pagina 1 trebuie să existe pentru ca etichetele să se afișeze corect, iar codul face cerința aceasta vizibilă. Stilurile cu litere urmează specificația, nu coloanele de spreadsheet: după Z vine AA, apoi BB, repetând litera în loc să reporte
var
  P: Integer;
  Data: WideString;
begin
  // Audit rapid al a ceea ce va arăta vizualizatorul în caseta lui de pagini
  for P := 1 to Lib.PageCount do
    WriteLn(P, ' -> ', Lib.GetPageLabel(P));

  // Valoarea de opțiune 4 exportă doar intervalele de etichete ca înregistrări PageLabelBegin
  Data := Lib.ExportDocumentData(4);
  // Importul le reia prin ClearPageLabels + AddPageLabels
  Lib.ImportDocumentData(Data, 0);
end;
Pentru editări în masă, ExportDocumentData cu valoarea de opțiune 4 scrie fiecare interval ca un bloc PageLabelBegin cu linii PageLabelNewIndex, PageLabelStart, PageLabelPrefix și PageLabelNumStyle, iar ImportDocumentData tratează prima înregistrare de etichetă pe care o vede ca o înlocuire completă: apelează ClearPageLabels o dată și apoi hrănește fiecare înregistrare spre AddPageLabels. Asta face un dus-întors de text determinist chiar și când fișierul original folosea un arbore /Kids, pentru că ștergerea scoate întreaga intrare de catalog, iar arborele reconstruit e o singură frunză de la început
Ce nu garantează încă reparația?
Aplatizarea e într-un singur sens și are încredere în ordinea pe care o găsește. EnumNumTree colecționează perechile în ordinea din fișier, iar GetPageLabel aplică ultimul interval a cărui cheie e mai mică sau egală cu indexul paginii, deci un fișier străin ale cărui frunze sunt dezordonate, interzis de §7.9.7 dar care circulă oricum, poate produce în continuare etichete greșite până când reconstruiți intervalele cu ClearPageLabels și apeluri AddPageLabels proaspete. Etichetele sunt legate de indici de pagină, nu de obiecte de pagină, deci orice operație care schimbă numărul de pagini sau ordinea lasă intervalele acolo unde erau. O schimbare în loc precum înlocuirea de pagini cu păstrarea numerelor de obiect păstrează numărul și, prin urmare, alinierea etichetelor, pe când o îmbinare precum interclasarea scanărilor duplex împletite produce o secvență nouă de pagini care merită un set de intervale scris de la zero
Apelurile de etichete de pagini, tratarea number tree și exportul și importul de date de document descrise aici se livrează în PDF Library for Delphi pentru Delphi, C++Builder și Lazarus, cu intrarea de referință pentru AddPageLabels care documentează valorile de stil și codurile de retur