CollateDocumentsEx din biblioteca PDF Delphi PDF Library for Delphi combină mai multe documente deschise într-un singur document intercalat. Adaugă câte GroupSize pagini din fiecare sursă la fiecare rundă, acceptă o listă de intervale de pagini per sursă și tratează un interval descrescător precum 3-1 ca pe o inversare a acelei surse. Un singur apel transformă un teanc cu fețe și un teanc cu verso inversat în ordinea corectă de citire
Scenariul din spatele acestui API este banal și extrem de comun. Un scaner cu alimentare pe coală, cu traseu simplex, procesează întregul teanc cu fața în jos, apoi operatorul întoarce teancul și îl procesează din nou. Rezultă două fișiere PDF: fețele în ordine, versourile în ordine inversă. Utilizatorul vrea un singur fișier: pagina 1 față, pagina 1 verso, pagina 2 față și așa mai departe. Acest articol tratează problema ordonării și capcana duplicării resurselor care stă dedesubt. Dacă interesul dumneavoastră este viteza brută de concatenare, consultați combinare rapidă de PDF-uri prin deplasare de referințe la nivel de octet; dacă intrările sunt prea mari pentru a încăpea în memorie, consultați combinarea și divizarea PDF-urilor de ordinul gigabyte-ilor cu acces direct
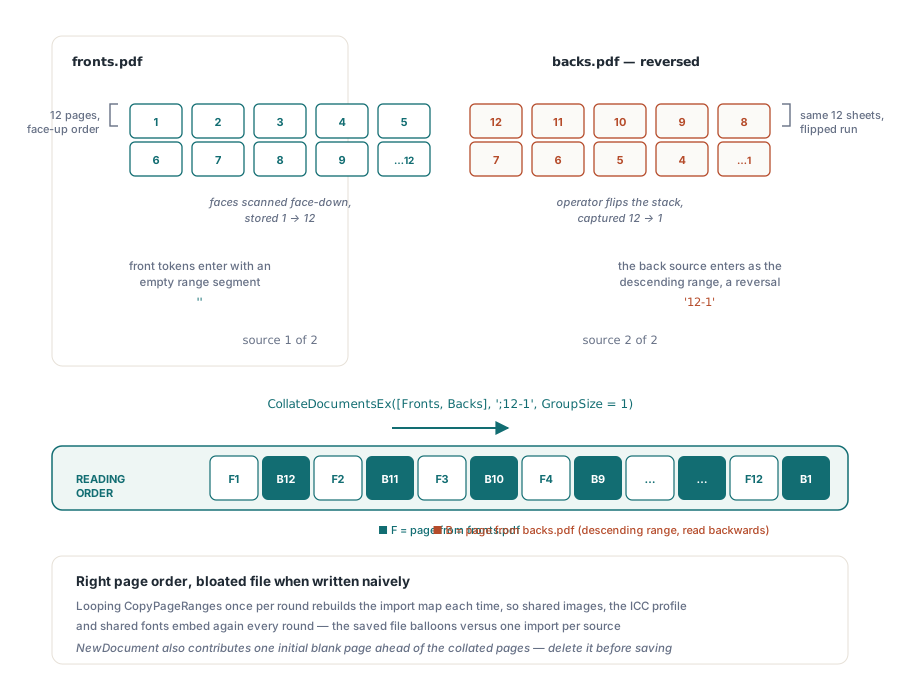
Scanerul produce două teancuri, unul dintre ele invers
Colaționarea nu este combinare. O combinare concatenează intervale de pagini; o colaționare le intercalează, iar tiparul de intercalare este o proprietate a dispozitivului fizic care a produs intrarea. Greșiți tiparul și fișierul nu este puțin greșit, ci ilizibil: fiecare a doua pagină aparține unei alte coli. Trei variabile descriu aproape orice caz real: câte surse sunt în rotație, câte pagini vin din fiecare sursă la fiecare rundă și dacă vreo sursă trebuie citită invers. CollateDocuments acoperă primele două cu un simplu array de handle-uri de documente și un întreg GroupSize. CollateDocumentsEx adaugă a treia acceptând o listă de intervale de pagini separate prin punct și virgulă, un segment per sursă, unde un segment gol înseamnă toate paginile acelei surse, iar un interval descrescător o inversează. Ambele funcții adaugă la finalul documentului selectat curent și returnează 1 la succes, 0 la orice respingere
De ce colaționarea naivă multiplică dimensiunea fișierului?
Pentru că harta de import care mapează numerele de obiecte sursă la numerele de obiecte țintă este reconstruită la fiecare apel de copiere, iar tot ce este accesibil din mai mult de un fragment este importat o dată per fragment. În interiorul PDF Library for Delphi, TPDFDocument.CopyPagesFromDoc resetează NewIndObjList la începutul fiecărei invocări. Acea listă este singura memorie pe care copiatorul o are despre ce a adus deja. Apelați-o o dată cu un interval de zece pagini și un font partajat de toate cele zece pagini este încorporat o singură dată. Apelați-o de zece ori câte o pagină și același font este încorporat de zece ori. Acest lucru contează mult mai mult pentru scanări decât pentru documente text, deoarece o pagină scanată este un singur XObject imagine mare, iar obiectele partajate sunt cele cu greutate reală: un profil ICC încorporat, un lanț /DecodeParms partajat, un XObject formular de ștampilă sau filigran aplicat pe fiecare coală, fontul stratului de text OCR. Modul evident de a scrie o colaționare round-robin este o buclă peste runde, iar acea buclă este exact cazul patologic
// Nu faceți așa. Fiecare apel CopyPageRanges reconstruiește harta de import,
// astfel încât tot ce cele două surse partajează intern este importat o dată
// per rundă în loc de o dată per sursă.
var
  RoundIndex: Integer;
begin
  for RoundIndex := 1 to 12 do
  begin
    PDF.CopyPageRanges(Fronts, IntToStr(RoundIndex));
    PDF.CopyPageRanges(Backs, IntToStr(13 - RoundIndex));
  end;
end;
Douăsprezece runde, două surse, douăzeci și patru de hărți de import. Nimic nu vă avertizează. Ordinea paginilor este corectă, fiecare pagină se randează, iar singurul simptom este un fișier de câteva ori mai mare decât suma intrărilor sale. La un job de 300 de pagini, multiplicatorul nu este o eroare de rotunjire, este diferența dintre o arhivă care încape în bugetul de retenție și una care nu încape
Importați o dată, apoi reordonați arborele de pagini
Soluția este separarea celor două preocupări pe care bucla naivă le fuzionase. Copierea decide ce obiecte există în țintă; ordonarea decide unde stau paginile în arborele de pagini. CollateDocumentsEx copiază fiecare sursă exact o dată, într-un singur apel CopyPagesFromDoc cu intervalul complet al acelei surse, astfel încât fiecare sursă primește o singură hartă de import, iar resursele partajate sunt scrise o singură dată. Abia după ce toate sursele au ajuns are loc intercalarea, iar aceasta se face în întregime prin TPDFPageTree.MovePage
Mutările de pagini sunt gratuite în sensul care contează aici. ISO 32000-1 §7.7.3 definește arborele de pagini ca o structură echilibrată de dicționare de noduri ale căror array-uri /Kids conțin referințe indirecte, cu /Count purtând totalul de frunze la fiecare nod. Relocarea unei pagini înseamnă eliminarea unei referințe indirecte dintr-un array /Kids, inserarea ei în altul, ajustarea ambelor valori /Count și repunctarea /Parent al paginii. Niciun flux de conținut nu este atins, nicio resursă nu este duplicată, niciun obiect nu este creat. Obiectul paginii își păstrează numărul de obiect, motiv pentru care numerele de obiecte rămân stabile la fel ca în înlocuirea de pagini care păstrează numerele de obiecte. Mai există un detaliu pe care o mutare naivă de pagină îl greșește și pe care MovePage nu îl greșește. ISO 32000-1 §7.7.3.4 permite ca /Resources, /MediaBox, /CropBox și /Rotate să fie moștenite de la un nod ancestral în loc să fie declarate pe pagină. O pagină care își moștenește resursele de la nodul A și este apoi mutată sub nodul B moștenește tacit altceva, sau nimic. MovePage rezolvă deci valoarea moștenită și o scrie în dicționarul paginii înainte de relocare, astfel încât pagina să își poarte propriile atribute peste mutare
Ce face de fapt trecerea de reordonare?
Rulează o sortare prin selecție față de semantica de inserare-la-poziție. Ordinea dorită, relativă la bloc, este calculată mai întâi: se parcurg sursele în rotație, se iau până la GroupSize indici din fiecare, se omite o sursă epuizată, se repetă până când fiecare pagină este plasată. Aceasta produce o permutare peste blocul adăugat. Aplicarea ei este partea dificilă, deoarece MovePage este o inserare, nu o interschimbare, astfel încât fiecare mutare deplasează cu unu tot ce se află între poziția veche și cea nouă
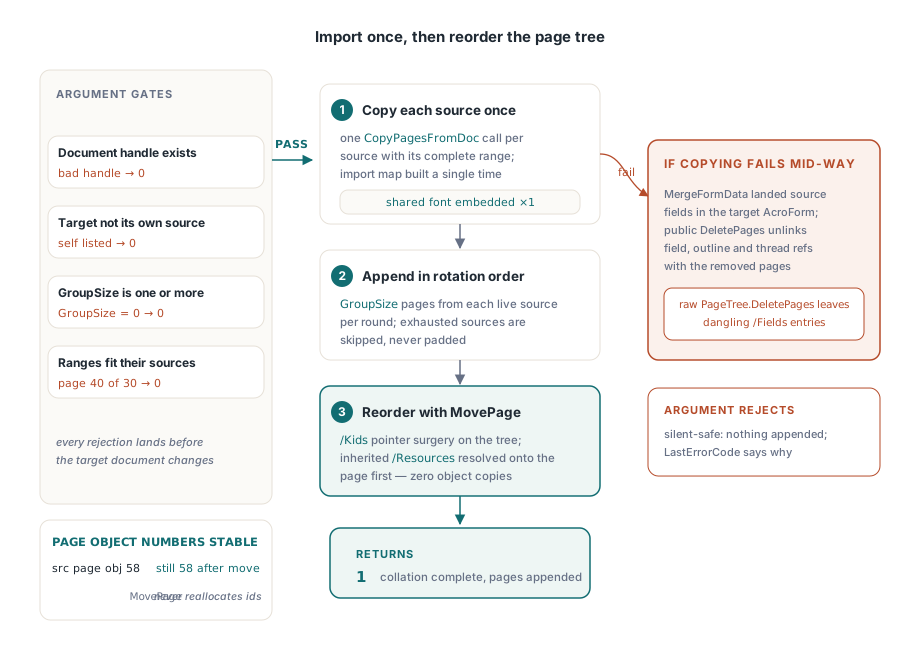
Implementarea păstrează un array Current care modelează unde se află în prezent fiecare pagină adăugată, scanează înainte de la poziția K pentru pagina care aparține la K, emite mutarea, apoi glisează intrările array-ului pentru a reflecta ce a făcut mutarea în arbore. Este O(n la pătrat) în operații pe array și zero în copii de obiecte, ceea ce este compromisul corect pentru această sarcină: o colaționare de 500 de pagini înseamnă un sfert de milion de rearanjări de întregi și niciun octet de date imagine duplicate. Intervalele descrescătoare și paginile repetate nu necesită tratament special în această trecere, deoarece PLParsePageRangeList este apelată cu sortarea dezactivată și duplicatele permise, astfel încât ordinea cerută supraviețuiește parsării intactă
Intervale inversate și combinarea duplex dintr-un singur apel
Cu inversarea exprimată ca interval, cazul cu două treceri prin scaner cu pat plat se restrânge la un singur apel. Fețele vor ordinea lor naturală, iar versourile vor 12-1, iar primul segment gol, înainte de punctul și virgula, spune că prima sursă contribuie cu toate paginile ei
var
  PDF: TPDFlib;
  Target, Fronts, Backs: Integer;
begin
  PDF := TPDFlib.Create;
  try
    Target := PDF.NewDocument;
    if PDF.LoadFromFile('fronts.pdf', '') <> 1 then
      Exit;
    Fronts := PDF.SelectedDocument;
    if PDF.LoadFromFile('backs.pdf', '') <> 1 then
      Exit;
    Backs := PDF.SelectedDocument;
    PDF.SelectDocument(Target);
    // fețele 1..12 în ordine, versourile scanate invers: F1 B12 F2 B11 ...
    if PDF.CollateDocumentsEx([Fronts, Backs], ';12-1', 1) = 1 then
      PDF.SaveToFile('duplex.pdf');
  finally
    PDF.Free;
  end;
end;
Merită menționate explicit două comportamente din acest fragment. Paginile colaționate sunt adăugate la documentul selectat, astfel încât un document creat cu NewDocument contribuie cu pagina sa albă inițială înaintea lor, iar dacă nu o doriți trebuie să o ștergeți. Iar sursele pot fi inegale: cu GroupSize 2 peste o sursă de trei pagini și una de cinci pagini, rundele ies A1 A2 B1 B2, apoi A3 B3 B4 odată ce A este aproape epuizată, apoi B5 singură, deoarece o sursă epuizată este pur și simplu omisă, nu completată cu pagini goale
Revenire, câmpuri de formular și ce nu vine odată cu ele
Fiecare argument este validat înainte ca ținta să fie atinsă. Un handle de document lipsă, documentul selectat listat ca propria sa sursă, un GroupSize sub unu, un număr de segmente care nu corespunde numărului de surse, un interval care numește o pagină pe care sursa nu o are: toate acestea returnează 0 cu ținta neschimbată. Eșecul în timpul copierii este cazul mai dificil și este tratat prin DeletePages public, nu prin PageTree.DeletePages brut. Motivul este specific. Copierea rulează cu MergeFormData activat, astfel încât câmpurile de formular ale sursei au fost deja adăugate la array-ul /AcroForm /Fields al țintei până când o sursă ulterioară eșuează. Ștergerea paginilor la nivelul arborelui de pagini ar elimina paginile cu widget-uri și ar lăsa acele referințe de câmpuri neconectate; calea publică deconectează referințele de câmp, de contur și de fir de articol odată cu paginile
if PDF.CollateDocumentsEx([Fronts, Backs], ';12-1', 1) = 0 then
  // Nimic nu a fost adăugat, iar ținta este identică octet cu octet cu starea anterioară.
  // 412 este eșecul de copiere; 0 înseamnă că argumentele au fost respinse
  // în timpul validării, înainte ca vreo pagină să fie atinsă.
  Log(Format('collate rejected, LastErrorCode=%d', [PDF.LastErrorCode]));
Fiți sinceri cu utilizatorii dumneavoastră privind limitele. Colaționarea transportă paginile, adnotările și câmpurile de formular ale acestora și combină lista de câmpuri AcroForm, array-ul ordinii de calcul și dicționarul resurselor implicite. Nu transportă semnele de carte ale sursei: arborele de contur al unui teanc de fețe scanate este aproape întotdeauna gol, așa că nimic nu se pierde în cazul duplex, dar dacă colaționați două documente elaborate, conturile lor rămân în urmă și trebuie să reconstruiți singuri navigarea. Destinațiile numite care există doar în catalogul sursei sunt în aceeași situație. Planificați acest lucru înainte de a promite unui client o colaționare fără pierderi
PDF Library for Delphi livrează funcțiile de colaționare împreună cu restul suprafeței sale de asamblare a paginilor, astfel încât fluxul de lucru al scanerului, extragerea pe bază de intervale și traseele pentru fișiere mari stau toate în spatele unei singure componente în Delphi și C++Builder. Referința completă a API-ului și o versiune de probă se află pe pagina de produs losLab Delphi PDF library