PDFlibPas, PDF Library for Delphi de la losLab, parcurge arborii de nume și de numere PDF cu un stack explicit și o mulțime de vizitate începând cu v3.539.45, astfel încât /Kids ciclice, copii partajați și arbori cu mii de niveluri adâncime nu mai epuizează call stack-ul și nu mai duplică intrări. Din v3.539.51 o pereche /Limits lipsă, malformată sau inversată nu mai ascunde niciodată o ramură care deține cheia. Destinațiile cu nume, etichetele de pagină, atașamentele și JavaScript-ul la nivel de document citesc toate prin aceste două căi de cod, ceea ce le face parte din suprafața de atac a oricărui PDF pe care nu l-ați produs singuri
Declanșatorul e rar exotic. Un fuzzer, un upload ostil sau un salvare incrementală buguită scrie o intrare /Kids care arată înapoi către un ancestor, iar un parcurgător recursiv moare cu stack overflow pe un fișier de doi kilobați. Eșecul mai liniștit e o căutare care are încredere într-un tablou /Limits stricat și raportează „negăsit” pentru o destinație care stă clar acolo
Unde apar arborii de nume și de numere într-un PDF?
Arborii de nume și de numere apar oriunde un PDF mapează o mulțime mare de chei către obiecte, iar PDFlibPas citește cel puțin patru dintre ei prin API-uri publice. ISO 32000-1 §7.9.6 definește arborele de nume (chei string, Tabelul 36) și §7.9.7 arborele de numere (chei întregi, Tabelul 37). Ambele sunt arbori cam echilibrați, a căror rădăcină și noduri intermediare cară /Kids, ale căror frunze cară perechile sortate cheie/valoare în /Names sau /Nums, iar nodurile non-rădăcină cară un tablou /Limits cu două elemente, cea mai mică și cea mai mare cheie de sub ele
| Arbore | Unde trăiește | Specificație | API de citire PDFlibPas |
|---|---|---|---|
| Destinații cu nume | /Dests în dicționarul de nume | §12.3.2.3 | GetNamedDestination, apoi GetDestPage / GetDestType |
| Etichete de pagină | /PageLabels în catalog (arbore de numere) | §12.4.2 | GetPageLabel |
| Atașamente | /EmbeddedFiles în dicționarul de nume | §7.7.4, §7.11.4 | EmbeddedFileCount, GetEmbeddedFileStrProperty |
| JavaScript la nivel de document | /JavaScript în dicționarul de nume | §7.7.4 | GlobalJavaScriptCount, GlobalJavaScriptPackageName |
Două detalii din tabelul acela sunt ușor de ratat. Destinațiile cu nume au și o formă mai veche din PDF 1.1, un dicționar /Dests simplu în catalog, cheiat de obiecte nume, iar GetNamedDestination verifică dicționarul acela primul, înainte să coboare în arborele de nume din PDF 1.2. Iar GetDocJavaScript nu e deloc un cititor de arbore de nume: el întoarce scripturile atașate declanșatorilor de document din dicționarul /AA al catalogului (WS, DS, WP, DP, DC), în timp ce pachetele de scripturi cu nume care rulează la deschiderea unui document trăiesc în arborele de nume /JavaScript
Fiecare octet din structurile acelea vine din fișier. Specificația spune ce trebuie să producă un scriitor; nu poate împiedica un cititor să primească altceva, ceea ce e aceeași lecție din spatele întăririi unui parser PDF Pascal contra fișierelor malițioase, aplicată aici la forma arborelui, nu la mărimile de buffere
De ce face un tablou /Kids ciclic ca un parcurgător recursiv de arbori să se blocheze?
Un tablou /Kids ciclic blochează un parcurgător recursiv pentru că nimic din recursie nu observă că a mai văzut un nod, deci un copil care își referențiază propriul ancestor transformă un fișier finit într-o coborâre infinită. Înainte de v3.539.45, NameTreeLookup, NumTreeLookup, EnumNumTree și TPDFNameTree.ProcessNode intern se apelau pe ei înșiși câte o dată per copil. O singură auto-referință era de ajuns să termine procesul, iar un arbore legitim, dar foarte adânc, putea face la fel fără vreun ciclu
O variantă mai blândă corupe rezultatele în loc să blocheze. Când două intrări /Kids referențiază aceeași frunză, o enumerare naivă o vizitează de două ori, iar un număr de atașamente sau o listă de pachete de scripturi raportează intrări care nu există
Repararea înlocuiește recursia cu un stack explicit last-in, first-out pe heap și o mulțime de vizitate cheiată după identitatea dicționarelor. Un nod e marcat când e scos din stivă, nu când e pus, deci o referință ciclică poate sta pe stivă pe scurt, dar e aruncată în momentul în care revine sus. Fiecare nod distinct își extinde copiii exact o dată, ceea ce marginilește munca totală la numărul de dicționare distincte plus lungimea totală a tablourilor lor /Kids. Adâncimea încetează să mai conteze: un lanț pe 4.096 de niveluri e doar 4.096 de iterații ale unei bucle și 4.096 de intrări într-un hash set
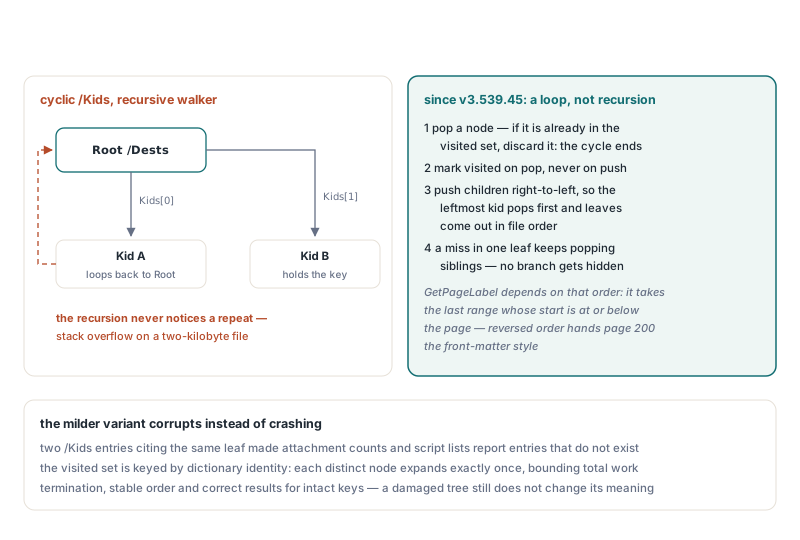
Ordinea contează totuși în continuare, iar stiva trebuie hrănită invers ca să o păstreze. Copiii sunt puși de la ultimul indice spre primul, deci cel mai din stânga copil e scos primul, iar frunzele ies în aceeași ordine de la stânga la dreapta în care le-a scris producer-ul. GetPageLabel depinde de asta: el parcurge fiecare interval enumerat și aplică ultimul al cărui indice de start e la sau sub pagină, deci inversarea enumerării i-ar da în tăcere paginii 200 stilul de materia preliminară. Scheletul de mai jos arată tiparul pe un tip de nod abstract, independent de orice model de obiecte PDF
uses
  System.Generics.Collections;

type
  TTreeNode = class
  public
    Kids: TArray<TTreeNode>;   // gol la o frunză
    Keys: TArray<string>;      // chei de frunză, sortate de un producer cumsecade
    Values: TArray<Integer>;   // paralel cu Keys
    HasLimits: Boolean;
    LoKey, HiKey: string;
  end;

// /Limits e un indiciu: doar o pereche bine formată și ordonată poate tăia o ramură
function LimitsExclude(Node: TTreeNode; const Key: string): Boolean;
begin
  Result := Node.HasLimits and (Node.LoKey <= Node.HiKey) and
    ((Key < Node.LoKey) or (Key > Node.HiKey));
end;

function FindValue(Root: TTreeNode; const Key: string;
  out Value: Integer): Boolean;
var
  Pending: TList<TTreeNode>;
  Visited: TDictionary<TTreeNode, Byte>;
  Node: TTreeNode;
  I: Integer;
begin
  Result := False;
  Value := 0;
  if Root = nil then
    Exit;
  Pending := TList<TTreeNode>.Create;
  Visited := TDictionary<TTreeNode, Byte>.Create;
  try
    Pending.Add(Root);
    while Pending.Count > 0 do
    begin
      Node := Pending[Pending.Count - 1];
      Pending.Delete(Pending.Count - 1);
      if Visited.ContainsKey(Node) then
        Continue;                      // ciclu sau copil partajat: deja văzut
      Visited.Add(Node, 0);
      if Length(Node.Kids) > 0 then
      begin
        // Push de la dreapta la stânga, astfel încât copilul cel mai din stânga iese primul
        for I := High(Node.Kids) downto 0 do
          if (Node.Kids[I] <> nil) and not LimitsExclude(Node.Kids[I], Key) then
            Pending.Add(Node.Kids[I]);
      end
      else
        for I := 0 to High(Node.Keys) do
          if (Node.Keys[I] = Key) and (I <= High(Node.Values)) then
          begin
            Value := Node.Values[I];
            Exit(True);
          end;
      // Un miss în frunza asta nu e o sentință: continuați să scoateți surori
    end;
  finally
    Visited.Free;
    Pending.Free;
  end;
end;
De ce nu poate o căutare să se oprească la prima ramură potrivită?
O căutare nu se poate opri la prima ramură al cărei interval se potrivește, pentru că intervalele /Limits dintr-un fișier real se pot suprapune sau pot minți, iar ramura care pretinde cheia nu e neapărat ramura care o deține. Căutările dinainte de v3.539.45 setau un flag Found pe primul copil al cărui /Limits acoperea cheia, coborau în el și nu mai priveau nicio altă soră. Dacă copilul acela se dovedea gol, învechit sau o buclă înapoi către rădăcină, răspunsul era nil, chiar când următoarea soră deținea cheia
FindTreeValue rescris, care stă acum în spatele ambelor NameTreeLookup și NumTreeLookup, pune fiecare copil al cărui interval nu exclude cheia și continuă să scoată din stivă până găsește o potrivire sau golește stiva. Un miss într-o frunză e doar un miss într-o frunză. Într-un arbore bine format nu costă nimic în plus; într-unul deteriorat costă câteva vizite de nod în plus și întoarce răspunsul corect
Căutarea în frunză urmează aceeași filozofie. ISO 32000-1 cere ca cheile dintr-un tablou /Names să fie sortate după valoarea de octet, deci frunza e căutată întâi cu o căutare binară. Dacă aceasta eșuează, PDFlibPas cade înapoi pe o scanare liniară a perechilor, pentru că o frunză dezordonată ar face altfel o cheie prezentă invizibilă. Sortarea e o cale rapidă, nu un filtru
Căutarea refuză de asemenea să ghicească la o singură contradicție structurală. Tabelul 36 lasă un nod să care ori /Kids ori /Names, niciodată ambele, iar calea de căutare tratează un nod care cară ambele ca malformat și îl sărite în loc să aleagă o interpretare. Căile de enumerare precum EnumNumTree sunt mai îngăduitoare și urmează /Kids când ambele sunt prezente
Pentru ce poate avea un cititor încredere în /Limits?
Un cititor poate avea încredere în /Limits doar pentru a sări muncă, niciodată pentru a decide că o cheie e absentă, și doar când perechea e bine formată. Tabelul 36 spune că nodurile intermediare și de frunză trebuie să care /Limits ca tablou cu două elemente, cea mai mică și cea mai mare cheie, dar în practică intrarea dispare după editări de mână, ține numere într-un arbore de nume sau vine cu marginile inversate. PDFlibPas v3.539.45 și v3.539.51 așază fiecare caz la fel: dacă intervalul nu poate fi citit ca o pereche ordonată de tipul corect, copilul rămâne căutabil
/Limitslipsă: vechea verificare de interval întorcea False și copilul era sărit de tot, deci un producer care uita intrarea își făcea tot subarborele de neatins. Din v3.539.45 copilul e căutat- Tip greșit sau lungime greșită, precum numere într-un arbore de nume sau un tablou cu un singur element: tratat exact ca o intrare lipsă din v3.539.45
- Margini inversate precum
[(Z) (A)]sau[9 0]: v3.539.45 le folosea în continuare, iar nicio cheie nu poate satisfaceLo <= Key <= HicândLo > Hi, deci ramura era exclusă pentru fiecare căutare. Din v3.539.51 un interval e folosit pentru tăiere doar când marginea lui de jos nu îl depășește pe cea de sus - Bine format, ordonat și corect: folosit pentru a sări ramura, ceea ce e chiar scopul intrării
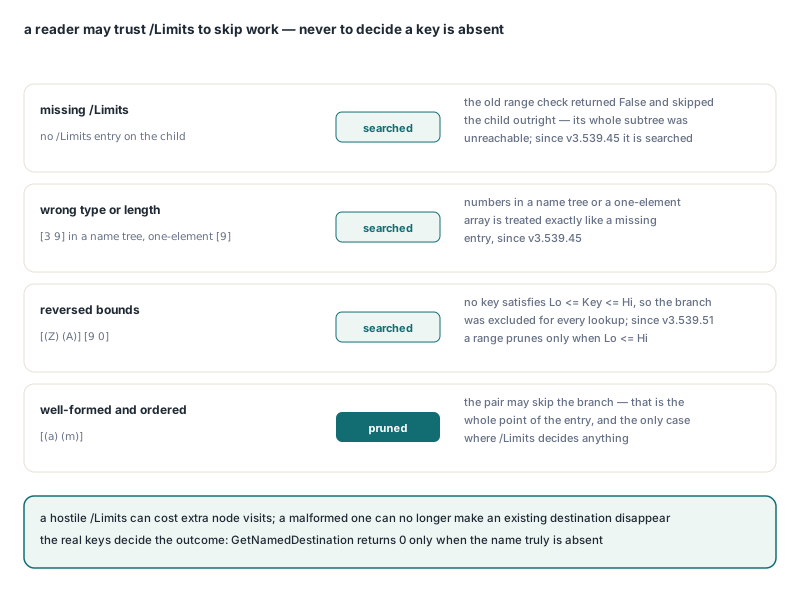
Cheile reale decid rezultatul în fiecare caz. Un /Limits ostil poate face ca PDFlibPas să viziteze mai multe noduri decât e necesar, dar unul malformat nu mai poate face o destinație existentă să dispară. Din partea apelantului nimic nu se schimbă: GetNamedDestination întoarce 0 când numele chiar e absent și un ID de destinație altfel, iar funcțiile de destinație pornesc de acolo
uses
  PDFlibrary;

procedure LookUpDestination(const FileName, DestName: string);
var
  Lib: TPDFlib;
  DestID: Integer;
begin
  Lib := TPDFlib.Create;
  try
    if Lib.LoadFromFile(FileName, '') <> 1 then
    begin
      WriteLn('Load failed, error ', Lib.LastErrorCode);
      Exit;
    end;
    // Catalogul /Dests (PDF 1.1) întâi, apoi arborele de nume /Dests
    DestID := Lib.GetNamedDestination(DestName);
    if DestID = 0 then
      WriteLn('No destination named ', DestName)
    else if Lib.GetDestPage(DestID) = 0 then
      WriteLn(DestName, ' exists but does not resolve to a page')
    else
      WriteLn(DestName, ' -> page ', Lib.GetDestPage(DestID),
        ', view type ', Lib.GetDestType(DestID));  // 1 = XYZ, 2 = Fit ...
  finally
    Lib.Free;
  end;
end;
Rulat contra unui fișier construit de mână, a cărui rădăcină /Dests are un copil care face buclă înapoi către rădăcină sub un interval [(a) (z)] și un al doilea copil care deține intrarea reală sub limite inversate [(z) (a)], procedura aceasta rezolvă destinația la pagina 2 cu tip de vedere 2 (Fit). Înainte de v3.539.45 aceeași căutare întorcea 0, pentru că copilul cu buclă pretindea cheia primul, iar căutarea nu ajungea niciodată la soră; singurul v3.539.45 întorcea în continuare 0, pentru că intervalul inversat excludea frunza reală. Dacă apoi citiți conturul care arată către aceste destinații, articolul însoțitor despre citirea acțiunilor de bookmark și adnotare PDF în Delphi acoperă partea de acțiuni
Cum a stricat o frunză cu 32.769 de nume TPDFNameTree?
O frunză cu 32.769 de perechi nume/valoare a stricat TPDFNameTree pentru că FindIndex intern împacheta două numere într-un singur Integer pe 32 de biți: poziția frunzei în lista internă de tablouri în cei 16 biți înalți și offset-ul intrării în interiorul tabloului /Names al frunzei în cei 16 biți joși. Fiecare pereche ocupă două sloturi de tablou, deci perechea cu numărul 32.769, indice de pereche 32.768, pornește la offset-ul 65.536, adică $10000. Valoarea aceea face carry în jumătatea înaltă, iar decoder-ul o citea înapoi ca offset 0 în frunza următoare
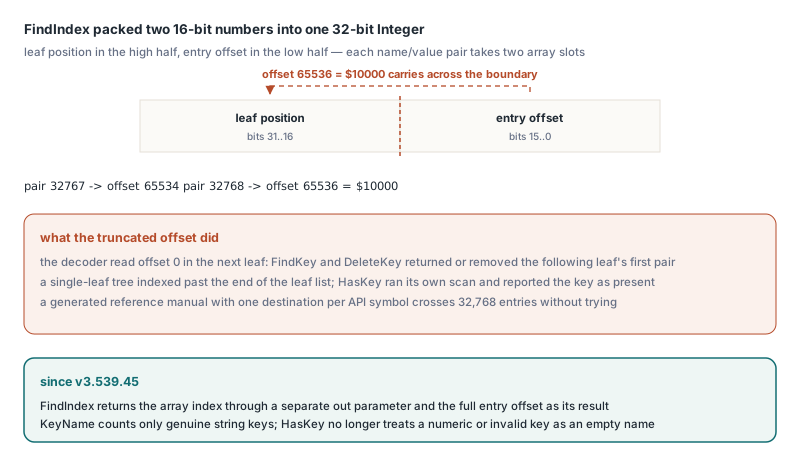
TPDFNameTree e clasa din spatele atașamentelor, pachetelor globale de JavaScript și a scrierilor de destinații cu nume, ceea ce face consecințele concrete. Într-un arbore cu o singură frunză nu există frunză următoare, deci FindKey și DeleteKey indexau dincolo de capătul listei de frunze; într-un arbore cu mai multe frunze întorceau sau ștergeau prima pereche a frunzei următoare în locul celei cerute. Între timp HasKey rula propria scanare și raporta cheia ca prezentă, deci clasa se contrazicea pe sine. Un manual de referință generat cu o destinație cu nume per simbol de API trece de 32.768 de intrări fără să forțeze, iar unii producători scriu toate acestea într-o singură frunză plată
Din v3.539.45, FindIndex întoarce indicele de tablou printr-un parametru out separat și offset-ul complet al intrării ca rezultat, deci nicio valoare nu mai e trunchiată. Aceeași versiune a strâns doi vecini. KeyName numără și întoarce acum doar chei string adevărate și întoarce un șir gol pentru un indice de 0 sau sub el, unde înainte făcea cast la orice obiect urma după o cheie invalidă. HasKey nu mai tratează o cheie numerică sau altfel invalidă ca nume gol. Pentru o frunză precum [(Valid) 42 123 456], HasKey('') e acum False, iar KeyName(2) întoarce un șir gol
procedure AuditTrees(const FileName: string);
var
  Lib: TPDFlib;
  I: Integer;
begin
  Lib := TPDFlib.Create;
  try
    if Lib.LoadFromFile(FileName, '') <> 1 then
      Exit;
    // Arbore de numere /PageLabels; fișierele fără unul întorc numere de pagină simple
    for I := 1 to Lib.PageCount do
      WriteLn('Page ', I, ' label: ', Lib.GetPageLabel(I));
    // Arbore de nume /EmbeddedFiles; indecșii pornesc de la 1, cheile non-string sunt sărite
    for I := 1 to Lib.EmbeddedFileCount do
      WriteLn('Attachment ', I, ': ', Lib.GetEmbeddedFileStrProperty(I, 1),
        ' (', Lib.GetEmbeddedFileStrProperty(I, 2), ')');  // nume, tip MIME
    // Arbore de nume /JavaScript: listează numele pachetelor, nu executa nimic
    for I := 1 to Lib.GlobalJavaScriptCount do
      WriteLn('Script package: ', Lib.GlobalJavaScriptPackageName(I));
  finally
    Lib.Free;
  end;
end;
Pe același fișier construit de mână, a cărui rădăcină /PageLabels listează o frunză de două ori și se referențiază pe sine, acest audit tipărește i și A-1 pentru cele două pagini, fiecare interval câte o dată, și singurul pachet de scripturi dintr-un arbore /JavaScript care de asemenea arată înapoi către propria rădăcină. Partea de scriere a etichetelor de pagină are propria ei istorie cu rădăcini /Kids, acoperită în repararea etichetelor de pagină PDF stocate în arbori de numere /Kids; AddPageLabels aplatizează o asemenea rădăcină înainte de inserare și se sprijină pe aceeași enumerare EnumNumTree descrisă aici
Ce nu garantează totuși această întărire?
Întărirea garantează terminarea, ordinea stabilă și rezultate corecte pentru arborii ale căror chei reale sunt intacte; nu face un arbore deteriorat să însemne ce și-a intenționat autorul lui. Câteva limite merită cunoscute înainte să construiți pe ea
- Mulțimea de vizitate lucrează după identitatea de obiect. Două dicționare distincte cu conținut identic sunt două noduri, deci un producer care copiază o frunză în loc să o referențieze produce tot intrări duplicate
- Un
/Limitsbine format, ordonat, dar greșit, taie în continuare. Un cititor care folosește intervalele ca optimizare nu poate fi și imun la un interval care minte plauzibil; singura alternativă e să ignore/Limitsde tot și să scaneze fiecare frunză - Enumerarea păstrează ordinea fișierului, dar nu sortează.
GetPageLabelaplică ultimul interval enumerat la sau sub pagină, deci un producer care scrie intervalele dezordonat primește semantică de ordine a fișierului - Memoria crește cu numărul de noduri și intrări distincte. Parcurgerea adaugă o listă și un hash set, nimic mai mult, dar un arbore de nume de 100 MB rămâne un arbore de nume de 100 MB și după parsare
- Cheile duplicate în interiorul unei frunze nu sunt raportate. Căutarea binară întoarce perechea potrivită pe care o lovește prima; fallback-ul liniar păstrează ultima potrivire scanată
Referință rapidă: citirea arborilor PDF din fișiere nesigure
- Faceți upgrade la v3.539.45 sau mai nou pentru parcurgere sigură la cicluri și la stack a arborilor de nume și de numere, și la v3.539.51 sau mai nou astfel încât
/Limitsinversate să nu mai ascundă chei - Tratați
GetNamedDestinationîntorcând 0 ca „absent”, iarGetDestPageîntorcând 0 ca „prezent, dar nefolosibil” - Folosiți
GlobalJavaScriptCountșiGlobalJavaScriptPackageNamepentru arborele de nume/JavaScript;GetDocJavaScriptcitește în schimb declanșatorii/AAdin catalog - Indexați atașamentele și pachetele de scripturi de la 1 până la numărul raportat de bibliotecă; cheile invalide nu sunt numărate
- În codul propriu de arbori, marcați nodurile ca vizitate la pop, puneți copiii invers și lăsați
/Limitssă taie doar când e o pereche de tip corect și ordonată
Uneltele de pre-flight, arhivatoarele și viewer-ele citesc acești arbori înainte ca orice pagină să fie randată, deci trebuie să supraviețuiască oricărei plante care ajunge într-o coadă de upload. Cititorii de arbori descriși mai sus vin cu PDFlibPas, PDF Library for Delphi, care se compilează și cu Delphi, și cu Free Pascal