Retire as descrições de página e fica-lhe uma fina camada de estrutura que ninguém imprime mas de que todos os leitores, indexadores e sistemas de arquivo dependem. Um objeto de página nada sabe sobre o capítulo a que pertence, sobre o autor que o escreveu, ou sobre a nota de rodapé que remete para outro sítio. Esse conhecimento vive um nível acima, em três estruturas ligadas ao catálogo do documento: os fluxos de metadados, a árvore de marcadores e os vetores de anotações por página. Partilham um traço que as torna fáceis de estragar. Nenhuma deixa marcas visíveis na página, pelo que um ficheiro pode renderizar na perfeição e ainda assim estar sem os seus marcadores, contradizer o seu próprio campo de autor, ou apontar uma ligação para um objeto de página que já não existe
Esta é a camada que uma biblioteca de PDF expõe como propriedades do documento, APIs de marcadores e chamadas de ligações ou anotações, e a camada que um rastreador de pesquisa lê para decidir de que trata o seu documento. O modelo de objetos por baixo dela está coberto no percurso pela estrutura de um documento PDF. Aqui o foco está estritamente no que pende do catálogo
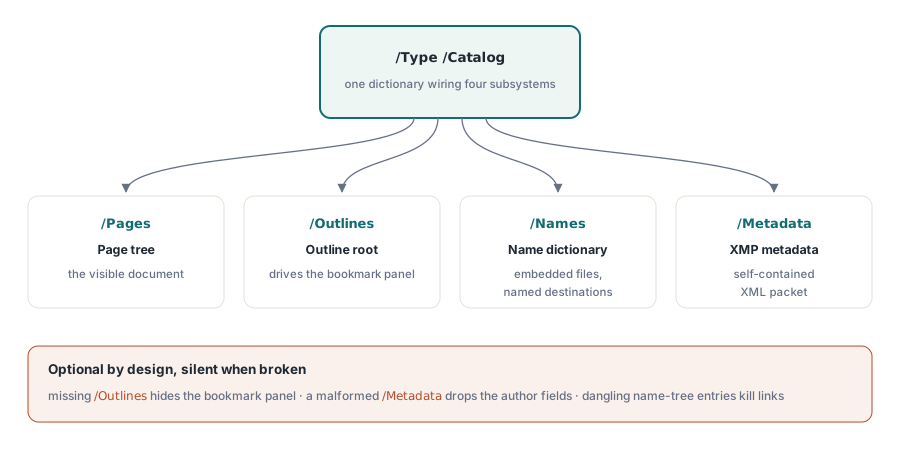
As três estruturas ligam-se todas ao catálogo. Um catálogo completo que as una tem este aspeto:
1 0 obj
<< /Type /Catalog
   /Pages 2 0 R
   /Outlines 3 0 R
   /Names << /EmbeddedFiles 4 0 R >>
   /Metadata 5 0 R
>>
endobj
Quatro entradas, quatro subsistemas independentes. /Pages é o documento visível; /Outlines é a árvore de marcadores; /Metadata aponta para o fluxo XMP; /Names alcança o dicionário de nomes de âmbito documental, que entre outras coisas guarda os anexos de ficheiros incorporados. Cada um é opcional, e um leitor que não encontre nenhum deles mostra na mesma as páginas. Essa opcionalidade é precisamente a razão pela qual a camada de navegação é a primeira coisa a apodrecer quando um ficheiro é editado por ferramentas que só entendem páginas
Dois arquivos de metadados que se contradizem
O PDF transporta metadados de documento em dois sítios ao mesmo tempo, e o sarilho começa quando dizem coisas diferentes. O mecanismo original é o dicionário de informação do documento, referenciado por /Info no trailer: um conjunto plano de pares chave-valor para /Title, /Author, /Subject, /Keywords, /Creator, /Producer e as duas datas. É simples e todos os visualizadores o leem. O PDF 2.0 descontinua a maior parte dele a favor do segundo mecanismo, o fluxo de metadados XMP
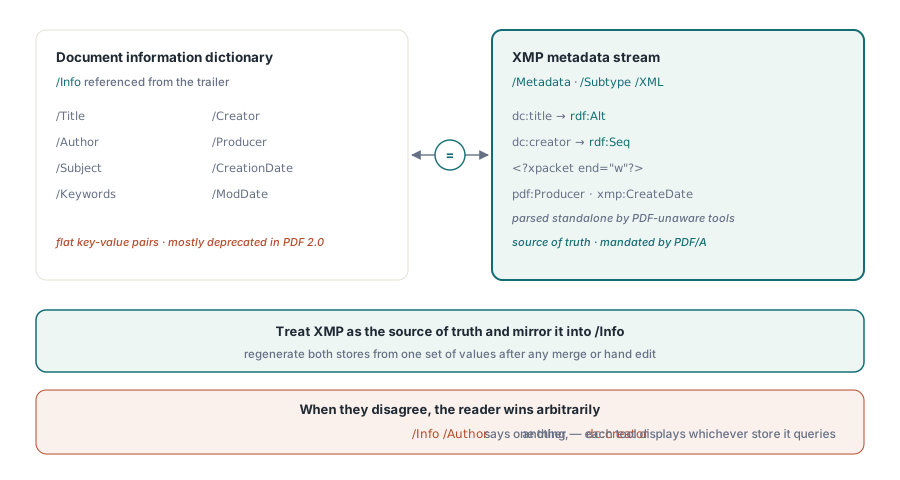
O XMP é um documento XML autónomo, escrito em RDF, guardado como um fluxo que o catálogo alcança através de /Metadata e marcado /Type /Metadata /Subtype /XML. Ao contrário do dicionário Info, enterrado dentro da estrutura de objetos do PDF, um pacote XMP foi concebido para ser extraído e analisado por si só por ferramentas que nada sabem sobre PDF. Eis um pacote representativo:
5 0 obj
<< /Type /Metadata /Subtype /XML /Length 1235 >>
stream
<?xpacket begin="" id="W5M0MpCehiHzreSzNTczkc9d"?>
<x:xmpmeta xmlns:x="adobe:ns:meta/">
  <rdf:RDF xmlns:rdf="http://www.w3.org/1999/02/22-rdf-syntax-ns#">
    <rdf:Description rdf:about=""
        xmlns:dc="http://purl.org/dc/elements/1.1/"
        xmlns:xmp="http://ns.adobe.com/xap/1.0/"
        xmlns:pdf="http://ns.adobe.com/pdf/1.3/">
      <dc:title><rdf:Alt><rdf:li xml:lang="x-default">Quarterly Report</rdf:li></rdf:Alt></dc:title>
      <dc:creator><rdf:Seq><rdf:li>A. Author</rdf:li></rdf:Seq></dc:creator>
      <xmp:CreateDate>2026-06-16T10:46:27+08:00</xmp:CreateDate>
      <xmp:CreatorTool>Reporting Service 4.2</xmp:CreatorTool>
      <pdf:Producer>losLab PDF Library</pdf:Producer>
    </rdf:Description>
  </rdf:RDF>
</x:xmpmeta>
<?xpacket end="w"?>
endstream
endobj
Três pormenores desse bloco decidem se os metadados sobrevivem ao contacto com ferramentas reais. As instruções de processamento xpacket não são decoração: emolduram o pacote para que um extrator o consiga encontrar dentro de um fluxo de bytes maior, e um escritor que omita o <?xpacket end="w"?> final produz um ficheiro que abre bem mas tropeça em validadores estritos. Os tipos de dados das propriedades também importam. dc:title é uma alternativa de idioma envolvida em rdf:Alt, enquanto dc:creator é uma lista ordenada e leva rdf:Seq; emitir qualquer um deles como simples nó de texto é o erro de XMP mais comum de todos, tolerado pela maioria dos visualizadores até chegar aquele que não o tolera. Os prefixos de espaço de nomes são convencionais, mas os URIs a que se ligam são normativos: um analisador guia-se pelo URI, não pelo prefixo
A regra dura com dois arquivos é que têm de concordar. Se /Info diz que o autor é uma pessoa e dc:creator nomeia outra, expediu um documento que responde à mesma pergunta de duas maneiras, e qual das respostas vence depende do campo que a ferramenta consumidora ler. Uma biblioteca costuma escrever ambos por si, mas no momento em que edita um à mão, ou funde ficheiros de geradores diferentes, os dois afastam-se. Trate o dicionário Info como compatibilidade herdada e o XMP como fonte de verdade, e regenere ambos a partir de um único conjunto de valores em vez de os remendar em separado. Para o PDF/A isto torna-se um requisito de conformidade: a norma ISO 19005 obriga ao XMP e proíbe qualquer propriedade Info que contradiga a sua equivalente em XMP
A árvore de marcadores por detrás do painel de bookmarks
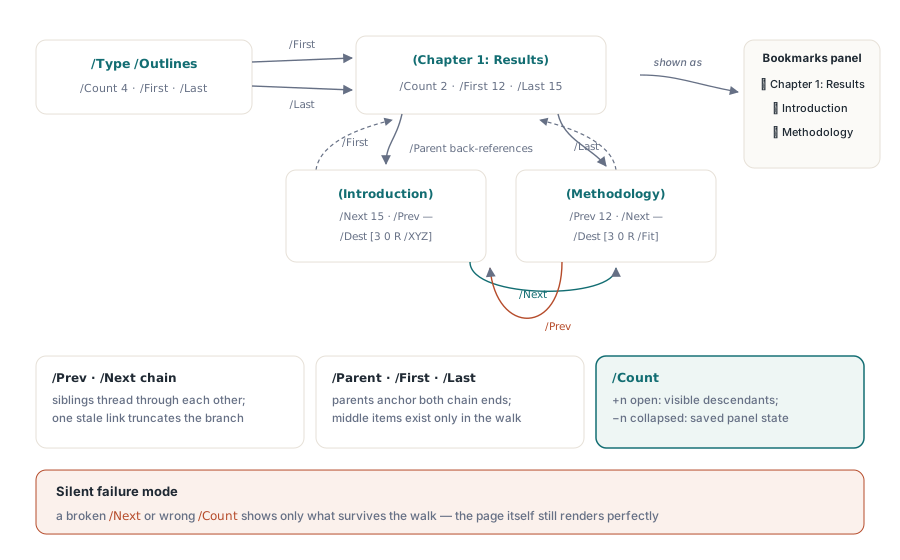
O que um visualizador mostra como painel de marcadores é, no ficheiro, uma árvore de dicionários duplamente ligada chamada estrutura de tópicos do documento. O catálogo aponta para um dicionário de raiz através de /Outlines; a raiz aponta para o seu primeiro e último item de topo; e cada item está enfiado aos seus vizinhos e ao seu pai. Não há vetor de marcadores em sítio nenhum. A estrutura inteira é reconstruída seguindo referências, que é precisamente a razão pela qual uma única ligação partida consegue fazer desaparecer do painel um ramo inteiro sem qualquer erro
8 0 obj                                    % a raiz da estrutura de tópicos
<< /Type /Outlines /Count 4 /First 9 0 R /Last 9 0 R >>
endobj
9 0 obj                                    % nível de topo: um capítulo
<< /Title (Chapter 1: Results)
   /Parent 8 0 R /Count 2
   /First 12 0 R /Last 15 0 R >>
endobj
12 0 obj                                   % primeiro filho
<< /Title (Introduction)
   /Parent 9 0 R /Next 15 0 R
   /Dest [3 0 R /XYZ 72 720 0] >>
endobj
15 0 obj                                   % segundo filho, último irmão
<< /Title (Methodology)
   /Parent 9 0 R /Prev 12 0 R
   /Dest [3 0 R /Fit] >>
endobj
Leia as ligações e as invariantes tornam-se óbvias. Cada item aponta de volta para o seu /Parent. Os irmãos formam uma cadeia através de /Prev e /Next, o primeiro item omitindo /Prev e o último omitindo /Next. Um pai nomeia o primeiro e o último filho através de /First e /Last, e os filhos pelo meio só são alcançáveis percorrendo a cadeia de irmãos. Erre num deles e a falha é silenciosa: um /Next desatualizado trunca um capítulo, um pai cujo /Last não termina a cadeia deixa itens órfãos, e o visualizador apresenta o que conseguir alcançar
O campo /Count transporta um pedaço de estado que apanha as pessoas de surpresa. Na raiz e em qualquer item expandido guarda o número de descendentes atualmente visíveis; num item recolhido é um número negativo cuja magnitude é quantos descendentes apareceriam ao expandir. Ou seja, /Count não é um facto estrutural fixo sobre a árvore, é o estado aberto ou fechado do painel tal como foi gravado, e um gerador que o fixe no código como um total positivo reabre todos os ramos que o autor quis deixar fechados
Cada item ganha o seu lugar por apontar para algum sítio. O /Title é o que o painel mostra; o /Dest é onde um clique aterra. Um destino pode estar embutido no item, como acima, ou ser um nome que se resolve através do dicionário de nomes do documento, que é a melhor escolha quando muitos marcadores e ligações visam os mesmos pontos, porque corrige num só sítio um alvo que se deslocou. Uma biblioteca esconde geralmente esta árvore por trás de um identificador da raiz de tópicos e de métodos que acrescentam entradas filhas; no HotPDF o documento expõe um OutlineRoot do tipo THPDFDocOutlineObject e enfia por si as ligações /Prev, /Next, /Parent e /Count à medida que acrescenta itens. Vale a pena tirar partido disso, porque manter essas invariantes à mão ao longo das edições é onde as estruturas de tópicos se partem
Destinos: a gramática de para onde vai um clique
Tanto os marcadores como as anotações de ligação apontam para destinos, e um destino é mais do que um número de página. É um vetor que nomeia um objeto de página e depois especifica, através de um verbo na segunda posição, como o visualizador o deve enquadrar. O mais comum e o mais mal utilizado é /XYZ, da forma [page /XYZ left top zoom]. Os seus três operandos são independentes, e qualquer um pode ser null para significar "deixe isto como o leitor o tinha". Assim, [page /XYZ null null null] salta para a página sem mexer na posição de deslocamento nem no nível de ampliação, normalmente o que se pretende de uma ligação do tipo "ir para a página". Os números estão no espaço de utilizador por omissão, medidos a partir do canto inferior esquerdo com o y a crescer para cima, o mesmo sistema de coordenadas que o conteúdo da página usa. Os autores que chegam da disposição de ecrã medem por reflexo a partir do topo e enviam o leitor para o extremo errado da página
A família /Fit troca o posicionamento preciso por resiliência. [page /Fit] dimensiona a página inteira dentro da janela, [page /FitH top] ajusta à largura da página com um dado limite superior, e [page /FitR l b r t] amplia um retângulo até preencher a vista. Como estes calculam a escala a partir da geometria da página em vez de coordenadas fixas, um destino /Fit continua a fazer o mais sensato depois de a página ser redimensionada, ao passo que um destino /XYZ com uma ampliação fixada pode deixar o leitor a olhar para a margem. Para um índice, /FitH com a coordenada superior da secção envelhece melhor do que /XYZ com uma ampliação adivinhada
Anotações: tudo o que é interativo e não é conteúdo da página
Uma anotação é um objeto que se sobrepõe à página sem fazer parte do seu fluxo de conteúdo. Ligações, notas autocolantes, realces, widgets de formulário, ícones de ficheiro anexado, carimbos: são todos anotações, listadas no vetor /Annots da página onde assentam. Remover uma anotação desse vetor remove-a da página, embora o conteúdo subjacente fique intocado. É esse o objetivo: as anotações são uma camada de edição, separada das marcas sobre as quais assentam
Todas as anotações partilham uma pequena espinha dorsal. /Subtype nomeia o tipo, /Rect dá a sua caixa delimitadora em coordenadas de página, e /Contents guarda texto que serve também de descrição acessível. A anotação de ligação é o caso que vale a pena estudar, porque surge em duas formas: um destino simples, e uma ação
12 0 obj                                    % ligação para um destino
<< /Type /Annot /Subtype /Link
   /Rect [100 200 300 250]
   /Border [0 0 0]
   /Dest [5 0 R /XYZ null null null] >>
endobj
13 0 obj                                    % ligação que executa uma ação
<< /Type /Annot /Subtype /Link
   /Rect [50 50 200 100]
   /Border [0 0 0]
   /A << /Type /Action /S /URI /URI (https://www.example.com) >> >>
endobj
O /Rect é uma zona ativa; clicar dentro dela envia o leitor para o destino, reutilizando a mesma gramática que a estrutura de tópicos usa. O /Border [0 0 0] está a fazer trabalho a sério, suprimindo o feio retângulo por omissão que os visualizadores desenham à volta das ligações. A segunda forma troca o /Dest simples por uma ação /A, cujo subtipo /S seleciona o comportamento: /GoTo dentro deste ficheiro, /GoToR para outro ficheiro, /URI para um endereço web, /Launch para executar um programa externo. Este último merece desconfiança. Um /Launch que arranca um executável é o comportamento que torna os PDF um vetor de malware, pelo que os visualizadores conformes o bloqueiam ou avisam em alto e bom som e a ligação falha para a maioria dos leitores. Recorra a /URI e a /GoTo e deixe o /Launch em paz
As anotações de marcação, como realces e notas autocolantes, e as anotações de forma, como /Square, acrescentam uma dobra: o seu aspeto no ecrã não decorre do seu tipo. Um visualizador apresenta a sua própria versão a não ser que fixe a aparência com um fluxo de aparência, a entrada /AP, que referencia um XObject de formulário com os operadores de desenho. Salte-o e o mesmo realce pode ficar diferente em dois leitores, ou antes e depois de uma ida e volta por um editor. Para tudo aquilo cujo aspeto exato faz parte do documento, forneça o /AP. Já agora, os ficheiros anexados reutilizam esta mesma maquinaria: um fluxo de ficheiro incorporado e um dicionário de especificação de ficheiro, expostos ou como anotação /FileAttachment ou através da árvore de nomes /EmbeddedFiles sob o /Names do catálogo
Onde esta camada se parte, e como apanhá-lo
A falha recorrente em tudo isto é a referência pendente. Os marcadores deixam de aparecer quando o catálogo não tem entrada /Outlines ou quando uma cadeia de irmãos se parte a meio da árvore; os metadados são ignorados quando ao fluxo XMP falta a marcação /Type /Metadata /Subtype /XML ou o invólucro xpacket está malformado. Em todos os casos o conteúdo das páginas está bem, pelo que uma abertura descuidada parece correta e o defeito só aflora no painel que ninguém verificou
Dois hábitos baratos apanham a maior parte disto. Abra o ficheiro terminado num visualizador a sério e percorra a clicar o painel de marcadores e uma amostra das ligações, o que exercita o grafo de referências da mesma forma que um leitor o fará. Depois volte a ler os metadados com uma ferramenta separada e confirme que o dicionário Info e o XMP concordam, a única discordância que nenhuma quantidade de cliques revela. Gere esta camada através de uma biblioteca que trate da contabilidade das ligações e a maior parte destas armadilhas nunca se abre. O HotPDF Delphi Component para Delphi e C++Builder expõe as estruturas de tópicos, de anotações e de metadados através de APIs ao nível do documento, pelo que descreve a hierarquia de marcadores e as ligações e deixa que ele enfie as referências. Para o modelo de objetos a que estas estruturas se ligam, a visão técnica geral da estrutura de um ficheiro PDF cobre o catálogo e a tabela de referências cruzadas de que dependem