Um ficheiro PDF é, no fundo, uma coleção de objetos que apontam uns para os outros. Retirando a compressão, a contabilidade de referências cruzadas e os deslocamentos de bytes, o que resta é um grafo: um pequeno conjunto de valores tipados, ligados entre si por referências, com raiz num único objeto que o leitor sabe como encontrar. Tudo o que um PDF consegue exprimir, desde um parágrafo de texto até um tipo de letra incorporado ou uma assinatura digital, é construído a partir de oito tipos de objeto primitivos e da regra que permite que um objeto se refira a outro. Uma vez aprendidos esses tipos, o resto do formato lê-se como composição, e não como mistério
Esta é a camada lógica do PDF, definida na cláusula 7.3 da ISO 32000-1, e situa-se um nível acima do layout físico do ficheiro (o cabeçalho, o corpo, a tabela de referência cruzada e o trailer, que é assunto à parte na visão geral técnica da estrutura de ficheiro PDF). O modelo lógico é o que esses bytes significam depois de analisados. Um visualizador lê o ficheiro de trás para a frente para encontrar o trailer, segue-o até à raiz, e a partir daí o documento desdobra-se em objetos que referenciam objetos. É esta a parte sobre a qual se raciocina ao depurar uma página malformada, ao escrever um parser, ou ao confiar numa biblioteca para montar um documento
Oito tipos de objeto, e nada mais
O PDF define exatamente oito tipos de objeto básicos. Todos os valores num documento são um deles, o que é o que mantém o formato tratável apesar do seu alcance
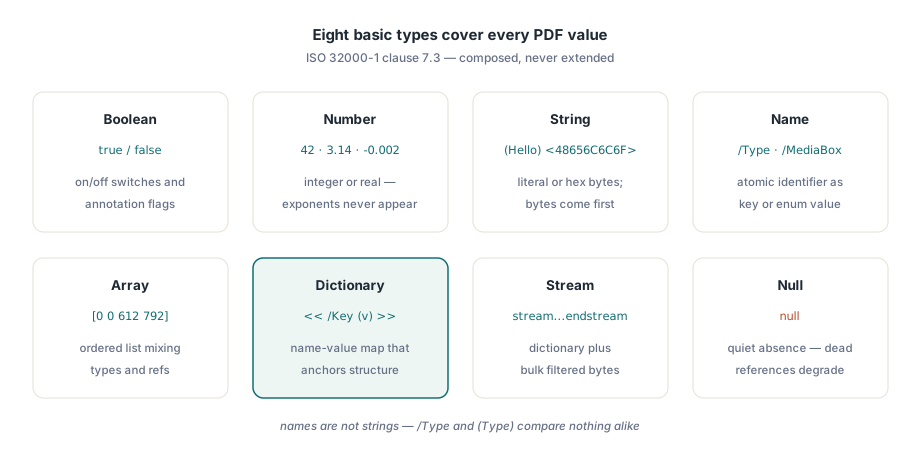
Booleanos são as palavras-chave true e false. Servem para ligar e desligar flags, como se uma anotação é impressa ou não
Números surgem em duas variantes que a especificação trata como um único tipo: inteiros como 42 e reais como 3.14 ou -0.002. O PDF não tem notação de expoente, pelo que nunca aparece 1e6 num ficheiro conforme. Coordenadas, tamanhos de tipo de letra e ângulos de rotação são todos números
Strings guardam sequências de bytes, escritas entre parênteses, (Hello), ou entre parênteses angulares em hexadecimal, <48656C6C6F>. Ambas as notações codificam o mesmo conteúdo; o hexadecimal é a válvula de escape para bytes incómodos dentro de parênteses. As strings transportam texto, mas são bytes antes de tudo, o que passa a importar assim que se lida com algo além de ASCII
Nomes são tokens atómicos introduzidos por uma barra: /Type, /Pages, /MediaBox. Um nome não é uma string; é um identificador, usado como chave de dicionário ou como valor enumerado, e dois nomes só são iguais se corresponderem byte a byte. A barra é sintaxe, não faz parte do nome. Isto costuma confundir quem começa e trata /Times-Roman e a string (Times-Roman) como equivalentes; o formato não os trata assim
Arrays são listas ordenadas e heterogéneas entre parênteses retos: [0 0 612 792] é um retângulo de página, e um array pode misturar tipos livremente, incluindo referências a outros objetos. Os Dicionários são o cavalo de batalha do formato. Escritos entre << e >>, um dicionário mapeia chaves de nome para valores de qualquer tipo, e quase todas as estruturas com significado em PDF, página, catálogo, tipo de letra, anotação, são um dicionário com uma chave /Type a declarar o que são
Streams são dicionários com uma cauda de bytes em bruto entre as palavras-chave stream e endstream. O dicionário descreve os bytes (o seu comprimento, e quaisquer filtros como o FlateDecode que os comprimam), e os bytes transportam o payload volumoso: instruções de conteúdo de página, programas de tipo de letra incorporados, imagens. Uma stream é onde o PDF coloca tudo o que é demasiado grande ou demasiado binário para ficar inline
O oitavo tipo é o objeto nulo, a palavra-chave null. É um valor real, distinto de uma chave estar ausente. Uma entrada de dicionário definida como null é tratada como se não estivesse presente, e uma referência que resolve para um objeto inexistente também produz null em vez de um erro. Esse comportamento tolerante é deliberado: permite que um ficheiro danificado se degrade em vez de recusar abrir. Não existe um nono tipo; tudo o que o PDF exprime resulta de como estes oito se combinam
Valores diretos, objetos indiretos e referências
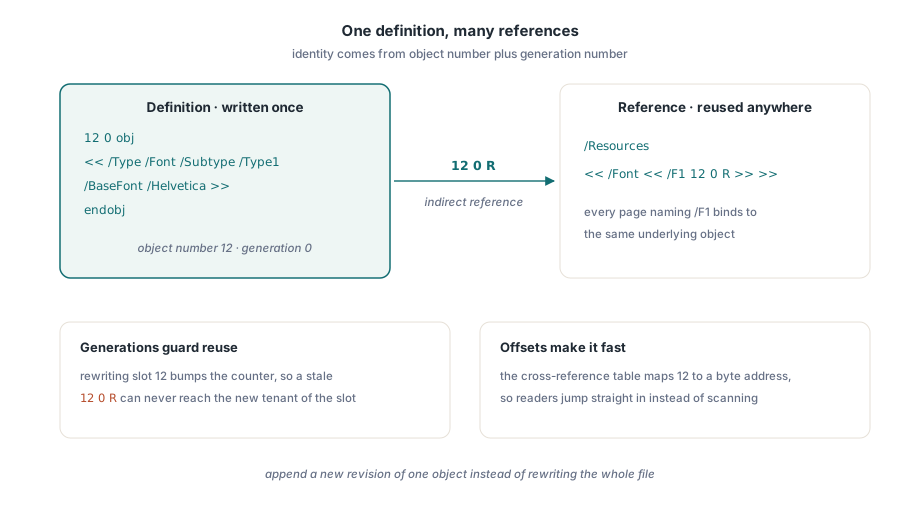
Qualquer um destes oito tipos pode aparecer de duas formas. Um objeto direto é escrito no próprio local, como o 612 dentro de um array MediaBox. Um objeto indireto recebe uma identidade para que outros objetos possam apontar para ele: dois inteiros, um número de objeto e um número de geração, envolvendo a definição entre obj e endobj:
12 0 obj
<< /Type /Font /Subtype /Type1 /BaseFont /Helvetica >>
endobj
Este é o objeto 12, geração 0, um dicionário de tipo de letra. Em qualquer outro ponto do ficheiro, outro objeto refere-se a ele através de uma referência indireta: os mesmos dois números seguidos da palavra-chave R, 12 0 R. A referência é um ponteiro. Quando o dicionário de recursos de uma página diz /Font << /F1 12 0 R >>, está a designar o objeto 12 como o tipo de letra por trás do nome de recurso /F1, sem copiar a definição do tipo de letra para dentro da página
O número de geração existe para eliminações e reutilização. Quando um objeto é libertado e a sua posição é reutilizada, a geração incrementa, de modo a que uma referência 12 0 R desatualizada não consiga resolver para o novo ocupante da posição 12. Ficheiros recém-escritos estão quase todos na geração 0, mas um ficheiro muito editado pode conter números mais altos, e um parser que ignore a geração acabará por ler o objeto errado
A indireção é o que torna o PDF eficiente e editável. Um único tipo de letra, imagem ou espaço de cor pode ser definido uma vez e referenciado a partir de uma centena de páginas. Uma pequena alteração pode ser anexada como uma nova revisão que substitui um único objeto, em vez de reescrever o ficheiro inteiro. A tabela de referência cruzada é o índice que converte um número de objeto num deslocamento de bytes, para que o leitor salte diretamente para 12 0 obj sem percorrer o ficheiro, mas isso é uma otimização física. Do ponto de vista lógico, basta saber que 12 0 R significa "o objeto identificado como 12 0"
O catálogo: onde todos os documentos começam
A resolução de referências tem de começar nalgum lugar, e esse lugar é a entrada /Root do trailer, que aponta para o catálogo do documento: a raiz do grafo de objetos, um dicionário com /Type /Catalog. O leitor chega até ele primeiro porque o trailer é encontrado primeiro, e a partir daí todas as outras partes do documento ficam acessíveis seguindo referências
O catálogo transporta apenas duas entradas estritamente obrigatórias: o seu /Type, e /Pages, uma referência indireta para a raiz da árvore de páginas. As restantes são opcionais e descrevem o comportamento do documento como um todo, e não o conteúdo: /Outlines aponta para a árvore de marcadores, /Names guarda árvores de nomes indexadas por string, /Metadata referencia uma stream de metadados XMP, e /PageMode e /PageLayout sugerem como um visualizador deve abrir o documento. Nenhuma delas é necessária para desenhar uma página; configuram antes a experiência à volta das páginas. As estruturas de marcadores, metadados e anotações dependuradas do catálogo são abordadas no artigo sobre metadados, marcadores e anotações em PDF
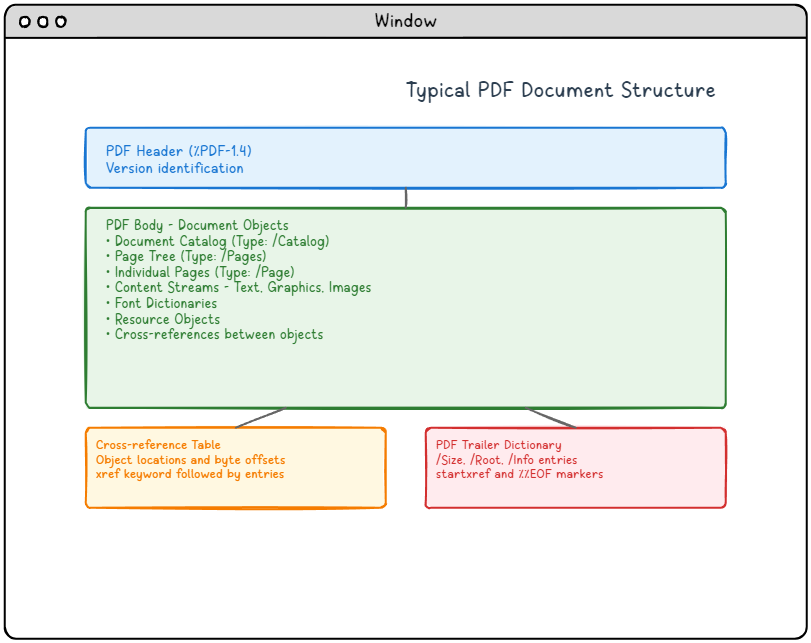
O diagrama abaixo mostra onde o corpo de objetos se situa dentro do ficheiro que o rodeia. O catálogo e a árvore de páginas vivem dentro desse corpo como objetos indiretos comuns; o cabeçalho, a tabela de referência cruzada e o trailer à sua volta são o andaime físico que permite ao leitor localizá-los
A árvore de páginas: uma hierarquia equilibrada de páginas
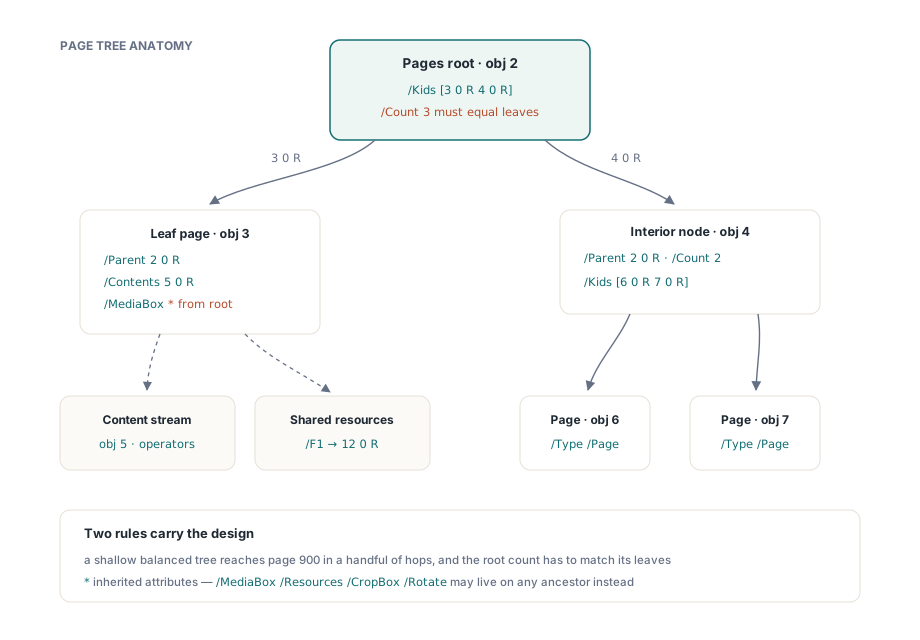
A partir de /Pages, o documento ramifica-se na árvore de páginas, onde a opção do PDF por um grafo em vez de uma lista plana compensa. As páginas não são guardadas como uma simples sequência; pendem de uma árvore cujos nós interiores são nós da árvore de páginas (/Type /Pages) e cujas folhas são objetos de página (/Type /Page). Um nó interior lista os seus filhos num array /Kids e regista, em /Count, quantas páginas-folha existem abaixo dele. Todos os nós, exceto a raiz, transportam uma referência /Parent de volta para cima, pelo que a árvore se percorre em qualquer uma das direções
2 0 obj                                  % raiz da árvore de páginas
<< /Type /Pages /Kids [3 0 R 4 0 R] /Count 3 >>
endobj

3 0 obj                                  % a leaf page
<< /Type /Page /Parent 2 0 R
   /MediaBox [0 0 612 792]
   /Resources << /Font << /F1 12 0 R >> >>
   /Contents 5 0 R >>
endobj

4 0 obj                                  % um nó interior que agrupa mais duas páginas
<< /Type /Pages /Parent 2 0 R /Kids [6 0 R 7 0 R] /Count 2 >>
endobj
Aqui, o objeto 2 é a raiz, com três páginas abaixo dele: a página-folha 3, mais duas outras alcançáveis através do nó interior 4. O /Count de 3 da raiz tem de ser igual ao total de folhas abaixo dela, e uma contagem que não coincida com a estrutura real é uma forma comum de um ficheiro editado à mão correr mal. O objetivo da árvore é a localidade de acesso. Um leitor que abra a página 900 de um documento com mil páginas não percorre 900 objetos; desce apenas um punhado de nós, porque uma árvore bem formada se mantém pouco profunda e equilibrada. Construir uma árvore destas à mão é trabalhoso o suficiente para valer a pena ver o processo do início ao fim, o que o percurso guiado em construir um documento PDF do zero faz
A árvore justifica-se uma segunda vez através da herança. Um punhado de atributos de página, /Resources, /MediaBox, /CropBox e /Rotate, pode ser definido num nó interior e omitido nas páginas individuais, que passam então a herdar o valor do antepassado mais próximo. Definindo /MediaBox uma vez na raiz, todas as folhas obtêm o mesmo tamanho de página sem o repetir; uma página que precise de ser diferente declara o seu próprio valor. Este é o único ponto do modelo de objetos em que o significado de um valor depende da posição do objeto na árvore, e não só do seu próprio conteúdo
O que uma página-folha realmente contém
Um objeto de página é o ponto de junção entre o modelo estrutural e o conteúdo visível. A sua entrada /Contents referencia uma ou mais content streams, os operadores de desenho que pintam texto e gráficos na página. O seu dicionário /Resources nomeia os tipos de letra, imagens e espaços de cor de que esses operadores dependem, sendo cada entrada uma referência indireta a um objeto partilhado entre páginas. O /MediaBox indica o retângulo da página em pontos (1/72 de polegada), e entradas como /Rotate e /CropBox ajustam a forma como é apresentada
Essa divisão de trabalho é todo o modelo em miniatura. O dicionário da página é estrutura: entradas tipadas e referências que dizem o que é a página e com que desenha. A content stream é instruções: um blob separado e compressível que diz como desenhar. O tipo de letra por trás de /F1 é um recurso partilhado, definido uma vez e apontado onde quer que seja usado. Dicionário, stream e referência cooperam para desenhar uma página, e os mesmos padrões escalam para o documento inteiro. Os operadores da content stream dentro desse blob são abordados em separado para texto e tipos de letra e para gráficos e elementos visuais
/Count e pode transmitir atributos como /MediaBox a cada descendentePorque vale a pena conhecer este modelo
A maioria dos programadores só encontra o modelo de objetos quando algo se parte: uma página é desenhada em branco porque a sua referência /Contents fica pendurada, o texto sai como caixas porque um recurso de tipo de letra nunca foi incorporado, uma ferramenta reporta um /Count que não corresponde às páginas que consegue encontrar. Cada um desses casos é uma afirmação sobre o grafo, e ler o grafo diretamente é sempre melhor do que adivinhar. Os oito tipos e a regra de referência formam um vocabulário suficientemente pequeno para se ter de cabeça, e assim que se passa a ver um PDF como objetos a apontar para objetos, os ficheiros malformados deixam de ser opacos
Dito isto, escrever o modelo à mão raramente é a decisão certa para além da aprendizagem. Manter deslocamentos de referência cruzada, números de geração, contagens da árvore de páginas e comprimentos de stream consistentes ao longo das edições é o tipo de contabilidade que uma biblioteca existe para tratar. Em produção, uma biblioteca madura de desenvolvimento de PDF gere o grafo de objetos, deixando quem a usa livre para pensar em páginas e conteúdo. Conhecer o modelo continua a compensar: permite perceber o que a biblioteca constrói por baixo, e porquê