Um encoder de Reed-Solomon que guarda o termo constante do seu polinómio gerador primeiro e depois divide o termo líder primeiro não está a calcular correção de erros de todo. O HotPDF veio precisamente com isso em quatro encoders de códigos 2D, QR, Data Matrix, PDF417 e Aztec, e cada símbolo que produziam trazia um bloco de verificação que nenhum scanner conforme conseguia usar
A parte interessante não é o deslize aritmético. É a propagação. Um encoder foi escrito primeiro, o seu loop de divisão foi copiado para os outros três, e cada formato novo herdou um defeito que nunca tinha sido validado contra um único vetor de teste publicado. Os símbolos continuavam a renderizar, os finder patterns ficavam no sítio certo, os tamanhos estavam corretos. Só os bytes que fazem um código 2D sobreviver a uma mancha é que eram lixo
Um polinómio invertido, copiado para quatro encoders
A causa raiz é um desencontro na ordem de armazenamento dentro do loop de divisão sintética. Os quatro encoders do HotPDF constroem o polinómio gerador com os coeficientes do mais baixo para o mais alto, pelo que Gen[0] guarda o termo constante e Gen[High(Gen)] guarda o coeficiente líder mónico. O loop de divisão indexava Gen[J] para a frente enquanto percorria a mensagem, o que é aritmeticamente idêntico a dividir pelo polinómio invertido. Havia uma segunda consequência que escondia a primeira: como o coeficiente líder nunca chegava à posição I, Work[I] nunca era limpo, pelo que a divisão nunca reduzia realmente nada. O loop continuava a terminar e continuava a encher a cauda com um array do comprimento exatamente certo
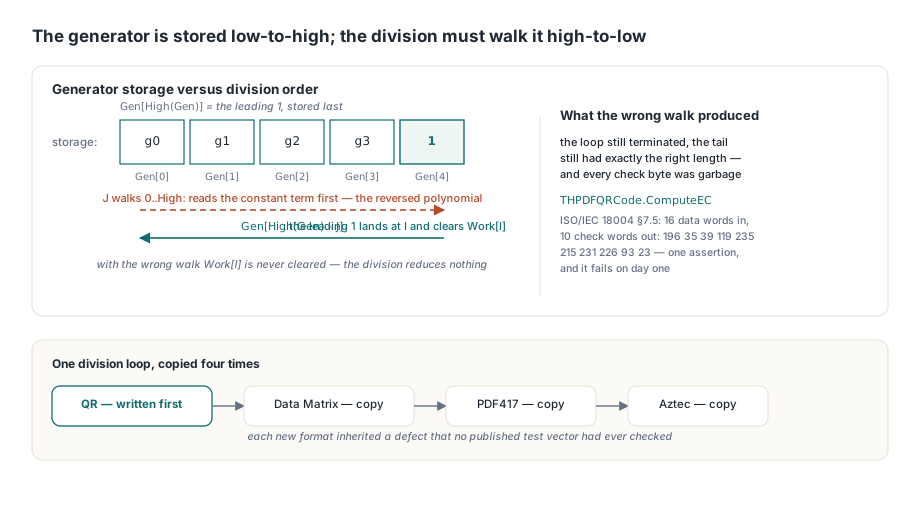
// THPDFQRCode.ComputeEC em HPDFQRCode.pas
Gen := GeneratorPoly(ECCount);            // Gen[0] é o termo constante
SetLength(Work, Length(Data) + ECCount);
for I := 0 to High(Data) do
  Work[I] := Data[I];
for I := Length(Data) to High(Work) do
  Work[I] := 0;
for I := 0 to High(Data) do
begin
  Factor := Work[I];
  if Factor = 0 then
    Continue;
  // Gen[High(Gen)] é o 1 líder que limpa Work[I]; percorrer Gen
  // para a frente divide pelo polinómio invertido em vez disso
  for J := 0 to High(Gen) do
    Work[I + J] := Work[I + J] xor GFMul(Gen[High(Gen) - J], Factor);
end;
A correção é a única expressão de índice Gen[High(Gen) - J]. Depois dela, o THPDFQRCode.ComputeEC reproduz o exemplo resolvido da secção §7.5 da ISO/IEC 18004: o bloco em byte mode da versão 1-M 32 91 11 120 209 114 220 77 67 64 236 17 236 17 236 17 produz as dez check words 196 35 39 119 235 215 231 226 93 23. Isso é uma asserção, e teria falhado no primeiro dia
Porque é que o símbolo Aztec também perdia a sua payload?
O Aztec trazia uma versão mais pesada do mesmo bug porque o TAztecGF.Encode divide in place. A rotina recebe Words com a mensagem seguida de slots de check words zerados, e o chamador emite esse array inteiro para o símbolo. A divisão polinomial destrói o dividendo à medida que o reduz, pelo que assim que o loop foi corrigido para reduzir a sério, as words da mensagem foram sobrescritas pelo caminho. A payload e a mode message saíam ambas corrompidas, uma falha que a versão partida tinha evitado acidentalmente por nunca reduzir nada
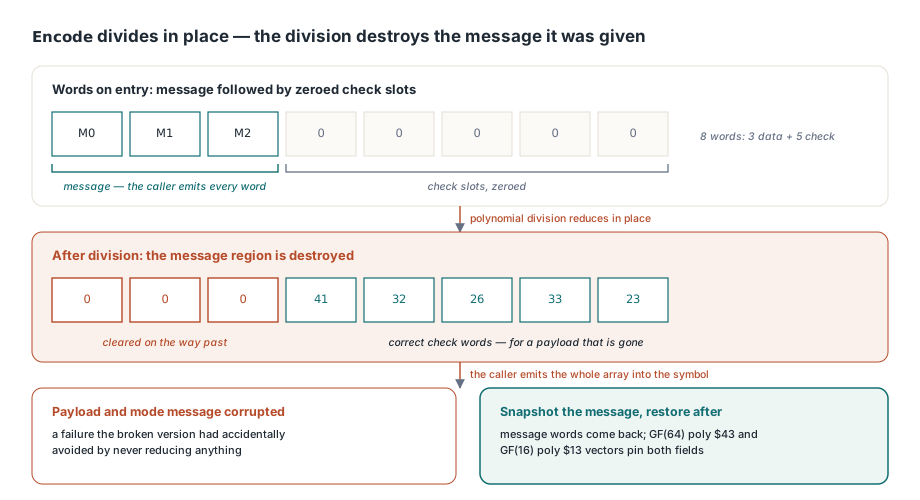
// TAztecGF.Encode em HPDFAztec.pas
SetLength(Message, DataCount);
for I := 0 to DataCount - 1 do
  Message[I] := Words[I];
for I := 0 to DataCount - 1 do
begin
  Factor := Words[I];
  if Factor = 0 then
    Continue;
  for J := 0 to ECCount do
    Words[I + J] := Words[I + J] xor Multiply(Gen[ECCount - J], Factor);
end;
// A divisão limpa a região da mensagem, mas o chamador emite o array
// inteiro para o símbolo, pelo que as words de dados têm de voltar
for I := 0 to DataCount - 1 do
  Words[I] := Message[I];
O Aztec usa dois campos diferentes, e a fixture de regressão exercita os dois. Em GF(64), o campo de um símbolo de seis bits construído a partir do polinómio primitivo $43, as words 12 45 3 com cinco check words produzem 41 32 26 33 23 enquanto as três da frente ficam intocadas. Em GF(16), o campo da mode message com o polinómio primitivo $13, as words 5 9 produzem 11 15 6 8. Ambas passam pelo hook HPDFAztecTestEncode contra a ISO/IEC 24778
O que faz o Data Matrix precisar de duas correções em vez de uma?
O THPDFDataMatrix.ComputeEC empilhou um segundo erro, independente, em cima do partilhado: construía o polinómio gerador com raízes a começar em α^0, enquanto o Anexo E da ISO/IEC 16022 especifica raízes a partir de α^1. Corrigir apenas o índice da divisão dá as check words 146 107 90 179 128 para o exemplo padrão, que parecem tão plausíveis como as corretas e continuam ilegíveis. Os dois defeitos tiveram de sair antes de os números baterem certo
// THPDFDataMatrix.ComputeEC em HPDFDataMatrix.pas
Gen[0] := 1;
for I := 0 to ECCount - 1 do
begin
  // DMExp[I + 1]: as raízes vão de alpha^1..alpha^ECCount, não desde alpha^0
  for J := ECCount downto 1 do
    Gen[J] := GFMul(Gen[J], DMExp[I + 1]) xor Gen[J - 1];
  Gen[0] := GFMul(Gen[0], DMExp[I + 1]);
end;
O ponto de referência é pequeno o suficiente para caber num comentário. A string '123456' codifica-se nas code words ASCII 142 164 186, um símbolo 10x10 carrega cinco check words, e o bloco correto é 114 25 5 88 102. O HPDFDataMatrixTestComputeEC expõe a class function por trás do gate {$IFDEF HPDF_TESTING}, pelo que a fixture afirma esses cinco valores sem instanciar um encoder nem renderizar uma página. O próprio campo de Galois, construído pelo InitDMTables sobre o polinómio primitivo $12D nas tabelas DMExp e DMLog, esteve correto o tempo todo, que é exatamente o motivo pelo qual o bug se escondeu tão bem
O PDF417 divide sobre um campo primo, onde os sinais importam
O PDF417 precisou de quatro mudanças em vez de uma, porque GF(929) é um campo primo e não um corpo de extensão binário: a adição não é xor, a subtração não é adição, e o sinal de cada fator do gerador é aritmética real em vez de notação. Cada fator tem de ser (x - 3^i), que em código significa multiplicar por 929 - GF929Pow(3, I); o passo de redução tem de subtrair; as raízes vão desde 3^1 segundo a secção §5.5 da ISO/IEC 15438; e o Factor tem de ser fixado numa local antes de o loop interno correr, porque a passagem J = 0 escreve Work[I] e mudaria o multiplicador por baixo de si próprio. O HPDFPDF417TestComputeEC fixa o resultado corrigido: as code words 5 453 178 121 239 com quatro error correction words dão 452 327 657 619
// THPDFPDF417.ComputeEC em HPDFPDF417.pas
for I := 1 to ECCount do
begin
  Root := (929 - GF929Pow(3, I)) mod 929;   // o fator é (x - 3^i)
  for J := ECCount downto 1 do
    Gen[J] := (GF929Mul(Gen[J], Root) + Gen[J - 1]) mod 929;
  Gen[0] := GF929Mul(Gen[0], Root);
end;
// ...
Factor := Work[I];                          // latch: J = 0 reescreve Work[I]
if Factor = 0 then
  Continue;
for J := 0 to ECCount do
  Work[I + J] := (Work[I + J] + 929 - GF929Mul(Gen[ECCount - J], Factor)) mod 929;
O finder do Data Matrix foi instalado do avesso
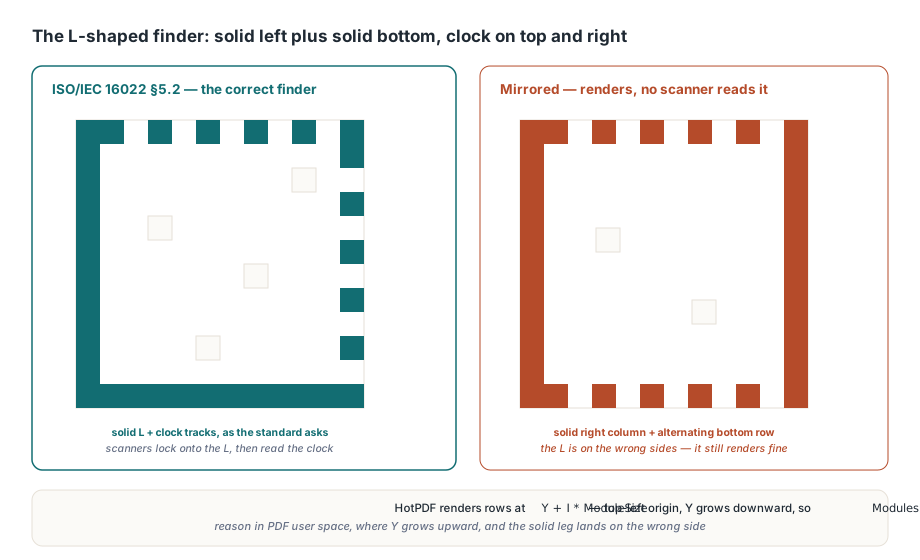
Check words corretas não salvam um símbolo cujo finder pattern está espelhado, e a mesma release também teve de corrigir isso. O código de posicionamento desenhava uma coluna esquerda sólida, uma coluna direita sólida e módulos alternados ao longo das linhas de cima e de baixo, enquanto a secção §5.2 da ISO/IEC 16022 pede uma coluna esquerda sólida mais uma linha de baixo sólida, o finder em forma de L, com a clock track alternada a correr ao longo da linha de cima e da coluna direita. O que torna fácil errar ao contrário é a convenção de coordenadas: o HotPDF renderiza as linhas de módulos em Y + I * ModuleSize, que é semântica de origem no canto superior esquerdo, pelo que Modules[Size - 1, *] é a linha de baixo do símbolo impresso. Quem raciocina no user space do PDF, onde Y cresce para cima, põe a perna sólida no lado errado e não vê nada de suspeito no ecrã
Porque é que quatro encoders partidos passaram nos testes durante anos?
Porque os testes afirmavam estrutura e os defeitos estavam na aritmética. Os casos existentes de QR, Data Matrix e Aztec verificavam finder modules, timing patterns e dimensões do símbolo, tudo genuinamente correto; nenhum teste tinha comparado uma check word contra um vetor publicado. A segunda razão generaliza ainda mais. O HotPDF traz um decoder QR embutido, e usá-lo para validar o encoder parece um round trip óbvio, exceto que este decoder lê data code words e não faz correção de Reed-Solomon, pelo que lia exatamente aquilo que o encoder escrevia e reportava sucesso. Quando um encoder e um decoder partilham um pressuposto, um teste de round trip prova que concordam, não que algum deles está certo. Um código de correção de erros tem de ser validado contra vetores impressos na norma, nunca contra o seu próprio decoder. A fixture THPDFBarcodeECCTests tem agora um teste por formato, cada um com o nome daquilo que fixa, e cada um a chegar à aritmética através de um hook compilado apenas sob {$IFDEF HPDF_TESTING}:
QRCheckWordsMatchISO18004Exampleafirma as dez check words do exemplo em byte mode da versão 1-MDataMatrixCheckWordsMatchISO16022Exampleafirma 114 25 5 88 102 para as code words 142 164 186PDF417CheckWordsMatchGF929Referenceafirma 452 327 657 619 sobre GF(929) com raízes de 3^1 a 3^4AztecCheckWordsKeepMessageAndMatchReferenceafirma as check words e que as words da mensagem sobrevivem à divisão in place
Quatro perguntas apanham a maior parte desta família em qualquer encoder que mantenha. A ordem de armazenamento do seu gerador corresponde à ordem dos índices da divisão, e consegue apontar a linha que o prova? As raízes começam onde a norma diz, α^1 para o Data Matrix e 3^1 para o PDF417? Uma divisão in place restaura a região da mensagem depois? Pelo menos um teste compara check words, em vez de contagens de módulos, contra um número impresso numa especificação? O âmbito também importa quando decide o que fazer com artefactos existentes. Símbolos gerados antes da v2.748.0 renderizam e muitas vezes fazem scan em condições ideais, porque uma imagem limpa não precisa de correção para ser lida; o que perderam é a tolerância a danos que é a razão toda para escolher estes formatos. Etiquetas de longa duração e documentos arquivados que carregam símbolos afetados valem a pena ser regenerados em vez de verificados pontualmente com a câmara do telemóvel. Os encoders vivem no suporte de códigos de barras no HotPDF, ao lado do caminho de decoding QR e do seu tratamento de orientação e da camada de output de relatórios que coloca símbolos numa página; a referência completa da API de códigos de barras vem com o HotPDF Delphi Component para Delphi e C++Builder