Um contrato exportado de um processador de texto com a caixa "tagged PDF" deixada desmarcada ainda parece estruturado na tela: um título em negrito de 24 pontos, cláusulas numeradas, uma tabela de honorários com linhas de régua. Converta para HTML refluível e a tabela de honorários volta como um <table> de verdade, enquanto o título é um <p> exatamente com a mesma posição de uma nota de rodapé. Essa saída está correta. A ISO 32000-1 §14.8 dá a um PDF exatamente um lugar para dizer "este trecho de texto é um título", a structure tree, e um arquivo sem tags não tem uma. Tamanho de fonte e negrito são escolhas de diagramação, e um conversor que transforma toda linha grande em negrito num <h1> também vai promover citações destacadas, totais de tabela e o nome da empresa no timbre
A pergunta que vale fazer de qualquer pipeline de PDF para HTML, então, é de onde veio cada título, item de lista e tabela na saída dele, e até onde cada um pode ser confiável para um layout de celular, um leitor de tela ou um indexador de busca. Títulos e tabelas dão respostas diferentes. O passo de exportação acrescenta as escolhas próprias dele sobre quebras de linha, codificação de caracteres e memória
De onde vêm títulos e listas
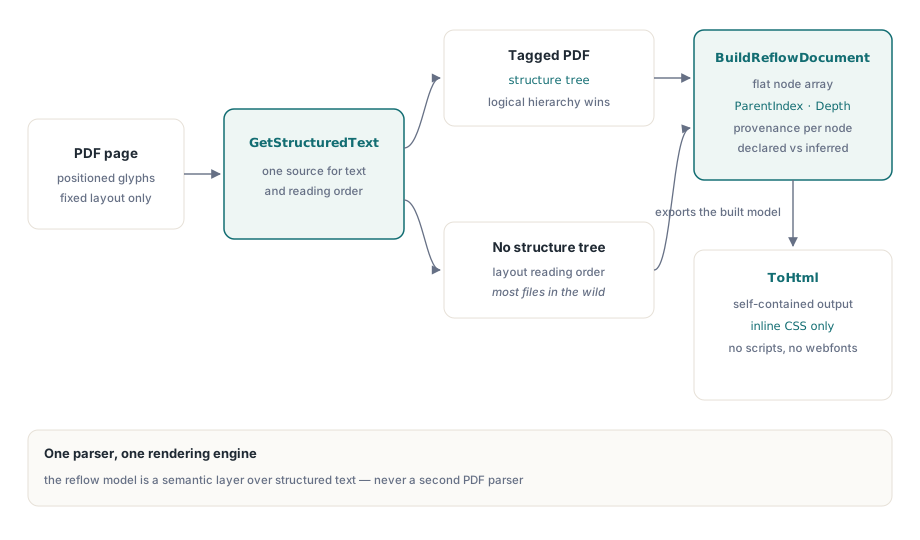
O PDFium Component monta o modelo de reflow com o TPdf.BuildReflowDocument, e esse método tira toda palavra, bloco e dica semântica do GetStructuredText, a mesma camada de texto estruturado descrita em blocos de texto estruturado e ordem de leitura. Não há um segundo parser nem um segundo extrator de texto por trás. Para cada página na faixa pedida ele coleta blocos em ordem de layout físico. O GetStructuredText já casou cada bloco com o conteúdo taggado da página por área de sobreposição, e o BuildReflowDocument copia o papel que encontrou para o bloco: H até H6 viram títulos com o nível deles, LI, Lbl e LBody viram itens de lista, Figure vira uma figura cujo texto é a descrição alternativa, e Caption vira uma legenda
Duas consequências se seguem, e ambas são fáceis de observar. A ordem dos blocos sempre segue o layout da página, mesmo num arquivo taggado, então as tags decidem o que um bloco é e a geometria decide para onde ele vai. E numa página sem tags todo bloco é um parágrafo. Títulos e listas nunca são chutados pelo tamanho da fonte
Todo nó carrega um campo Source do tipo TPdfReadingOrderSource: rosStructure quando o papel veio da structure tree, rosHeuristic quando veio só do layout. O HTML exportado repete isso como data-source="structure" ou data-source="inferred" em todo elemento, e o TPdfReflowDocument.Source de nível de documento é rosStructure só quando toda página da faixa era taggada. Tabelas são sempre rosHeuristic, porque vêm de detecção geométrica e não de tags Table. Se um passo downstream trata títulos como marcos de navegação, cheque esse campo primeiro; um documento taggado te dá marcos que o autor escolheu
Um array plano de nós em vez de uma árvore de objetos
O TPdfReflowDocument.Nodes é uma árvore achatada em pré-ordem: um array dinâmico de records TPdfReflowNode, cada um segurando um ParentIndex e um Depth. Nós de página ficam na profundidade 0 com índice de pai -1. Parágrafos, títulos, figuras, legendas, listas e tabelas penduram na página na profundidade 1, itens de lista ficam na profundidade 2 sob a lista deles, e células de tabela alcançam a profundidade 3 sob uma linha. Itens de lista consecutivos dividem um nó de lista; qualquer outro bloco ou uma tabela entre eles inicia uma lista nova
O layout plano é uma decisão de portabilidade. Um record recursivo contendo um array dinâmico dele mesmo compila no Delphi, no C++Builder e no Free Pascal, mas os três tratam tipos gerenciados recursivos de forma diferente através de fronteira de pacote ou DLL. Um array plano de records simples se comporta igual nos três, e pode ser serializado com um for e sem recursão
uses
  SysUtils, PDFium;

var
  Pdf: TPdf;
  Options: TPdfReflowOptions;
  Doc: TPdfReflowDocument;
  Node: TPdfReflowNode;
  I: Integer;
begin
  Pdf := TPdf.Create(nil);
  try
    Pdf.FileName := 'contract.pdf';
    Pdf.LoadDocument;

    Options := TPdfReflowOptions.Default;   // todas as páginas, tabelas ligadas, CSS ligado
    Doc := Pdf.BuildReflowDocument(Options);

    for I := 0 to High(Doc.Nodes) do
    begin
      Node := Doc.Nodes[I];
      case Node.Kind of
        prnkHeading:
          Writeln(Format('%sH%d [%s] %s', [StringOfChar(' ', Node.Depth * 2),
            Node.HeadingLevel,
            BoolToStr(Node.Source = rosStructure, True), Node.Text]));
        prnkTable:
          // num nó de tabela RowSpan/ColumnSpan guardam as contagens de linha e coluna da tabela
          Writeln(Format('%stable %dx%d, page %d, confidence %.2f',
            [StringOfChar(' ', Node.Depth * 2), Node.RowSpan, Node.ColumnSpan,
             Node.PageNumber, Node.Confidence]));
      end;
    end;

    Writeln(Format('%d node(s), %d table(s), %d character(s), pages %d-%d',
      [Length(Doc.Nodes), Doc.TableCount, Doc.CharacterCount,
       Doc.FirstPage, Doc.LastPage]));
  finally
    Pdf.Free;
  end;
end;
No contrato sem tags da abertura, esse loop não imprime linha H nenhuma e uma linha de tabela por tabela de honorários detectada. Rode numa cópia taggada do mesmo documento e os títulos aparecem com True ao lado. O FirstPage e o LastPage nas opções têm 0 como padrão, o que significa a primeira e a última página do documento; uma faixa fora da contagem de páginas levanta EPdfError antes de qualquer página ser lida
Por que o texto de tabela não aparece duas vezes?
A detecção de tabelas roda em cada página depois de o texto estruturado ter sido coletado, o que significa que as palavras dentro de uma tabela existem duas vezes: uma como blocos de texto, outra como células. Emitir ambas e toda tabela no HTML é seguida pelo próprio conteúdo dela de novo como parágrafos soltos, que é exatamente o que uma mesclagem ingênua de "adicione as tabelas ao texto" produz
O modelo resolve isso geometricamente. Um bloco de texto cujo bounding box fica pelo menos metade dentro dos limites de uma tabela detectada é descartado, e o nó de tabela toma o lugar dele. As tabelas então são intercaladas com os blocos restantes por posição vertical (mais alta na página primeiro, com esquerda para direita como desempate quando os topos estão dentro de meio ponto), então uma tabela aterrissa entre o parágrafo acima dela e o parágrafo abaixo em vez de ser anexada no fim da página
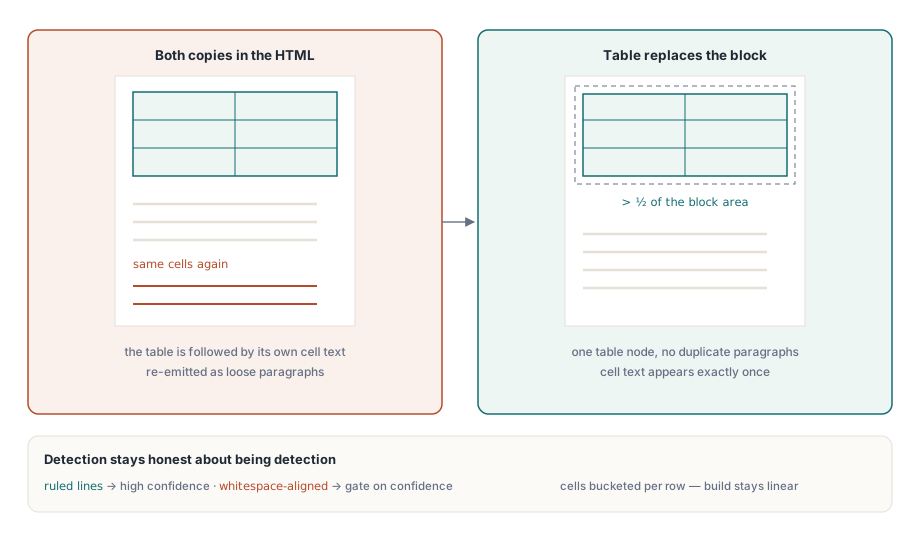
O limiar de meia área tem uma borda visível. Um bloco que cavalga a borda da tabela e fica majoritariamente fora dela sobrevive intacto, então uma linha de texto pode ocasionalmente aparecer tanto na última linha quanto no parágrafo seguinte. Esse é o lado certo para errar. Um limiar baixo o bastante para remover todo bloco sobreposto também apagaria texto de corpo que apenas toca o bounding box de uma tabela, e uma linha duplicada é muito mais fácil de notar e perdoar do que uma frase ausente
Tabelas detectadas também carregam uma confiança, e as duas estratégias de detecção aterrissam em faixas diferentes. Uma tabela achada por linhas de régua pontua entre 0,88 e 1,0, dependendo de quantas das células dela têm texto. Uma tabela inferida puramente de alinhamento por espaço em branco pontua entre 0,58 e 0,88. O Confidence do nó de tabela guarda esse escore, cada nó de célula o repete, e o HTML o grava como data-confidence no elemento <table>. Tabelas abaixo do TableOptions.MinConfidence (0,5 por padrão) nunca são criadas, e quando uma tabela é rejeitada as palavras dela simplesmente ficam no modelo como parágrafos ordinários
Para um índice de busca ou uma visualização de leitura no celular, uma tabela errada custa pouco e uma corretamente detectada é uma grande melhora, então deixe os padrões. Para conversão de arquivo, onde uma grade inventada em volta de um bloco de endereço de duas colunas é pior que nenhuma grade, restrinja a detecção a tabelas com régua:
Options := TPdfReflowOptions.Default;
Options.DetectTables := True;
Options.TableOptions.DetectWhitespaceTables := False; // só tabelas com régua
Options.TableOptions.MinConfidence := 0.9;            // descarta grades com régua esparsas também
Options.TableOptions.MaxTables := 200;                // teto para o documento inteiro
Options.TableOptions.MaxCells := 50000;               // teto para o documento inteiro

Doc := Pdf.BuildReflowDocument(Options);
if Doc.TableCount = 0 then
  Writeln('No ruled tables; all page text is emitted as paragraphs');
Dentro de uma construção de reflow, o MaxTables e o MaxCells são contados pela faixa de páginas inteira, não por página, então um extrato de 300 páginas com uma tabela com régua em cada página precisa de um MaxTables de pelo menos 300 ou a construção para com EPdfError na primeira tabela acima do limite. Os padrões são 1.000 tabelas e 100.000 células
Para o lado da detecção em si, incluindo retângulos finos preenchidos desenhados como bordas e continuação entre páginas, veja detecção e extração de tabelas
Exportando HTML que não precisa de mais nada
O TPdfReflowDocument.ToHtml caminha pelo modelo que já foi construído e nunca toca no PDFium de novo, então exportar o mesmo modelo duas vezes dá a mesma string. Com o FullDocument definido (o padrão) o resultado é uma página completa: doctype, <meta charset="utf-8">, uma meta tag de viewport, um <title> tirado da entrada Title do documento (ou "PDF document" quando vazia), e um atributo lang da linguagem do documento. Com o FullDocument desligado você ganha um fragmento único <div class="pdf-reflow"> para soltar no seu próprio template
A folha de estilos opcional do IncludeCss é um único bloco <style> inline: uma coluna de leitura de 72rem, cada página do PDF como um cartão branco quando o IncludePageSections está ligado, bordas de tabela colapsadas, e uma media query abaixo de 40rem que remove o enchimento do cartão e reduz o texto de tabelas. Não há script, web font ou URL externo nenhum, e é isso que deixa o arquivo sentar dentro de um e-mail, um visualizador de ajuda estilo CHM ou um controle de navegador isolado. Níveis de título fora de 1 a 6 são gravados como h2, células de cabeçalho viram th, e células com RowSpan ou ColumnSpan acima de 1 ganham rowspan e colspan. Ligar o IncludeGeometry acrescenta data-left, data-top, data-right e data-bottom em pontos do PDF, o que é prático para destacar um resultado de busca de volta na página renderizada
O PreserveLineBreaks merece uma escolha deliberada. Uma quebra de linha dentro de um parágrafo de PDF foi feita para uma largura de coluna fixa; mantenha-a numa tela de 360 pixels e toda linha quebra duas vezes, o padrão irregular que o reflow existe para remover. Deixe desligado (o padrão) para prosa. Ligue para documentos em que a quebra carrega significado, como endereços, verso ou listagens de código, e ele grava <br> em vez de um espaço
Para um documento longo, construir a página inteira como um WString e depois codificá-la dobra o pico de memória. O WriteHtml streama a mesma marcação num TPdfReportWriter em vez disso, gravando ASCII com todo caractere não ASCII como referência de caractere numérica, então os bytes são válidos independente de como o lado receptor chuta a codificação:
uses
  Classes, SysUtils, PDFium, FPdfAsync, FPdfReport;

procedure ExportReflowHtml(Pdf: TPdf; const FileName: string;
  const Token: IPdfCancellationToken);
var
  Options: TPdfReflowOptions;
  Doc: TPdfReflowDocument;
  Limits: TPdfReportLimits;
  Stream: TFileStream;
  Writer: TPdfReportWriter;
begin
  Options := TPdfReflowOptions.Default;
  Options.MaxNodes := 500000;
  Options.MaxCharacters := 20000000;
  Doc := Pdf.BuildReflowDocument(Options, Token);   // o estado da página é restaurado depois

  Limits := TPdfReportLimits.Default;
  Limits.MaxCharacters := 64 * 1024 * 1024;  // teto de bytes de saída, máximo de 64 MiB
  Limits.MaxItems := Options.MaxNodes;       // um item por nó, máximo de 1048576

  Stream := TFileStream.Create(FileName, fmCreate);
  try
    Writer := TPdfReportWriter.Create(Limits, Stream);  // o stream continua sendo de quem chamou
    try
      Doc.WriteHtml(Writer);
    finally
      Writer.Free;
    end;
  finally
    Stream.Free;
  end;
end;
O WriteHtml checa mais coisas que o ToHtml. Ele recusa um modelo com mais nós que o Options.MaxNodes, impõe o Options.MaxCharacters no texto que grava, limita o aninhamento ao argumento MaxDepth (64 por padrão), e verifica que todo ParentIndex aponta para um nó anterior. Essa última checagem importa se o seu código filtra ou reescreve Nodes antes da exportação: um array editado com índice de pai para a frente levanta EPdfReportLimit em vez de produzir marcação com tags desparelhadas
Orçamentos, cancelamento e a página atual
Um PDF é entrada não confiável, e um arquivo malformado ou hostil pode declarar milhares de páginas de texto minúsculo. O BuildReflowDocument checa os orçamentos de caractere, nó, tabela e célula antes de cada nó ser adicionado, então um arquivo que os excede para com EPdfError e uma mensagem nomeando o orçamento ("Reflow node budget exceeded", por exemplo) enquanto o uso de memória ainda está limitado. Tanto o MaxCharacters quanto o MaxNodes precisam ser positivos; os padrões são 10.000.000 caracteres e 1.000.000 nós
O IPdfCancellationToken opcional é checado antes de cada página, entre blocos, antes de cada tabela e antes de cada linha de tabela. Passe o Token de um TPdfCancellationTokenSource que o seu formulário possui, chame Cancel no handler do botão, e a construção levanta EPdfOperationCancelled no próximo desses checkpoints. Capture separado do EPdfError para que o cancel de um usuário não seja logado como arquivo quebrado. Seja qual for a exceção com que a construção termina, nada parcial é retornado; se a falha acontece mais tarde dentro do WriteHtml, o arquivo de destino segura uma página truncada, então apague-o no seu próprio handler de exceção
O estado da página é o detalhe de que código GUI depende. A construção visita toda página da faixa movendo o PageNumber, e um try/finally devolve a página de quem chamou no sucesso, numa falha de orçamento e num cancelamento igualmente. Um visualizador que inicia uma exportação enquanto o usuário lê a página 340 continua na página 340 quando a exportação retorna
Onde o reflow se encaixa
A saída de reflow funciona bem como entrada para indexação de busca, visualizações de leitura acessíveis, exibição no celular e migração de conteúdo para um CMS. Ela deliberadamente descarta posicionamento absoluto, fontes exatas, arte vetorial e geometria de página, exceto pelas coordenadas data-* opcionais. Quando um trabalho precisa que a página fique idêntica, renderize; quando precisa que as palavras sejam legíveis em outro lugar, faça reflow
Como títulos e listas vêm só de tags, a qualidade do HTML acompanha a qualidade da taggação a montante. Documentos que passam nas checagens em validação da structure tree do PDF/UA produzem modelos com hierarquia de títulos real, e o mesmo conteúdo taggado comanda os recursos de leitura em construir um leitor acessível
Reflow, texto estruturado, extração de tabelas e renderização rodam todos contra o mesmo objeto TPdf no Delphi, no C++Builder e no Lazarus; records de opções, exceções e o report writer estão documentados na página de produto do PDFium Component para Delphi