Um paper de conferência de duas colunas ordenado por posição vertical volta com uma primeira linha como Abstract We measure the 2 Related work Earlier studies: as palavras de abertura da coluna da esquerda e as palavras de abertura da coluna da direita, coladas porque ambas estão na mesma baseline. Nada deu errado no parser. Uma página de PDF oferece duas ordens defensáveis para o texto dela, a sequência em que o content stream o pinta e a posição de cada glifo na página, e para muitos layouts essas duas ordens discordam. Um extrator que devolve blocos posicionados em vez de uma string deixa você ver qual ordem recebeu e trocar quando é a errada para a página que tem na frente
O que o GetStructuredText devolve
O TPdf.GetStructuredText no PDFium Component devolve uma TPdfStructuredTextPage para a página atual: um array de blocos, cada bloco um array de linhas, cada linha um array de spans estilizados. Todo nível carrega o próprio Text e um retângulo Bounds em espaço de página em pontos PDF, então um título, uma única linha ou uma frase em negrito pode ser localizada na página sem uma segunda busca. O record de página adiciona Width, Height, CharacterCount e dois contadores de qualidade descritos mais abaixo
A Page.Text achatada é construída a partir dos blocos em vez do stream de caracteres bruto. Linhas dentro de um bloco são unidas com um único CRLF e blocos são separados por uma linha vazia, o que significa que um dump de Page.Text em texto plano já mostra onde o extrator traçou as fronteiras de bloco dele. Isso o torna a coisa mais rápida de imprimir quando uma página lê estranho
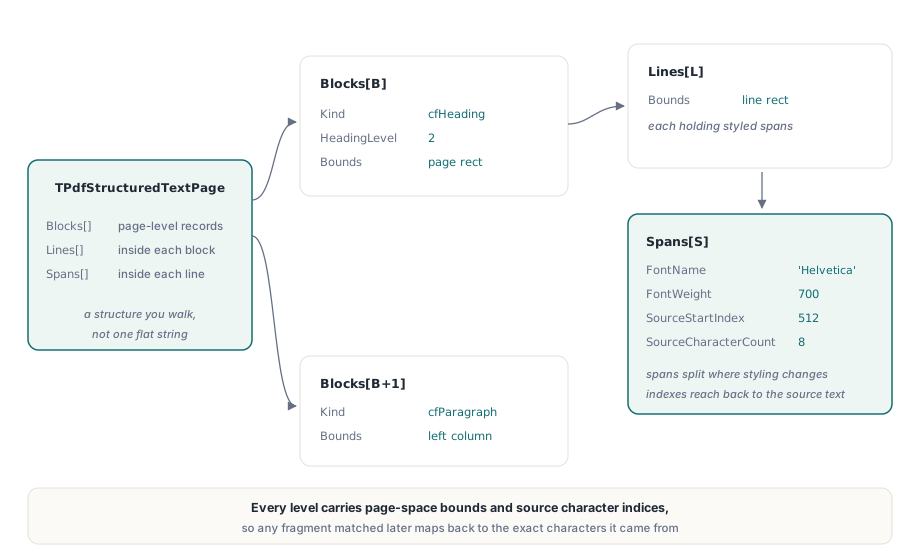
Tudo isso é dirigido por um pequeno record de opções. O TPdfStructuredTextOptions.Default define ReadingOrder como roPhysicalLayout, liga IncludeFontInfo e IncludeSemantics, e define MaxCharacters como 1.000.000. O campo de ordem de leitura é o que mais muda a forma da saída
Como as duas ordens de leitura constroem linhas e blocos
A roContentOrder mantém a sequência de desenho do produtor, enquanto a roPhysicalLayout reconstrói a ordem a partir das posições dos glifos, e a diferença aparece primeiro em como as linhas se formam. Na ordem de conteúdo, os caracteres são tomados na ordem em que a página os desenha. Uma nova linha começa em uma quebra de linha explícita ou quando o próximo caractere deixa de se sobrepor verticalmente à linha atual. Uma linha então se junta ao bloco diretamente antes dela só se os dois se sobrepõem horizontalmente em pelo menos um quinto da largura mais estreita e o gap vertical não é maior que cerca de duas alturas de linha e um quarto; caso contrário, ela abre um novo bloco. Os blocos ficam na ordem de desenho
O layout físico joga a sequência de desenho fora. Todo caractere com caixa conhecida é ordenado pelo centro vertical dessa caixa, topo da página primeiro, depois pela borda esquerda dele. Caracteres cujas extensões verticais se sobrepõem o bastante dividem uma linha, e esse teste olha só para a altura. A distância horizontal não entra nele. Cada linha então se junta ao bloco existente em qualquer lugar da página que melhor a acomode pela mesma regra de sobreposição-e-gap, e os blocos prontos são ordenados pela borda superior deles, com a borda esquerda desempatando dentro de meio ponto
A segunda regra é de onde vem o exemplo de abertura. Quando as duas colunas de um paper dividem uma grade de baselines, a primeira linha da coluna da esquerda e a primeira linha da coluna da direita se sobrepõem verticalmente, então o layout físico as coloca em uma linha. O gap na medianiz é mais largo que um quarto do tamanho da fonte, então o extrator insere um espaço e segue em frente. Toda linha do corpo faz o mesmo, as linhas mescladas todas se sobrepõem umas às outras horizontalmente, e o corpo inteiro de duas colunas vira um único bloco largo que lê direto através da medianiz
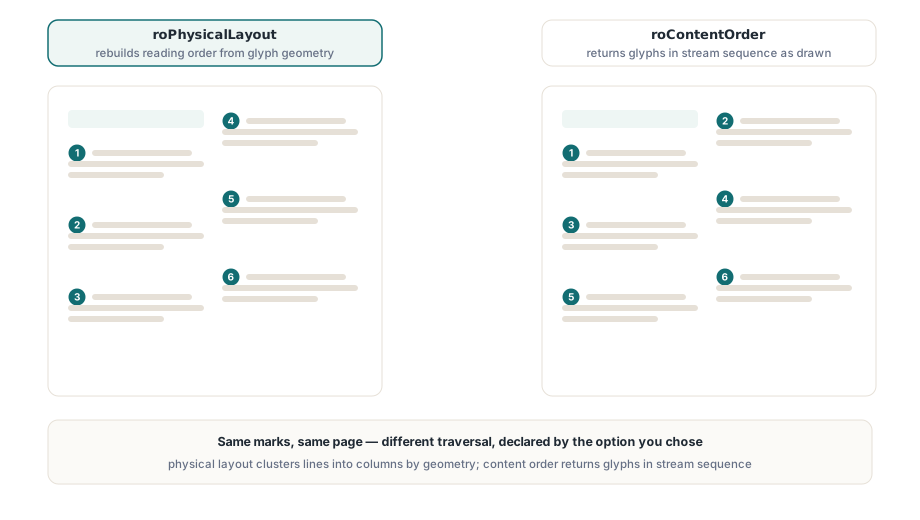
A ordem de conteúdo trata bem essa página sempre que o produtor escreveu a coluna um antes da coluna dois, que é o que processadores de texto e sistemas de diagramação normalmente fazem. As linhas da coluna da esquerda se empilham em blocos, a primeira linha da coluna da direita não tem sobreposição horizontal com elas e abre um bloco novo, e os blocos saem na ordem em que o autor os escreveu. O layout físico ganha o lugar dele em outro tipo de página: faturas, extratos, formulários e slides, em que um rótulo e o valor dele estão na mesma baseline e ler a linha da esquerda para a direita é exatamente o que você quer. É também o modo a usar quando a sequência de desenho não significa nada, por exemplo texto pintado fonte por fonte ou uma página montada a partir de muitos overlays pequenos
Para uma coleção mista, divida a escolha por tipo de documento. Artigos, relatórios e manuais de uma ferramenta de autoria conhecida passam pela roContentOrder; formulários e documentos transacionais ficam no padrão roPhysicalLayout. A rotina seguinte imprime os blocos de uma página em ordem de conteúdo, com títulos marcados quando o arquivo é tagueado
uses
  SysUtils, PDFium;

procedure DumpBlocks(Pdf: TPdf; PageNumber: Integer);
var
  Options: TPdfStructuredTextOptions;
  Page: TPdfStructuredTextPage;
  B, L: Integer;
begin
  Pdf.PageNumber := PageNumber;                 // baseado em 1
  Options := TPdfStructuredTextOptions.Default;
  Options.ReadingOrder := roContentOrder;      // produtores coluna por coluna

  Page := Pdf.GetStructuredText(Options);
  if Page.Source = rosStructure then
    Writeln('block kinds come from the structure tree')
  else
    Writeln('block kinds are inferred from layout');

  for B := 0 to High(Page.Blocks) do
  begin
    if Page.Blocks[B].Kind = cfHeading then
      Writeln(Format('[%d] H%d  %s',
        [B, Page.Blocks[B].HeadingLevel, Page.Blocks[B].Text]))
    else
    begin
      Writeln(Format('[%d] x=%.0f..%.0f, %d line(s)',
        [B, Page.Blocks[B].Bounds.Left, Page.Blocks[B].Bounds.Right,
         Length(Page.Blocks[B].Lines)]));
      for L := 0 to High(Page.Blocks[B].Lines) do
        Writeln('      ', Page.Blocks[B].Lines[L].Text);
    end;
  end;
end;
Como detectar uma linha que atravessa a medianiz?
Uma linha mesclada se entrega pelos spans dela. O GetStructuredText começa um novo span sempre que o próximo caractere não é o sucessor direto do anterior na sequência de caracteres original da página, além das mudanças de estilo cobertas mais abaixo. Dentro de uma coluna, palavras consecutivas costumam ser consecutivas na origem. Na medianiz de uma linha mesclada o índice de origem salta centenas de caracteres, e o gap horizontal entre os dois spans é muito mais largo que qualquer espaço de palavra
Esses dois sinais juntos formam um teste confiável, e você pode rodá-lo na saída padrão antes de decidir se uma página precisa de ordem de conteúdo em vez disso. O snapshot de dados de caracteres que o GetStructuredText lê é armazenado em cache por página, oito páginas por padrão, então pedir a mesma página uma segunda vez com um ReadingOrder diferente reorganiza dados já em memória em vez de extrair a página de novo
// LineCrossesGutter é um helper que você mesmo adiciona: ela marca uma linha com dois
// spans vizinhos que estão distantes na página e não adjacentes na
// sequência de caracteres de origem
function LineCrossesGutter(const Line: TPdfStructuredTextLine;
  MinGap: Double): Boolean;
var
  S: Integer;
  Prev, Cur: TPdfStructuredTextSpan;
begin
  Result := False;
  for S := 1 to High(Line.Spans) do
  begin
    Prev := Line.Spans[S - 1];
    Cur := Line.Spans[S];
    if (Prev.SourceStartIndex < 0) or (Cur.SourceStartIndex < 0) then
      Continue;                                 // blocos de texto alternativo
    if (Cur.Bounds.Left - Prev.Bounds.Right > MinGap) and
       (Cur.SourceStartIndex <>
        Prev.SourceStartIndex + Prev.SourceCharacterCount) then
      Exit(True);
  end;
end;

function ExtractWithFallback(Pdf: TPdf): TPdfStructuredTextPage;
var
  Options: TPdfStructuredTextOptions;
  B, L, Lines, Crossing: Integer;
begin
  Options := TPdfStructuredTextOptions.Default;   // roPhysicalLayout
  Result := Pdf.GetStructuredText(Options);

  Lines := 0;
  Crossing := 0;
  for B := 0 to High(Result.Blocks) do
    for L := 0 to High(Result.Blocks[B].Lines) do
    begin
      Inc(Lines);
      if LineCrossesGutter(Result.Blocks[B].Lines[L], 18) then
        Inc(Crossing);
    end;

  // um quarto das linhas cruzando um gap parece colunas, não uma linha de formulário
  if (Lines > 0) and (Crossing * 4 >= Lines) then
  begin
    Options.ReadingOrder := roContentOrder;
    Result := Pdf.GetStructuredText(Options);
  end;
end;
Dezoito pontos são um quarto de polegada, confortavelmente mais largos que um espaço de palavra em texto de corpo e mais estreitos que a maioria das medianizes. O limiar de um em quatro mantém uma fatura com algumas linhas de rótulo-e-valor no layout físico enquanto um corpo genuíno de duas colunas, em que quase toda linha cruza, troca de modo. Se o produtor escreveu a página linha por linha através das duas colunas, os índices de origem ficam contíguos, o teste nunca dispara, e nenhuma das ordens vai separar as colunas para você; essa página precisa do modo de coluna da API de readable content, descrito em leitura de duas colunas com um título que atravessa
O que o IncludeSemantics muda, e o que ele deixa em paz?
IncludeSemantics rotula blocos; ele não os reordena. Com a opção ligada, o GetStructuredText lê o readable content da página e dá a cada bloco o tipo do fragmento com que ele se sobrepõe pela maior área. Os tipos disponíveis são cfParagraph, cfHeading com um HeadingLevel, cfListItem, cfTableCell, cfCaption, cfFigure, cfLink, cfOther para qualquer outra tag, e cfPlain quando nada bateu. Cada bloco também recebe um Language e um StructElementIndex que o amarra a um elemento da árvore de estrutura
O campo Source diz de onde o rótulo veio: rosStructure quando a página tem uma árvore de estrutura utilizável no sentido da ISO 32000-1 §14.7, rosHeuristic quando os tipos foram inferidos. O Page.Source dá a mesma resposta para a página como um todo. Um título reportado com rosStructure é um título porque o autor o tagueou; um reportado com rosHeuristic é um palpite instruído, e um pipeline de indexação que pondera títulos deve tratar os dois de forma diferente. A ordem dos blocos, nos dois casos, ainda vem do ReadingOrder. A passada semântica usa os padrões de readable content, então uma configuração de colunas aplicada por meio de ReadableContentOptions não chega ao GetStructuredText
Figuras ganham uma regra extra. Em uma página tagueada, um elemento Figure ou texto alternativo que não foi casado com nenhum bloco de texto é acrescentado como um bloco próprio, segurando a descrição alternativa como o texto dele. Um bloco assim tem uma única linha e um único span com SourceStartIndex definido como -1, porque nenhum glifo na página o produziu. Código que mapeia spans de volta para caracteres tem que pular esse valor, razão pela qual o teste de medianiz acima o confere. As verificações da própria árvore de estrutura estão cobertas em validação de árvore de estrutura PDF/UA
Spans, limites e o caminho de volta para os caracteres
Cada TPdfStructuredTextSpan carrega o texto dele, os limites dele, FontName, FontSize, FontWeight e Angle, além de SourceStartIndex e SourceCharacterCount. Com IncludeFontInfo ligado, um span termina onde quer que qualquer um dos quatro valores de estilo mude, então uma frase com três palavras em negrito no meio chega como três spans e a ênfase pode ser reconstruída a partir do FontWeight em vez de adivinhada por nomes de fonte. Com IncludeFontInfo desligado, os campos de estilo ficam vazios e os spans quebram só onde a sequência de origem é interrompida
O ângulo importa em páginas com carimbos. Uma marca d'água DRAFT diagonal vive no mesmo espaço de coordenadas que o texto do corpo, e no layout físico as letras dela podem cair em linhas do corpo que elas cruzam verticalmente. Spans com Angle diferente de zero são fáceis de descartar antes de você juntar texto para indexação
Os dois campos de origem são o que transformam um acerto de busca em algo que você pode desenhar. Eles indexam a sequência de caracteres da página, então uma frase encontrada em um bloco se converte diretamente em caixas de caractere para um destaque, usando a abordagem de seleção visual de linha de texto com caixas de caractere. Quando a forma refluída ou HTML da página é o objetivo, os mesmos blocos alimentam o modelo de reflow e o export HTML dele
Um orçamento de caracteres e dois contadores de qualidade
O MaxCharacters rejeita uma página de cara quando ela tem mais caracteres do que o permitido. O GetStructuredText confere a contagem antes de alocar qualquer array de trabalho, e uma página grande demais levanta EPdfError com a mensagem Structured text character budget exceeded; uma página parcial nunca é devolvida. O valor tem que ser positivo. O snapshot de caracteres por página que o método lê tem o próprio teto padrão de 1.000.000 de caracteres e 100.000 objetos de texto, reportado como Text snapshot budget exceeded, então definir o MaxCharacters acima de um milhão não deixa uma página maior passar
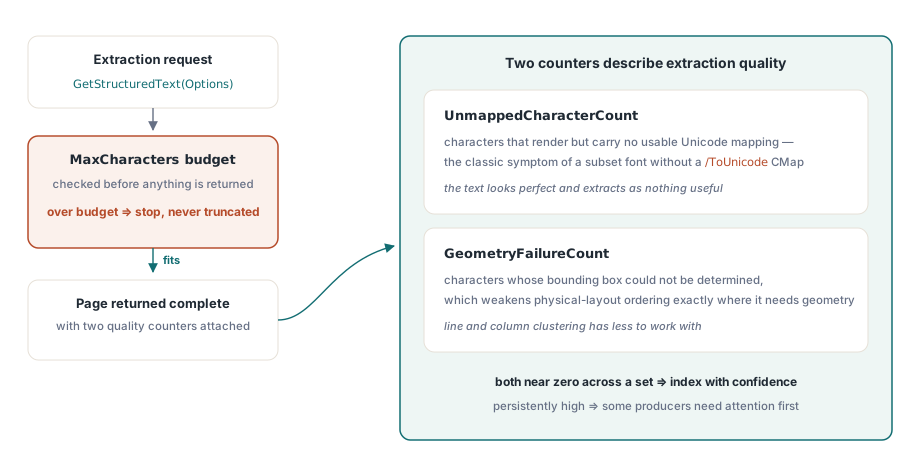
O UnmappedCharacterCount conta caracteres para os quais o PDFium não conseguiu produzir valor Unicode algum. Esses caracteres aparecem como U+FFFD em todo campo Text. A causa usual é uma fonte subset com codificação customizada e nenhum CMap /ToUnicode, o caso que a ISO 32000-1 §9.10.2 descreve, em que o texto renderiza corretamente e não pode ser extraído de forma confiável. O contador mede só mapeamentos ausentes: um glifo cuja entrada /ToUnicode nomeia o code point errado conta como mapeado, então uma página de lixo de aparência plausível ainda pode reportar zero
O GeometryFailureCount conta caracteres sem caixa utilizável, quebras de linha excluídas. Na ordem de conteúdo esses caracteres simplesmente seguem os vizinhos deles. No layout físico eles não têm posição pela qual ordenar, então são colocados depois de todo caractere posicionado e acabam presos à última linha da página. Uma página com contagem de geometria diferente de zero e fragmentos estranhos na última linha está mostrando exatamente isso
// LogRejected e LogQuality são rotinas de logging suas
function ExtractForIndex(Pdf: TPdf; PageNumber: Integer;
  out Page: TPdfStructuredTextPage): Boolean;
var
  Options: TPdfStructuredTextOptions;
begin
  Result := False;
  Pdf.PageNumber := PageNumber;
  Options := TPdfStructuredTextOptions.Default;
  Options.MaxCharacters := 200000;              // limite de entrada para este pipeline
  try
    Page := Pdf.GetStructuredText(Options);
  except
    on E: EPdfError do
    begin
      LogRejected(PageNumber, E.Message);       // orçamento de caracteres ou de snapshot
      Exit;
    end;
  end;

  if Page.UnmappedCharacterCount * 20 > Page.CharacterCount then
    LogQuality(PageNumber, Format('%d of %d characters have no Unicode value',
      [Page.UnmappedCharacterCount, Page.CharacterCount]));
  if (Options.ReadingOrder = roPhysicalLayout) and
     (Page.GeometryFailureCount > 0) then
    LogQuality(PageNumber, Format('%d characters without a box; check the last line',
      [Page.GeometryFailureCount]));
  Result := True;
end;
Para uma página que você só precisa como string, extrair texto de documentos PDF cobre as chamadas mais simples, e ler e gravar conteúdo marcado BDC e MCID desce uma camada abaixo da árvore de estrutura. O modelo de página estruturada, o leitor de readable content e o export de reflow vêm todos no componente Delphi e Lazarus descrito na página do produto do PDFium Component