O atributo axis="rowAxis" em um elemento pivotField parece XML perfeitamente sensato, e um leitor que o mapeia para "campo de linha" vai carregar o pivot com todos os campos no eixo certo. Rode a mesma parte por um validador construído a partir do schema ECMA-376 Part 1 §18.10 e ela falha no primeiro atributo: ST_Axis tem exatamente quatro tokens, axisRow, axisCol, axisPage e axisValues, e rowAxis não é um deles. Um escritor de pivots precisa satisfazer o schema em vez do próprio leitor, porque as pessoas que abrem o arquivo usam o Excel e os parsers delas
Definições de campo de pivot estão cheias de regras como essa. Três costumam escapar de um teste de round trip: os tokens de enumeração, a exigência de que um elemento items nunca está vazio, e as entradas de subtotal finais que o Excel lista depois dos itens de dados. Mais duas ficam do lado da leitura, em atributos que o Excel deixa de fora porque guardam o default do schema. O resto deste artigo percorre cada regra, mostra como o XML precisa ficar e mostra as chamadas Delphi que o produzem
Por que um round trip não consegue pegar um token de eixo errado
Um round trip prova que o escritor e o leitor concordam entre si, e nada mais. Se o leitor aceita tanto axisRow quanto rowAxis, um escritor que emite o errado passa em toda checagem de salvar-e-carregar que você puder escrever, porque o leitor repara o erro no caminho de volta. A falha só aparece quando um consumidor mais estrito abre a parte: um validador de schema, um parser gerado a partir do XSD, ou o Excel decidindo que a parte precisa de reparo
O HotXLS separa os dois lados de propósito. O escritor XLSX emite apenas os quatro tokens ST_Axis, enquanto o leitor de pivots também mapeia as grafias com cara de inglês rowAxis, colAxis, pageAxis e dataAxis para o eixo correspondente, então arquivos de produtores que as usam ainda carregam com o layout intacto. A saída é cobrada pelo schema; a entrada só precisa ser reconhecível. O inverso, um leitor estrito pareado a um escritor descuidado, pelo menos falharia barulhento nos seus próprios testes; um leitor tolerante pareado a um escritor descuidado não falha em lugar nenhum que você consiga ver
<!-- inválido: rowAxis não é um valor ST_Axis, e CT_Items não pode estar vazio -->
<pivotField axis="rowAxis" defaultSubtotal="1"><items count="0"></items></pivotField>

<!-- válido: token ST_Axis, itens reais, subtotal default final -->
<pivotField axis="axisRow" defaultSubtotal="1">
  <items count="4"><item x="0"/><item x="1"/><item x="2" h="1"/><item t="default"/></items>
</pivotField>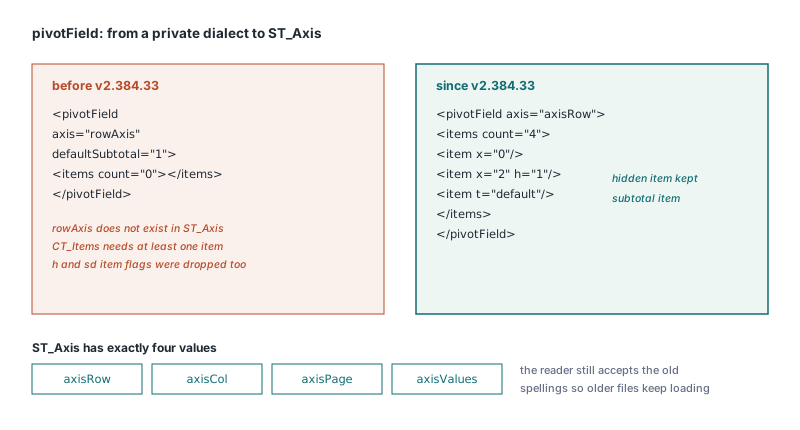
O que o CT_PivotField espera além do eixo
O CT_PivotField tem mais três exigências que são fáceis de derrubar. Um campo agregado na área de valores precisa dizer isso na própria definição dele com dataField="1", mesmo que a lista <dataFields> já o referencie. O HotXLS define essa flag em todo campo de pivot para o qual uma entrada em DataFields aponta, então um campo adicionado com AddDataFieldByName é marcado nos dois lugares
A segunda regra é estrutural. O CT_Items exige pelo menos um filho item, o que torna <items count="0"></items> inválido mesmo sendo XML bem formado que analisa em todo lugar. Quando um campo não tem itens, o HotXLS deixa o elemento items inteiro de fora. A terceira regra é sobre o estado de cada item: um membro oculto carrega h="1" e um membro com detalhes recolhidos carrega sd="0". Ambos vêm de TXLSPivotItem.IsHidden e TXLSPivotItem.IsDetailHidden e são gravados a cada save, então um filtro definido em código sobrevive até o Excel
Itens de subtotal finais e a armadilha do count
Quando um campo tem itens, o Excel segue os itens de dados com um item extra por função de subtotal, tipado com ST_ItemType. O subtotal automático é <item t="default"/>; funções explícitas usam sum, countA, avg, max, min, product, count, stdDev, stdDevP, var e varP. Essas entradas não carregam índice x para o cache, e elas são incluídas no atributo count de items. Um escritor que as deixa de fora produz uma lista de itens que não bate mais com as flags de subtotal do mesmo elemento
O HotXLS deriva o final a partir de TXLSPivotField.Subtotals na hora do save: um item t="…" por função no conjunto, na ordem de enumeração, somado ao count, mais o atributo no estilo sumSubtotal="1" correspondente no campo. Campos criados por AddPivotTable começam com um conjunto vazio, o que grava defaultSubtotal="0" e nenhum item final. Para relatórios gerados, deixe o conjunto vazio: linhas de subtotal mudam a altura do pivot e deslocam qualquer coisa colocada abaixo dele. Adicione funções a Subtotals apenas nos campos em que o leitor precisa das linhas extras
A nomenclatura merece uma segunda olhada antes de você escolher uma função. xlpsCount mapeia para countA, que conta todas as entradas não vazias, e xlpsCountNums mapeia para count, que conta só números. Quem lê "count" no XML e alcança o xlpsCount recebe a outra função
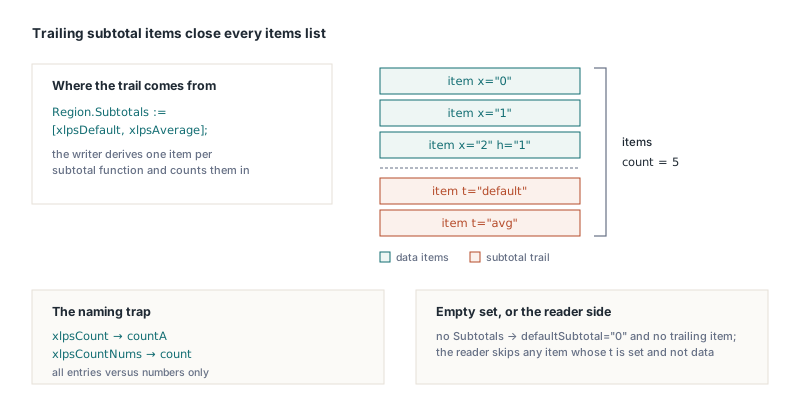
O programa abaixo constrói um pivot a partir de uma planilha de dados existente com um campo de linha, um campo de coluna e um campo de valor. O campo Region recebe o subtotal automático mais uma média, o que produz dois itens finais depois dos itens de dados dele e dataField="1" em Revenue
uses
  SysUtils, lxHandleX, lxPivot;

var
  Book  : TXLSXWorkbook;
  Sheet : TXLSXWorksheet;
  Pivot : TXLSPivotTable;
  Region: TXLSPivotField;
begin
  Book := TXLSXWorkbook.Create;
  try
    Book.Open('orders.xlsx');
    Sheet := Book.Sheets[1];                  // Sheets tem base 1
    Pivot := Sheet.AddPivotTable('Data!$A$1:$D$800', 3, 6, 'RegionTotals');
    if Pivot = nil then
      raise Exception.Create('Bad source range or anchor');

    Region := Pivot.AddRowField('Region');    // nil se não houver tal campo
    if Region <> nil then
      Region.Subtotals := [xlpsDefault, xlpsAverage];  // -> t="default", t="avg"
    Pivot.AddColumnField('Quarter');
    Pivot.AddDataFieldByName('Revenue', xlpaSum);      // Revenue recebe dataField="1"

    Book.SaveAs('orders-pivot.xlsx');
  finally
    Book.Free;
  end;
end;
Lendo o que o Excel deixa de fora
O leitor tem o problema espelhado. Um campo de pivot feito no Excel lista as entradas de subtotal dele em items, e carregá-las como membros ordinários daria ao campo itens fantasma que não apontam para valor de cache nenhum. O HotXLS pula qualquer item cujo atributo t está presente e não é data, o que cobre entradas de subtotal, total geral e vazio. As funções de subtotal chegam pelas flags do próprio campo e caem em Subtotals, então código que percorre Items vê só membros reais e todo CacheItemIndex se refere a um valor de cache
Atributos ausentes são a outra metade. No schema, defaultSubtotal no CT_PivotField e containsString no CT_SharedItems têm ambos default true, e o Excel os omite quando guardam esse valor. O HotXLS lê um defaultSubtotal ausente como true e adiciona xlpsDefault a Subtotals quando o campo não carrega flags de subtotal explícitas, que é como o próprio Excel exibe um campo assim. Um containsString ausente também lê como true, então um campo de cache de texto simples é classificado como dados string. Leia qualquer um dos atributos como false e todo pivot salvo pelo Excel perde os subtotais automáticos no load, enquanto campos de texto viram algum outro tipo. Um escritor que sempre soletra todos os atributos nunca toca esse caminho; só arquivos de outro produtor o exercitam
Uma workbook carregada do Excel é a entrada de teste certa aqui, porque é o único tipo de arquivo que deixa esses atributos de fora. A conferência abaixo abre um e percorre um campo de linha:
var
  Book : TXLSXWorkbook;
  Pivot: TXLSPivotTable;
  Fld  : TXLSPivotField;
  I, J : Integer;
begin
  Book := TXLSXWorkbook.Create;
  try
    Book.Open('saved-by-excel.xlsx');
    Pivot := Book.Sheets[1].PivotTables.FindByName('PivotTable1');
    if Pivot = nil then
      Exit;
    for I := 0 to Pivot.FieldCount - 1 do
    begin
      Fld := Pivot.Fields[I];
      if Fld.Axis <> xlpfaRowField then
        Continue;
      // Um campo do Excel sem atributos de subtotal ainda reporta o default
      if xlpsDefault in Fld.Subtotals then
        Writeln(Fld.Name, ': automatic subtotal');
      // As entradas de subtotal foram puladas, então cada item mapeia para um valor de cache
      for J := 0 to Fld.ItemCount - 1 do
        Assert(Fld.Items[J].CacheItemIndex >= 0);  // conferência sugerida para os seus próprios testes
    end;
  finally
    Book.Free;
  end;
end;
Por que numFmtId="General" é inválido em campos de cache
numFmtId="General" é inválido porque ST_NumFmtId é um inteiro sem sinal, por mais natural que seja pegar emprestado o nome que os usuários veem no diálogo Format Cells. Um parser que tipa atributos a partir do schema rejeita o nome de cara, e essa classe de falha é exatamente o que vira diálogo de reparo no Excel; o artigo sobre as regras de OPC e markup por trás do prompt de reparo do Excel cobre como esses diálogos são disparados. O HotXLS grava todo cacheField com um numFmtId numérico tirado do NumberFormat do campo de cache, que é 0, o formato General embutido, a menos que algo o tenha definido
Pivot tables abaixo da linha 65535 precisam de posições de 32 bits
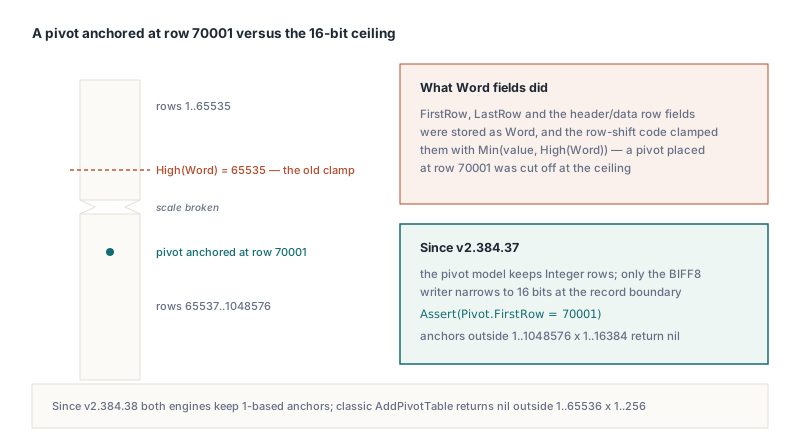
Um modelo de pivot compartilhado pelos engines XLS e XLSX fica tentado a pegar emprestadas as larguras de campo do registro SxView do BIFF8, onde 16 bits cobrem toda linha que uma planilha clássica consegue guardar. Uma planilha XLSX vai até 1,048,576 linhas. Guarde FirstRow, LastRow, FirstHeaderRow, FirstDataRow e os correspondentes de coluna como Word, trave-os com Min(Value, High(Word)), e um pivot ancorado na linha 70001 é cortado em 65535
No TXLSPivotTable, essas propriedades são Integer, e só o escritor BIFF8 as estreita na fronteira do registro. O TXLSXWorksheet.AddPivotTable retorna nil para uma âncora fora de 1..1048576 por 1..16384, e o AddPivotTableCopy retorna nil quando a extensão da cópia sairia da grade
var
  Book, Check: TXLSXWorkbook;
  Pivot      : TXLSPivotTable;
begin
  Book := TXLSXWorkbook.Create;
  try
    Book.Open('orders.xlsx');
    // A linha 70001 está além da faixa de 16 bits
    Pivot := Book.Sheets[1].AddPivotTable('Data!$A$1:$D$800', 70001, 1, 'LateTotals');
    if Pivot = nil then
      Exit;  // âncora fora da planilha ou intervalo de origem não resolvível
    Pivot.AddRowField('Region');
    Pivot.AddDataFieldByName('Revenue', xlpaSum);
    Book.SaveAs('late.xlsx');
  finally
    Book.Free;
  end;

  Check := TXLSXWorkbook.Create;
  try
    Check.Open('late.xlsx');
    Pivot := Check.Sheets[1].PivotTables.FindByName('LateTotals');
    // Assert é uma conferência sugerida para os seus próprios testes
    Assert((Pivot <> nil) and (Pivot.FirstRow = 70001));
  finally
    Check.Free;
  end;
end;
O engine XLS clássico segue a mesma convenção de base 1. Os registros SxView e DConRef guardam valores de base 0, enquanto o modelo, como o engine XLSX e Cells[Row, Col], mantém posições de base 1: o leitor BIFF8 soma 1 e o escritor subtrai 1 na fronteira do registro. O AddPivotTable clássico retorna nil para uma âncora fora de 1..65536 por 1..256, então ancore pivots em (1, 1) em vez de (0, 0). O layout do registro em si está descrito em os registros SX do BIFF8 por trás das tabelas dinâmicas de .xls clássico
Testando contra o schema em vez do seu próprio reader
Toda armadilha acima sobrevive a um round trip quando o lado tolerante e o lado falho vivem na mesma biblioteca. Três tipos de checagem os pegam. Uma validação de schema das partes pivotTableN.xml e pivotCacheDefinitionN.xml geradas pega tokens inventados, elementos items vazios e ids de formato nomeados. Arquivos salvos pelo Excel, passados pelo seu leitor, exercitam os atributos que o Excel omite nos defaults. Asserções que fixam o token exato no XML gravado, como axis="axisRow", pegam um escritor derivando para uma grafia que só o seu leitor entende; afirmar sobre o eixo parseado não consegue
Pivots construídos pela API, incluindo os calculated fields, calculated items e layouts percent-of-total mostrados em construir e atualizar tabelas dinâmicas XLSX com calculated fields, saem com essas regras aplicadas e sem código extra do seu lado. O trabalho que sobra para você é escolher quais campos ganham subtotais e qual função de count você quer dizer
O HotXLS Delphi spreadsheet component constrói, lê e salva tabelas dinâmicas XLS e XLSX a partir de código Delphi e C++Builder, sem instalação de Excel nem automação COM na máquina que o roda