O Excel mostra "We found a problem with some content" num XLSX que o LibreOffice e todo reader caseiro abrem sem reclamação porque o Excel impõe duas coisas que esses readers ignoram: atributos exigidos pelo schema e as regras de unicidade do Open Packaging Conventions. Três dessas regras são fáceis de quebrar em qualquer writer que combina partes geradas com partes preservadas: um <phoneticPr> precisa do fontId dele, cada nome de part recebe exatamente um Override no [Content_Types].xml, e duas root relationships nunca devem compartilhar um identificador como rId4. Este artigo percorre cada uma e como o HotXLS, o componente nativo de planilhas Excel para Delphi e C++Builder, escreve o pacote para satisfazê-la
Por que o Excel rejeita um pacote que todo outro leitor aceita?
Porque o prompt de reparo é um validador de schema e de pacote, não uma falha de parser. Um workbook pode fazer round trip pela sua própria library, pelo LibreOffice e por validadores XML, e estar estruturalmente sólido no sentido OPC usado no artigo sobre resolução de relationships OPC do XLSX: toda part alcançável, todo target resolvível. Abra por Workbooks.Open numa instância COM isolada com DisplayAlerts desligado e a chamada ainda pode falhar redonda. Interativamente o mesmo arquivo produz o diálogo familiar de oferecer reparo, e o repair log, quando o Excel se dá ao trabalho de escrever um, nomeia a part mas não a regra. Várias violações independentes podem se esconder atrás desse único prompt, e o Excel não as reporta uma de cada vez; ele rejeita o workbook e deixa você achá-las e analisá-las. O que segue é cada regra, o jeito natural de violá-la, e como o HotXLS escreve o pacote em vez disso, porque cada uma delas é uma regra em que todo writer XLSX em Delphi pode tropeçar
Regra 1: phoneticPr exige fontId, mesmo quando é zero
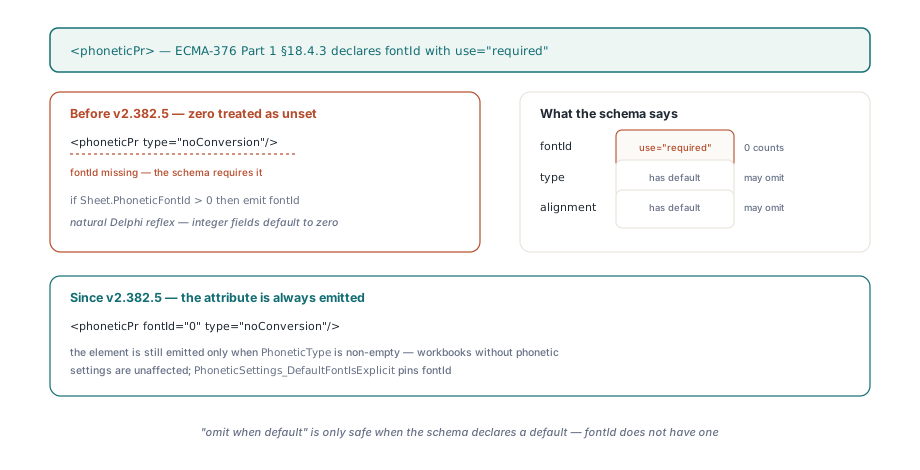
O elemento <phoneticPr> carrega um atributo fontId declarado use="required" na Parte 1 do ECMA-376 §18.4.3, e um valor de 0 é um índice de fonte válido, não uma ausência. Um writer que trata zero como "não definido" e só emite o atributo quando Sheet.PhoneticFontId > 0 segue um reflexo natural em Delphi, já que campos inteiros defaultam para zero, mas produz <phoneticPr type="noConversion"/> para qualquer workbook cuja fonte fonética por acaso seja a primeira fonte do styles.xml, o que é fácil de acontecer porque o índice 0 é simplesmente a primeira fonte. O Excel então rejeita, na volta, um valor que ele mesmo escreveu
// O reflexo natural: zero tratado como não definido, fontId descartado
phoneticXml:= '<phoneticPr';
if Sheet.PhoneticFontId > 0 then
  phoneticXml:= phoneticXml+ ' fontId="'+ IntToStr(Sheet.PhoneticFontId)+ '"';

// lxHandleX.pas, writer de worksheet — o atributo é obrigatório, zero incluído
phoneticXml:= '<phoneticPr fontId="'+ IntToStr(Sheet.PhoneticFontId)+ '"';
phoneticXml:= phoneticXml+ ' type="'+ XlsxEscapeAttr(Sheet.PhoneticType)+ '"';
if Sheet.PhoneticAlignment<> '' then
  phoneticXml:= phoneticXml+ ' alignment="'+ XlsxEscapeAttr(Sheet.PhoneticAlignment)+ '"';
O HotXLS emite o elemento só quando TXLSXWorksheet.PhoneticType não está vazio, então workbooks que nunca carregaram configurações fonéticas não são afetados. Defina PhoneticFontId como zero numa sheet nova, salve, e o xl/worksheets/sheet1.xml carrega <phoneticPr fontId="0". A lição mais ampla é que "omitir quando default" só é seguro quando o schema declara um default; type e alignment têm defaults nesse elemento, fontId não
Regra 2: um Override por nome de part em [Content_Types].xml
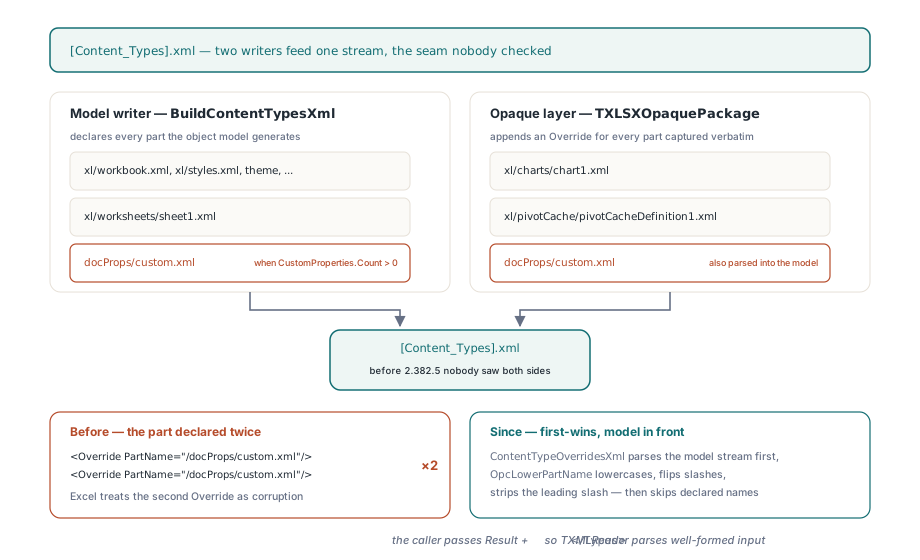
O stream de content types pode declarar cada nome de part no máximo uma vez, e o Excel trata um segundo Override para o mesmo PartName como corrupção mesmo quando ambas as entradas carregam o mesmo ContentType. O HotXLS tem dois writers alimentando esse stream. O BuildContentTypesXml declara toda part que o object model gera: workbook, styles, shared strings, theme, worksheets e, quando TXLSXWorkbook.CustomProperties.Count > 0, /docProps/custom.xml. Quando PreserveUnsupportedParts está ligado, o TXLSXOpaquePackage então anexa um Override para cada part que capturou verbatim do pacote de origem para que esses bytes continuem declarados na saída. A colisão é uma part que vive dos dois lados. Custom document properties são parseadas para o model, mas o docProps/custom.xml do pacote de origem também é capturado de forma opaca, então um merge ingênuo o declara duas vezes, e parts de chart e pivot cache podem cair no mesmo lugar quando o model regenera uma part que a camada opaca também reteve. Um writer opaco sem visão do que o model já escreveu não pode saber, e é por isso que o ContentTypeOverridesXml recebe essa visão
<!-- O que um merge ingênuo produz -->
<Override PartName="/docProps/custom.xml"
    ContentType="application/vnd.openxmlformats-officedocument.custom-properties+xml"/>
...
<Override PartName="/docProps/custom.xml"
    ContentType="application/vnd.openxmlformats-officedocument.custom-properties+xml"/>
O HotXLS passa o XML gerado para o ContentTypeOverridesXml e deixa o writer opaco parseá-lo antes de emitir qualquer coisa. Dois detalhes carregam a correção. O OpcLowerPartName põe em lowercase, vira backslashes em forward slashes e remove slashes iniciais antes de comparar, porque nomes de part OPC são comparados case-insensitive e o model os escreve com slash inicial enquanto a camada opaca guarda nomes de item ZIP sem um. E o caller no BuildContentTypesXml passa Result + '</Types>', fechando o documento parcialmente construído para que o TXMLReader veja input bem formado em vez de um stream truncado. A regra que emerge é first-wins com o model na frente: o que o object model declara é autoritativo, e o replay opaco só preenche buracos
// lxOpcPackage.pas — TXLSXOpaquePackage.ContentTypeOverridesXml
function TXLSXOpaquePackage.ContentTypeOverridesXml(const ExistingXml: WideString): WideString;
begin
  ...
  UsedNames.Sorted:= True;
  UsedNames.Duplicates:= dupIgnore;
  if ExistingXml<> '' then
    // Analisa o stream gerado pelo modelo e coleta todo PartName declarado.
    while Reader.Read do
      if (Reader.NodeType= xmlntElement)and (Reader.Name= 'Override') then
      begin
        Index:= Reader.AttributeIndex('PartName');
        if Index>= 0 then
          UsedNames.Add(String(OpcLowerPartName(Reader.Attribute[Index].Value)));
      end;
  for i:= 0 to FParts.Count- 1 do
  begin
    Part:= TXLSXOpaquePart(FParts[i]);
    if (Part.ContentType= '')or (LowerCase(ExtractFileExt(String(Part.PartName)))= '.rels')or
      (UsedNames.IndexOf(String(OpcLowerPartName(Part.PartName)))>= 0) then
      Continue;                       // já declarado, ou uma part rels
    UsedNames.Add(String(OpcLowerPartName(Part.PartName)));
    Result:= Result+ '<Override PartName="/'+ OpcXmlEscapeAttribute(Part.PartName)+
      '" ContentType="'+ OpcXmlEscapeAttribute(Part.ContentType)+ '"/>';
  end;
end;
Regra 3: ids de relacionamento são únicos dentro de uma part de relacionamentos
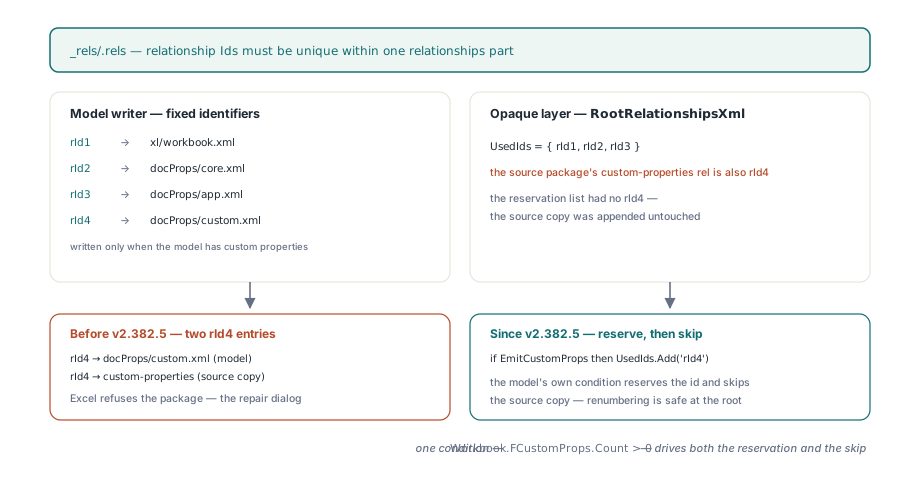
Todo Relationship numa part .rels precisa de um Id único dentro dessa part, e o Excel recusa o pacote quando dois compartilham um. O HotXLS escreve o _rels/.rels de nível de pacote com identificadores fixos: rId1 para o workbook, rId2 e rId3 para core e extended document properties, e rId4 para custom properties quando o model tem alguma. O pacote opaco então anexa as root relationships que reteve da origem, renumerando qualquer identificador já numa lista UsedIds. Se essa lista só conhece rId1 a rId3, e não sabe que o model está prestes a emitir o relationship de custom properties dele, um pacote de origem cujo relationship de custom properties também é rId4, que é o que o Excel escreve por default, sai com duas entradas rId4 apontando para o mesmo target. O RootRelationshipsXml portanto reserva o rId4 e pula a cópia da origem sempre que o model emite custom properties. O caller, BuildRootRelsXml, passa Workbook.FCustomProps.Count > 0 como segundo argumento, então a reserva e o pulo são guiados pela mesma condição que decide se o model emite rId4 ou não. Renumerar é seguro na raiz do pacote porque nada dentro do workbook referencia identificadores de root relationship pelo nome; o mesmo truque seria errado um nível abaixo, onde atributos r:id no workbook.xml se ligam a identificadores na part de relationships do workbook, e é por isso que o MergeWorkbookRelationshipsXml mantém um mapa de identificadores separado
// lxOpcPackage.pas — TXLSXOpaquePackage.RootRelationshipsXml
UsedIds.CaseSensitive:= False;
UsedIds.Add('rId1');
if EmitCustomProps then UsedIds.Add('rId4');   // reservado pelo writer do model
if EmitDocProps then
begin
  UsedIds.Add('rId2');
  UsedIds.Add('rId3');
end;
for i:= 0 to FRootRelationships.Count- 1 do
begin
  Rel:= TXLSXOpaqueRelationship(FRootRelationships[i]);
  // O model é dono das custom properties; não replique a cópia da origem.
  if EmitCustomProps and OpcEndsWith(LowerCase(Rel.RelType), '/custom-properties') then
    Continue;
  Id:= Rel.Id;
  if (Id= '')or (UsedIds.IndexOf(String(Id))>= 0) then
    Id:= AllocateRelationshipId(UsedIds);      // menor rIdN livre
  UsedIds.Add(String(Id));
  ...
end;
O que as três regras têm em comum?
As três protegem contra um writer com duas fontes e nenhum dono único dos invariantes do pacote. O object model gera as parts que entende; a camada opaca replica as que não entende, para que um round trip mantenha charts, pivot caches, custom XML e todo o resto descrito nas notas sobre round trip sem perda de theme, extLst e calcChain. Cada lado pode ser consistentemente individual. As restrições que o OPC põe no pacote inteiro, nomes de Override únicos e identificadores de relationship únicos por part, só existem na emenda onde os dois são concatenados, então algo tem que ser dono da emenda. A regra do fontId é a mesma forma um nível abaixo: um writer pode saber o que quer omitir e nunca consultar o schema que diz que não pode. O HotXLS resolve isso com uma precedência fixa em vez de uma heurística de merge. O model escreve primeiro, e a camada opaca vê o que foi escrito e cede em qualquer colisão. Os invariantes também são baratos de checar por fora: leia o [Content_Types].xml e todo item .rels de um pacote salvo e falhe em qualquer PartName, Extension ou Id duplicado. Essa checagem não precisa de Excel e cobre as duas regras de unicidade; a regra do fontId ainda precisa de um validador de schema
Print areas que são fórmulas, não ranges
A print area é a outra coisa que o Excel compara numa cópia salva: um template cujo _xlnm.Print_Area o Excel reporta como $A$1:$J$29 precisa reportar identicamente depois de um round trip. Duas armadilhas ficam por trás disso. Na importação, um strip de prefixo que corta tudo até o primeiro ! sem aspas transforma uma print area dinâmica como OFFSET('Print Data'!$A$1,0,0,2,2) em $A$1,0,0,2,2), e faz uma union qualificada como 'Print Data'!$A$1:$B$2,'Print Data'!$D$1:$E$2 perder o prefixo só no primeiro segmento. Na exportação, prefixar o nome da sheet uma vez ao PrintArea armazenado por inteiro dá a uma union plain $A$1:$B$2,$D$1:$E$2 um primeiro segmento qualificado e um segundo nu, que o Excel não aceita como definição de _xlnm.Print_Area na Parte 1 do ECMA-376 §18.2.5
// Importação: só tira o prefixo quando o que resta é um sqref simples
function XlsxPrintAreaFromDefinition(const Formula: WideString): WideString;
begin
  Result:= Formula;
  if not XlsxReadFormulaSheetPrefixAt(Formula, 1, Prefix, SheetPart, Start) then
    Exit;
  Area:= Copy(Formula, Start, Length(Formula));
  if XlsxParseSqrefPart(Area, R1, C1, R2, C2) then
    Result:= Area;                    // 'Sheet'!$A$1:$J$29 -> $A$1:$J$29
end;                                  // OFFSET(...) volta sem alteração

// Exportação: qualifica todo segmento separado por vírgula, ou nenhum
function XlsxPrintAreaDefinition(const SheetName, Area: WideString): WideString;
begin
  Result:= Area;
  ... split Area on ',' with StrictDelimiter ...
  for I:= 0 to Parts.Count- 1 do
    if not XlsxParseSqrefPart(WideString(Trim(Parts[I])), R1, C1, R2, C2) then
      Exit;                           // uma fórmula: emite verbatim
  Result:= '';
  for I:= 0 to Parts.Count- 1 do
  begin
    if I> 0 then Result:= Result+ ',';
    Result:= Result+ XlsxQuoteSheetName(SheetName)+ '!'+ WideString(Trim(Parts[I]));
  end;
end;
A regra de pareamento é a mesma dos dois lados: uma print area é um range nu só se todo segmento parseia como um, senão é uma fórmula e viaja verbatim. Com essa regra, a base nomeada, a base qualificada por sheet e a union sobrevivem a ciclos repetidos de salvar e reabrir. Como print areas interagem com page setup e com o resto do modelo de impressão está coberto no artigo sobre proteção de sheet, page setup e impressão
Como descobrir a qual regra o Excel está se opondo?
Comece da suposição de que o seu validador próprio está errado, porque ele passou. O validador do Open XML SDK vai nomear uma violação de schema como o fontId faltante com a part e o XPath, e a camada de packaging por baixo recusa logo abrir um pacote com entradas de content type duplicadas, então rode-o antes de qualquer coisa. Quando ele está calado e o Excel ainda repara, faça bisseção do pacote: unzip, apague uma part, o relationship dela e o Override dela, rezip e reabra, dividindo o conjunto candidato pela metade a cada vez até o prompt desaparecer. As três violações acima aparecem nessa ordem, e nenhuma delas seria visível no arquivo reparado que o Excel oferece salvar, já que o reparo descarta ou renumera silenciosamente as entradas ofensoras. Duas escolhas de design no writer do HotXLS valem conhecer. A deduplicação é first-wins com o model na frente, então se o pacote de origem declarou um content type diferente para uma part que o model também gera, a declaração do model vence e a da origem é descartada, o que é correto para as parts que o HotXLS regenera e não é um merge geral. E a passada extra de TXMLReader sobre o stream de content types gerado roda a cada save com PreserveUnsupportedParts habilitado, um custo pequeno contra um stream que raramente passa de alguns kilobytes. Com essas regras no lugar, um template de empréstimo de 4805 fórmulas salvo pelos builds Win32 e Win64 abre no Excel sem prompt, recalcula com zero mismatch e reporta a mesma print area que o original
Se você escreve XLSX por conta própria em Delphi, a lista de verificação é curta: emita todo atributo que o esquema marca como obrigatório, independentemente do valor, declare cada nome de part uma vez e mantenha uma única lista de identificadores usados por part de relacionamentos em todos os writers que a tocam. Se você preferir que essa lista já exista e seja testada contra o Excel, e não só contra o seu próprio leitor, o writer de pacote descrito aqui vem no componente de planilha Delphi HotXLS, junto com o round-trip de parts opacas que fez a costura valer a pena proteger desde o começo