Camadas de texto OCR, bounds de barcode e boxes de face redaction derivam em páginas de PDF recortadas quando os pixels do bitmap são mapeados de volta pelo MediaBox em vez de pela caixa que o renderer de fato rasterizou: o CropBox clipado ao MediaBox (ISO 32000-1 §14.11.2). O HotPDF mapeia os resultados do ApplyLoadedOCRTextLayer, do DecodeLoadedPageBarcodes e do DetectLoadedRedactionFindings por essa caixa visível, e qualquer engine ou detector custom que você escrever precisa fazer o mesmo
O sintoma é fácil de reconhecer depois que você já viu uma vez. Uma archive de contratos escaneados passa por OCR, o output é pesquisável, e o hit de busca de um número de cláusula é destacado meia polegada abaixo e à esquerda do número impresso. A maioria dos arquivos do lote está bem. Os deslocados todos vieram de uma estação de digitalização que escreve um /CropBox para aparar a margem do vidro. Esse único detalhe separa a imagem que a engine OCR viu do frame em que a camada de texto foi colocada, e o mesmo desencontro move bounds de barcode e, mais sério ainda, boxes de face redaction
Por que a camada de texto OCR deriva das palavras escaneadas?
A camada de texto deriva quando duas metades do pipeline discordam sobre qual retângulo o bitmap cobre. A renderização do HotPDF, o export SVG, o viewer e a impressão todos honram o CropBox: uma página é exibida através do CropBox dela clipado ao MediaBox, que é o que a ISO 32000-1 §14.11.2 prescreve, e o GetLoadedPageVisibleBox retorna essa caixa visível. Uma transform device-to-page construída a partir do GetLoadedPageBox(PageIndex, pbMediaBox, ...) assume que o raster cobre o MediaBox, então o raster e a transform descrevem retângulos diferentes e toda posição reconhecida volta deslocada pelo vão entre as duas
Acertar isso significa manter três coisas em acordo para cada feature de reconhecimento: a transform, a estimativa de orçamento de pixels, e a page box entregue a uma engine custom no request record. O HotPDF deriva as três da caixa visível, o que também significa que o reconhecimento só vê conteúdo que viewers de fato mostram
Alguns casos são imunes ao desencontro:
- Páginas sem
/CropBox, ou cujo CropBox iguala o MediaBox, mapeiam identicamente por qualquer uma das caixas DecodeLoadedPageBarcodescomHasRegionsetado renderiza exatamente a region que você passa e mapeia por essa mesma region; a checagem de que a region está dentro da página usa o MediaBox- Redaction findings baseados em pattern (emails, números de cartão e afins) vêm da extração de texto em user space, não de um raster, então só os findings de face detection dependem do mapeamento do raster
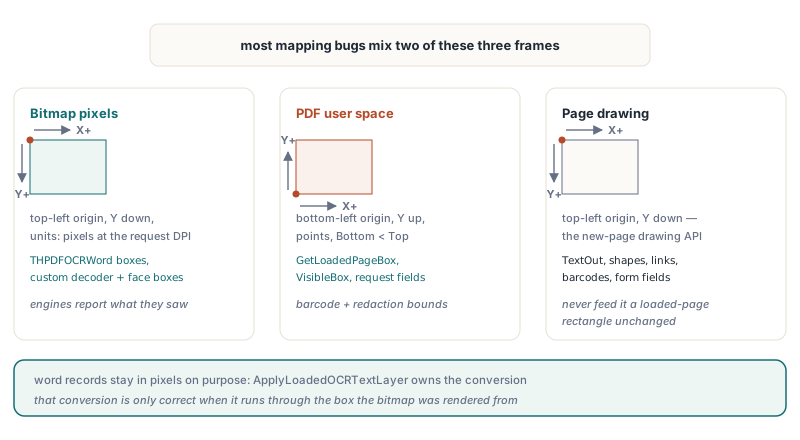
Três frames de coordenadas, e quais APIs do HotPDF usam cada um
Código que toca o reconhecimento do HotPDF lida com três frames, e a maioria dos erros de mapeamento vem de misturar dois deles
- Bitmap pixels: origem no topo à esquerda, Y cresce para baixo, unidades são pixels no DPI do request.
THPDFOCRWord.Left,Top,RighteBottomestão nesse frame, assim como os baseline points opcionais, os resultados que umIHPDFBarcodeDecodercustom retorna, e as boxes de umIHPDFFaceDetectorcustom - PDF user space de uma página carregada: origem na base à esquerda, Y cresce para cima, unidades são pontos, com
Bottom < Top. OGetLoadedPageBoxe oGetLoadedPageVisibleBoxretornam Left, Bottom, Right, Top nesse frame, e o mesmo vale para os camposPageLeft,PageBottom,PageRightePageTopdoTHPDFOCRRequest, os bounds noTHPDFDecodedBarcodee os retângulos noTHPDFRedactionFinding - Coordenadas de desenho de página do HotPDF: a API que você usa para construir páginas novas (output de texto, shapes, barcodes, links, form fields) trabalha com origem no topo à esquerda e Y crescendo para baixo. Esse frame pertence à geração de documentos e não tem nada a ver com as APIs de documento carregado acima, então nunca alimente um retângulo em user space de página carregada nele sem alterar
O word record de OCR é deliberadamente baseado em pixels: uma engine reporta o que viu na imagem, e o ApplyLoadedOCRTextLayer é dono da conversão. Essa divisão de trabalho só funciona quando a conversão usa a caixa certa, e é por isso que o HotPDF a constrói a partir da caixa visível
A transform device-to-page por trás de OCR, barcodes e faces
O HotPDF mapeia bitmap pixels para a página com uma única matriz afim construída de cinco inputs: a rotação, a escala DPI / 72, a altura do bitmap, e o Left, Bottom, Right e Top da caixa renderizada. OCR, decodificação de barcode e face detection compartilham uma única rotina para isso, então a caixa de input decide a precisão dos três de uma vez. Para uma página não rotacionada, a matriz page-to-device [A B C D E F] é:
A = ScaleeD = -Scale, ondeScale = DPI / 72; oDnegativo vira user space (Y para cima) em bitmap space (Y para baixo)B = C = 0, porque uma página não rotacionada não tem shear nem troca entre eixosE = -Left * Scale, que move a borda esquerda da caixa para a coluna de pixel 0F = BitmapHeight + Bottom * Scale, que mapeia a borda inferior da caixa para y = BitmapHeight, a borda de baixo do bitmap, então a borda superior pousa na linha 0
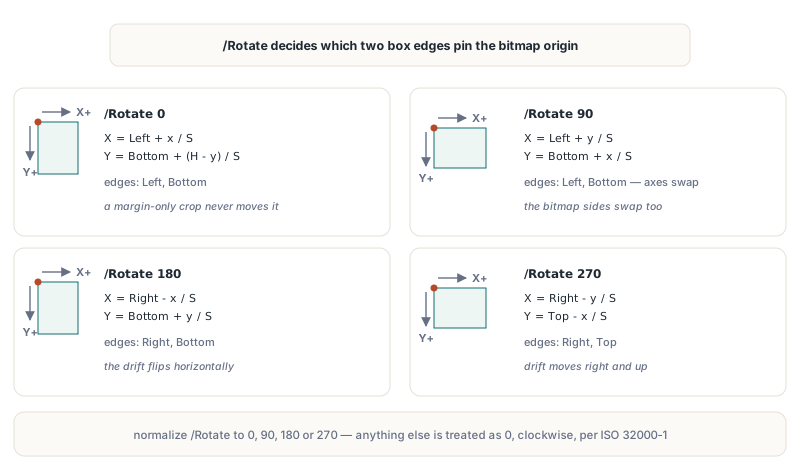
Os pixels voltam para a página pelo inverso dessa matriz. O Request.PageRotation carrega o /Rotate da página normalizado para 0, 90, 180 ou 270 (qualquer valor que não é múltiplo de 90 é tratado como 0), e o renderer gira a página no sentido horário como a ISO 32000-1 §7.7.3.3 exige. Sob rotação os eixos trocam e um par diferente de bordas da caixa é pregado na origem do bitmap. Escrito como fórmulas inversas, com S = DPI / 72, x e y em pixels e H a altura do bitmap:
| /Rotate | Página X | Página Y | Bordas da caixa de que o mapeamento depende |
|---|---|---|---|
| 0 | Left + x / S | Bottom + (H - y) / S | Left, Bottom |
| 90 | Left + y / S | Bottom + x / S | Left, Bottom |
| 180 | Right - x / S | Bottom + y / S | Right, Bottom |
| 270 | Right - y / S | Top - x / S | Right, Top |
A última coluna explica por que um mapeamento baseado no MediaBox parece aleatório em produção. Um CropBox que apara só o topo da página deixa Left e Bottom intactos, então páginas em pé saem perfeitas e só páginas carregando /Rotate 270 derivam. A rotação também troca as dimensões do bitmap: a 90 e a 270 o bitmap tem (Top - Bottom) * S pixels de largura e (Right - Left) * S pixels de altura
O que dá errado com MediaBox [0 0 612 792] e CropBox [36 36 576 756]?
Com um recorte de meia polegada em cada lado, a camada de texto de uma página não rotacionada pousa exatamente 36 pontos à esquerda e 36 pontos abaixo das palavras escaneadas quando o MediaBox é usado. Tome uma página US Letter cujo CropBox apara 36 pontos (0.5 inch) de cada borda. A caixa visível é de 540 por 720 pontos, então na resolução OCR default de 300 DPI a escala é 300 / 72 ≈ 4.1667 e o bitmap é de 2250 por 3000 pixels
Suponha que a engine reporte uma palavra com pixel box Left 450, Top 600, Right 900, Bottom 660 e sem baseline. O HotPDF então coloca a baseline a 20 por cento da altura da palavra acima da borda inferior, na linha de pixel 648, e mapeia o ponto inicial (450, 648):
- Pela caixa visível: x = 36 + 450 / 4.1667 = 144.0 e y = 36 + (3000 - 648) / 4.1667 = 600.48, que é onde a palavra está impressa
- Pelo MediaBox: x = 0 + 108.0 = 108.0 e y = 0 + 564.48 = 564.48, um deslocamento uniforme de (-36, -36) pontos
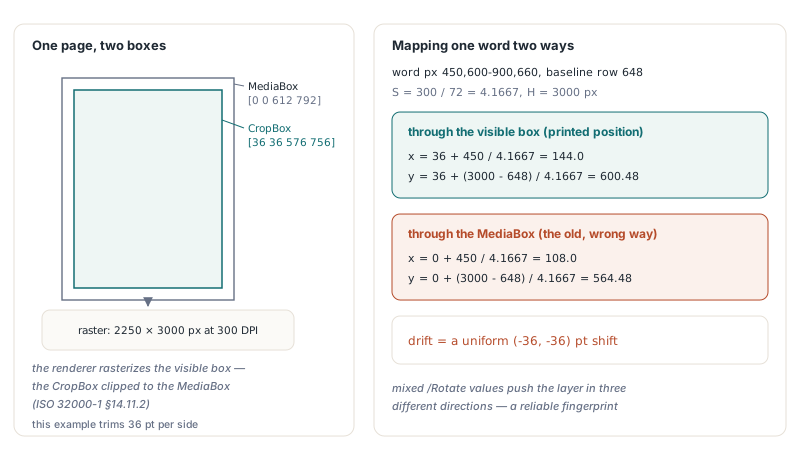
Gire a mesma página e a direção do erro muda, porque bordas diferentes entram em cena. Em /Rotate 180 o termo X usa Right, e 612 em vez de 576 empurra a camada 36 pontos para a direita enquanto Bottom ainda a puxa 36 pontos para baixo. Em /Rotate 270 tanto Right quanto Top são grandes demais, então a camada se move 36 pontos para a direita e 36 pontos para cima. Um documento com orientações mistas pode mostrar a deriva em três direções, uma fingerprint confiável desse erro. Código escrito à mão que deriva a escala da caixa, como Bitmap.Width / (Right - Left), também estica toda coordenada por 612 / 540, aproximadamente 13 por cento, por cima do offset
Quais das suas páginas de PDF precisam de mapeamento consciente do CropBox?
Um documento PDF pede atenção quando pelo menos uma página tem uma caixa visível que difere do MediaBox dela, e o HotPDF pode te dizer isso em poucas linhas. Compare o GetLoadedPageBox com pbMediaBox contra o GetLoadedPageVisibleBox para cada página, e imprima o GetLoadedPageRotation ao lado para poder prever a direção da deriva pela tabela acima. O THPDFPageBoundary também oferece pbCropBox, pbBleedBox, pbTrimBox e pbArtBox, mas o GetLoadedPageBox(pbCropBox) cai para o MediaBox quando não existe crop box e não clipa, então a caixa visível é a coisa certa para comparar
uses
  System.SysUtils, HPDFDoc;

procedure ReportCroppedPages(const FileName: string);
var
  Pdf: THotPDF;
  I: Integer;
  ML, MB, MR, MT, VL, VB, VR, VT, Tmp: Single;
begin
  Pdf := THotPDF.Create(nil);
  try
    if Pdf.LoadFromFile(FileName) < 1 then
      raise Exception.Create('Cannot load ' + FileName);
    for I := 0 to Pdf.LoadedPageCount - 1 do
    begin
      if not Pdf.GetLoadedPageBox(I, pbMediaBox, ML, MB, MR, MT) then
        Continue;
      // o array guardado pode listar os cantos dele em qualquer ordem
      if MR < ML then begin Tmp := ML; ML := MR; MR := Tmp; end;
      if MT < MB then begin Tmp := MB; MB := MT; MT := Tmp; end;
      // já normalizada e clipada ao MediaBox
      if not Pdf.GetLoadedPageVisibleBox(I, VL, VB, VR, VT) then
        Continue;
      if (Abs(VL - ML) > 0.01) or (Abs(VB - MB) > 0.01) or
         (Abs(VR - MR) > 0.01) or (Abs(VT - MT) > 0.01) then
        Writeln(Format('Page %d  MediaBox [%g %g %g %g]  visible [%g %g %g %g]  /Rotate %d',
          [I + 1, ML, MB, MR, MT, VL, VB, VR, VT,
           Pdf.GetLoadedPageRotation(I)]));
    end;
  finally
    Pdf.Free;
  end;
end;
Dois detalhes do GetLoadedPageVisibleBox importam para scripts como este. A função deixa os out parameters dela intactos quando falha, então pré-setar um tamanho de página default antes da chamada é um padrão seguro. E quando um CropBox malformado não intercepta o MediaBox de forma alguma, a função retorna o MediaBox em vez de um retângulo vazio. Se o relatório lista páginas que um pipeline anterior fez OCR através de um mapeamento baseado no MediaBox, lembre de que a camada de texto efetivada permanece no arquivo salvo: a opção default SkipPagesWithText vai pular essas páginas numa segunda passada a menos que você a desligue ou remova a camada velha primeiro
Como uma IHPDFOCREngine custom deve mapear pixels de volta para o espaço do PDF?
Uma IHPDFOCREngine custom deve retornar word boxes em bitmap pixels e deixar o HotPDF fazer o mapeamento; converta para user space só para as suas próprias decisões, e então use a caixa do request, nunca o MediaBox. Os PageLeft, PageBottom, PageRight e PageTop do request descrevem a caixa visível renderizada, então eles batem com o Request.Bitmap exatamente. O helper abaixo é o inverso da transform da biblioteca, incluindo o uso dela da altura real do bitmap para páginas em pé, então ele concorda com o HotPDF ao pixel
uses
  System.SysUtils, System.Math, Vcl.Graphics, HPDFDoc;

// Pixel de bitmap (origem topo esquerda, Y para baixo) para user space de PDF
// (origem base esquerda, Y para cima), pela caixa da qual o bitmap foi renderizado
procedure HotPixelToPage(Rotation, DPI, BitmapHeight: Integer;
  Left, Bottom, Right, Top: Single; X, Y: Double;
  out PageX, PageY: Double);
var
  S: Double;
begin
  S := DPI / 72.0;
  case Rotation of
    90:  begin PageX := Left + Y / S;  PageY := Bottom + X / S; end;
    180: begin PageX := Right - X / S; PageY := Bottom + Y / S; end;
    270: begin PageX := Right - Y / S; PageY := Top - X / S; end;
  else
    PageX := Left + X / S;
    PageY := Bottom + (BitmapHeight - Y) / S;
  end;
end;
Um motivo realista para precisar de user space dentro de uma engine é uma regra de zona: faturas cujo letterhead você nunca quer pesquisável, ou uma área de carimbo que confunde o recognizer. A engine abaixo, escrita com TInterfacedObject para que o reference counting cuide do lifetime dela, filtra palavras por onde os centros delas caem na página, e então retorna as sobreviventes intactas em coordenadas de pixel. O RunRecognizer representa a chamada do seu próprio recognizer
type
  TZoneFilterOCREngine = class(TInterfacedObject, IHPDFOCREngine)
  private
    FSkipLeft, FSkipBottom, FSkipRight, FSkipTop: Single;  // user space
    function RunRecognizer(Bitmap: TBitmap; MaxWords: Integer;
      out Words: THPDFOCRWords): boolean;  // seu recognizer, boxes em pixels
  public
    constructor Create(SkipLeft, SkipBottom, SkipRight, SkipTop: Single);
    function GetName: AnsiString;
    function Recognize(const Request: THPDFOCRRequest;
      out Words: THPDFOCRWords; out Diagnostic: AnsiString): boolean;
  end;

function TZoneFilterOCREngine.Recognize(const Request: THPDFOCRRequest;
  out Words: THPDFOCRWords; out Diagnostic: AnsiString): boolean;
var
  Raw: THPDFOCRWords;
  I, Count: Integer;
  CX, CY: Double;
begin
  Diagnostic := '';
  SetLength(Words, 0);
  if not RunRecognizer(Request.Bitmap, Request.MaxWords, Raw) then
  begin
    Diagnostic := 'recognizer failed';
    Exit(False);
  end;
  SetLength(Words, Length(Raw));
  Count := 0;
  for I := 0 to High(Raw) do
  begin
    HotPixelToPage(Request.PageRotation, Request.DPI,
      Request.Bitmap.Height, Request.PageLeft, Request.PageBottom,
      Request.PageRight, Request.PageTop,
      (Raw[I].Left + Raw[I].Right) / 2, (Raw[I].Top + Raw[I].Bottom) / 2,
      CX, CY);
    if (CX >= FSkipLeft) and (CX <= FSkipRight) and
       (CY >= FSkipBottom) and (CY <= FSkipTop) then
      Continue;
    Words[Count] := Raw[I];  // ainda pixels: o HotPDF os mapeia ele mesmo
    Inc(Count);
  end;
  SetLength(Words, Count);
  Result := True;
end;
Entregue a engine ao ApplyLoadedOCRTextLayer(PageIndices, Engine, Options, Info) como com qualquer outra engine. A biblioteca valida o que volta antes de confiar nele: uma palavra é descartada e contada no Info.DroppedWordCount quando a box dela sai do bitmap, quando Right <= Left ou Bottom <= Top, ou quando a Confidence está fora de 0..1 ou abaixo do MinimumConfidence. Retornar mais palavras que MaxWordsPerPage, ou empurrar o total corrente além do MaxTotalWords, derruba a chamada inteira com um erro de budget, então honre o Request.MaxWords na engine. Não converta word boxes para user space antes de retorná-las; o HotPDF trataria os valores de ponto como pixels e a camada colapsaria para a origem do bitmap
Mapeando o output do seu próprio detector
O mesmo helper serve um pipeline caseiro construído sobre o RenderLoadedPageToBitmap, que renderiza a caixa visível e aplica o /Rotate exatamente como as features de reconhecimento fazem. Leia a caixa com o GetLoadedPageVisibleBox, normalize a rotação do mesmo jeito que o HotPDF faz, e mapeie dois cantos opostos de cada pixel box. O eixo Y vira e, a 90 e 270 graus, os eixos trocam, então os cantos mapeados saem sem ordem fixa; tome o mínimo e o máximo dos pontos mapeados, que é também como o HotPDF constrói os bounds de barcode
const
  DPI = 200;
var
  Pdf: THotPDF;
  Bmp: TBitmap;
  VL, VB, VR, VT: Single;
  Rotation: Integer;
  PxL, PxT, PxR, PxB, X1, Y1, X2, Y2: Double;
begin
  Pdf := THotPDF.Create(nil);
  try
    Pdf.LoadFromFile('scanned-ids.pdf');
    if not Pdf.GetLoadedPageVisibleBox(0, VL, VB, VR, VT) then Exit;
    Rotation := Pdf.GetLoadedPageRotation(0) mod 360;
    if Rotation < 0 then Inc(Rotation, 360);
    if (Rotation <> 90) and (Rotation <> 180) and (Rotation <> 270) then
      Rotation := 0;
    Bmp := Pdf.RenderLoadedPageToBitmap(0, DPI);
    if Bmp = nil then Exit;
    try
      MyDetector(Bmp, PxL, PxT, PxR, PxB);  // seu código, box em pixels
      HotPixelToPage(Rotation, DPI, Bmp.Height, VL, VB, VR, VT,
        PxL, PxT, X1, Y1);
      HotPixelToPage(Rotation, DPI, Bmp.Height, VL, VB, VR, VT,
        PxR, PxB, X2, Y2);
      Writeln(Format('User-space box [%.2f %.2f %.2f %.2f]',
        [Min(X1, X2), Min(Y1, Y2), Max(X1, X2), Max(Y1, Y2)]));
    finally
      Bmp.Free;
    end;
  finally
    Pdf.Free;
  end;
end;
O comportamento de rotação está coberto com mais profundidade em achatar rotação de página sem quebrar as page boxes, e o pipeline de decodificação de barcode que consome a mesma transform em decodificar QR codes rotacionados de páginas de PDF. Se a sua engine embrulha um recognizer externo, o adapter Tesseract OCR para PDF pesquisável mostra o lado de isolamento de processo e cancelamento da mesma interface
Referência rápida: mapeamento de coordenadas safe contra CropBox
- O renderer rasteriza a caixa visível, o CropBox clipado ao MediaBox (ISO 32000-1 §14.11.2); todo mapeamento pixel-to-page precisa usar essa caixa, lida com o
GetLoadedPageVisibleBox ApplyLoadedOCRTextLayer, oDecodeLoadedPageBarcodesde página inteira e os face findings doDetectLoadedRedactionFindingsmapeiam todos pela caixa visível, e qualquer engine ou detector custom também deve- Boxes de
THPDFOCRWordsão bitmap pixels com origem topo esquerda; oGetLoadedPageBoxe oGetLoadedPageVisibleBoxretornam PDF user space com origem base esquerda eBottom < Top - A escala é
DPI / 72; derive-a do DPI, nunca de uma page box dividida na largura do bitmap - O /Rotate decide quais bordas importam: Left e Bottom a 0 e 90, Right e Bottom a 180, Right e Top a 270
- Retorne palavras de OCR em pixels e deixe o HotPDF mapeá-las; converta só para a sua própria lógica de filtragem
- Ao rodar OCR de novo em páginas que já carregam uma camada de texto, lembre de que o
SkipPagesWithTextas pula a menos que você o desligue ou remova a camada velha primeiro
As features de reconhecimento, as queries de page box e a renderização de documento carregado usadas aqui saem todas no componente HotPDF para Delphi e C++Builder; licensing, downloads de teste e a lista completa de features estão na página do componente HotPDF PDF para Delphi