O primeiro objeto de um PDF linearizado tem que declarar o comprimento exato do arquivo em que ele vive, até o byte, e tem que aparecer dentro dos primeiros 1024 bytes. O Anexo F da ISO 32000-1 chama essa entrada de /L, e um leitor que a encontrar em desacordo com o tamanho real do arquivo é instruído a tratar o documento como um PDF comum e ignorar todo hint de linearização dentro dele. Então o writer precisa imprimir o comprimento de um arquivo que ele ainda não terminou de escrever, ao lado do offset de um hint stream, do fim da primeira página e da posição de uma tabela de cross-reference perto do fim do arquivo. Os quatro números se movem sempre que qualquer coisa à frente deles muda de tamanho
O retorno é o Fast Web View. Um PDF comum mantém a tabela de cross-reference dele no fim, então um navegador que recebe um relatório escaneado de 200 páginas não consegue localizar a página 1 até o último byte chegar; um arquivo linearizado move a página 1 e uma pequena seção de cross-reference para a frente, para que um cliente usando requisições de range HTTP pinte a primeira página cedo. O que se segue é o lado da escrita. O quadro do lado do leitor está na explicação de linearização de PDF e Fast Web View
Como o HotPDF dispõe um arquivo linearizado
O HotPDF escreve saída linearizada quando THotPDF.LinearizeOutput é True, e o arquivo segue a ordem física que o Anexo F prescreve, parte por parte. Depois do header vem o dicionário de parâmetros de linearização, então a seção de cross-reference da primeira página e o trailer dela, o catálogo com os outros objetos de nível de documento, o hint stream primário, a primeira página com todo objeto de que ela precisa, as páginas restantes em ordem, os objetos compartilhados entre páginas posteriores, todo o resto e, por fim, a tabela de cross-reference principal
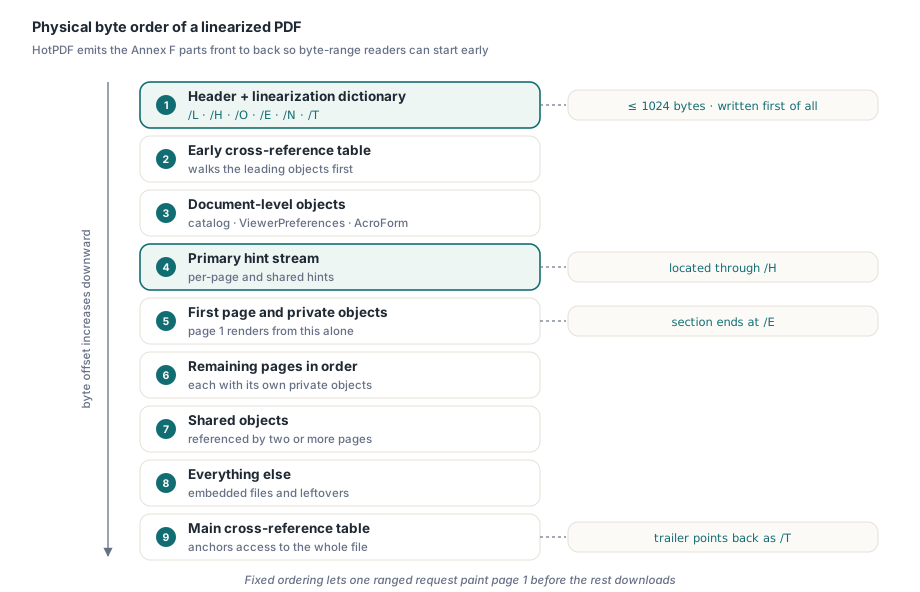
Nada no modelo de documento diz a qual parte um objeto pertence. O writer descobre isso a partir do grafo de referências quando o EndDoc salva, caminhando a partir de cada objeto de página e contando quantas páginas alcançam cada objeto indireto. Um objeto alcançado por uma página vai para a seção dessa página. Um objeto alcançado por várias páginas é compartilhado, com uma reviravolta que uma leitura rápida da spec perde: quando a página 1 está entre as páginas que o usam, o objeto vai para a seção da primeira página mesmo assim, porque a página 1 precisa renderizar só com os bytes da frente. Só objetos compartilhados puramente entre páginas posteriores esperam na parte compartilhada. O catálogo, apontem as entradas /ViewerPreferences, /OpenAction, /Threads e /AcroForm dele para onde apontarem, e o dicionário de criptografia de um documento protegido formam o grupo de nível de documento. Nós de page tree são empurrados para a parte final para que nunca inflacionem a primeira página
Abra a saída num editor hex e a numeração parece ao contrário. O bloco da frente, do dicionário de linearização até o hint stream, carrega os números de objeto mais altos do arquivo, enquanto tudo depois dele é numerado a partir de 1. A pequena seção de cross-reference na frente cobre exatamente esse bloco alto, e a tabela principal cobre de 1 a N
Uma armadilha de inicialização de record em listas de partição
Listas como essas naturalmente são escritas como um record guardando um array dinâmico mais uma contagem separada, e essa forma esconde uma armadilha do Delphi. O compilador inicializa os campos gerenciados de um record local. O Integer comum sentado ao lado deles não recebe nada. No Win32, o slot da pilha muitas vezes por acaso segura zero, então o primeiro append pousa no índice 0 e todo teste passa; no Win64, o slot pode segurar sobras e o primeiro append escreve num índice arbitrário
type
  TPartList = record
    Values: TArray<Integer>;  // gerenciado: limpo pelo compilador
    Count: Integer;           // não gerenciado: o que quer que a pilha segurasse
  end;

procedure Append(var List: TPartList; Value: Integer);
begin
  if List.Count = Length(List.Values) then
    SetLength(List.Values, List.Count * 2 + 16);
  List.Values[List.Count] := Value;
  Inc(List.Count);
end;

procedure BuildParts;
var
  FirstPage, Shared: TPartList;
begin
  FirstPage := Default(TPartList);   // necessário, não cosmético
  Shared := Default(TPartList);
  Append(FirstPage, 12);
  Append(Shared, 40);
end;
O writer do HotPDF atribui Default a toda lista de partição antes de tocá-la. Uma execução verde no Win32 não diz nada sobre se um record desses foi inicializado
Por que o layout precisa convergir antes do primeiro byte ser escrito?
Porque a frente do arquivo guarda offsets que apontam para trás, e o número de dígitos desses offsets desloca tudo atrás deles. O trailer da primeira página carrega uma entrada /Prev com o offset em bytes da tabela de cross-reference principal. Escreva esse offset como 99998, depois descubra que a tabela realmente pousa em 100003, e o trailer cresce um dígito. A seção de cross-reference da primeira página cresce com ele, todo objeto atrás se move um byte, e a tabela principal agora está em 100004. Uma única passada acerta isso só por sorte
O HotPDF quebra o ciclo em dois movimentos. O dicionário de parâmetros vai para um slot fixo de 384 bytes preenchido com espaços, então /L, /H, /E e /T podem pegar os dígitos de que precisarem sem mover um único objeto; se o texto do dicionário um dia precisasse de mais de 384 bytes, a escrita levantaria exceção em vez de deslocar o arquivo. Isso deixa o /Prev como a única variável livre, e ele passa por um loop de ponto fixo. Todo objeto é primeiro serializado num stream de contagem que registra comprimentos e não guarda nenhum byte. Uma passada de layout então atribui offsets seção por seção e reporta onde a tabela principal pousaria, e essa resposta vira a entrada da passada seguinte. O loop para quando o offset proposto para de se mover e desiste com uma exceção depois de oito tentativas
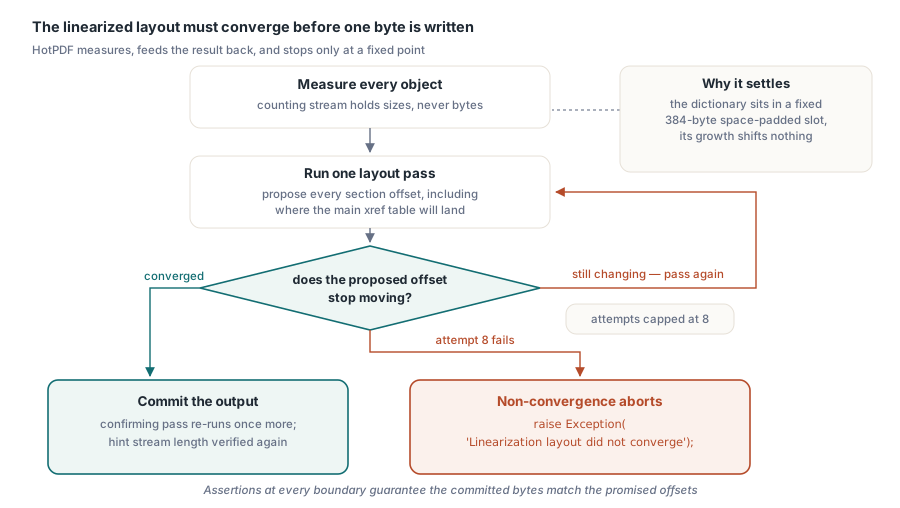
Só uma mudança na contagem de dígitos move algo, então uma terceira passada só é necessária perto de uma fronteira de potência de dez, como no caso do 99998. Depois da convergência, o writer roda uma passada de confirmação, reconstrói o hint stream com offsets reais e confere que o comprimento dele não mudou; os offsets ficam em campos de largura fixa, então a versão de espaço reservado e a final têm que bater. Então a saída vai direto para o stream de destino sem uma segunda cópia em buffer, e a cada fronteira de seção os bytes escritos são comparados com o offset prometido. Uma divergência levanta exceção a partir do EndDoc
Tabelas de hint, e onde o Anexo F se lê de duas maneiras
O hint stream primário carrega duas tabelas. A tabela de hints de offset de página registra, para cada página, quantos objetos a seção dela guarda, quanto tempo essa seção tem em bytes e de quais objetos compartilhados ela depende. A tabela de hints de objeto compartilhado lista o comprimento de cada grupo de objetos compartilhados. Com as duas, um leitor pode pedir a página 37 diretamente, e a entrada /S do stream dá a posição dentro do stream onde a tabela compartilhada começa
Dois detalhes no Anexo F F.4 são fáceis de errar. O primeiro é que os offsets guardados nas tabelas de hint são offsets lógicos, calculados como se o hint stream primário não existisse. O primeiro objeto de página e o primeiro objeto compartilhado ficam fisicamente depois do hint stream, então o writer subtrai o comprimento do objeto de hint antes de registrar os offsets deles. Um writer que registra offsets físicos em vez disso faz toda requisição de range resultante errar exatamente pelo tamanho do objeto de hint
O segundo é uma ambiguidade genuína. O texto do F.4 descreve cada tabela como um bit stream contínuo, bit mais significativo primeiro, e lista os grupos compartilhados da primeira página e os grupos compartilhados posteriores como duas sequências separadas. Hint streams em circulação preenchem toda coluna até uma fronteira de byte e tratam os grupos compartilhados como uma lista combinada, e essa é a forma que se sabe que leitores consumidores de hints aceitam. O HotPDF escreve o layout alinhado a byte e combinado. Esse é o lado certo a escolher: uma tabela que satisfaz a letra do F.4 mas desalinha para os clientes que a leem falha exatamente onde a linearização deveria compensar, e um download do arquivo inteiro nunca expõe o problema
Ligando a saída linearizada a partir do Delphi
Do lado da API, o interruptor é um Boolean. O LinearizeOutput tem padrão False, e o writer o consulta quando o EndDoc serializa o documento, então defina-o junto com as outras opções de saída antes do BeginDoc e deixe-o em paz. Toda falha descrita acima (não convergir, um dicionário de parâmetros grande demais, uma divergência de fronteira, o teto de 4 GiB coberto abaixo) aparece como uma exceção a partir do EndDoc, o que torna um fallback direto
procedure WriteReport(const FileName: string; Linearize: Boolean);
var
  PDF: THotPDF;
begin
  PDF := THotPDF.Create(nil);
  try
    PDF.FileName := FileName;
    PDF.Version := pdf17;
    PDF.LinearizeOutput := Linearize;   // defina antes do BeginDoc
    PDF.BeginDoc;                       // cria a página 1
    PDF.CurrentPage.TextOut(72, 72, 0, 'Quarterly summary');
    PDF.AddPage;
    PDF.CurrentPage.TextOut(72, 72, 0, 'Details');
    PDF.EndDoc;                         // o layout e a escrita acontecem aqui
  finally
    PDF.Free;
  end;
end;

procedure PublishReport(const FileName: string);
begin
  try
    WriteReport(FileName, True);
  except
    on E: Exception do
    begin
      LogWarning('Linearization failed: ' + E.Message);  // logger seu
      WriteReport(FileName, False);                       // PDF simples em vez disso
    end;
  end;
end;
O fallback produz um PDF comum que qualquer visualizador abre; ele só perde a primeira página rápida. Para um pipeline de relatórios, esse trade é fácil, já que uma primeira pintura lenta é um incômodo e um relatório ausente é um incidente
O lado de implantação supera o código. A linearização só compensa quando o servidor honra requisições HTTP Range; um endpoint que envia o arquivo inteiro compra para você uma escrita mais lenta e um arquivo maior de graça. Deixe o LinearizeOutput desligado para arquivos que são anexados por e-mail ou baixados antes de qualquer um visualizá-los. Ligue-o para documentos que um navegador abre direto de uma URL, depois de confirmar que a resposta carrega Accept-Ranges: bytes
Por que o LinearizeOutput desliga object streams?
Porque toda entrada de tabela de hint descreve uma faixa de bytes, e um objeto empacotado num contêiner /ObjStm não tem faixa de bytes própria; ele existe apenas como uma fatia de outro stream comprimido que precisa ser buscado e inflado por inteiro. Com o LinearizeOutput ligado, o HotPDF escreve tabelas de cross-reference de texto tradicionais e objetos indiretos desempacotados mesmo quando UseXRefStream ou UseObjectStreams também está definido. O caminho linearizado tem precedência na hora de salvar, então o seu código não tem conflito para resolver
O custo é tamanho de arquivo, já que os dicionários pequenos que um object stream comprimiria juntos agora ficam soltos. Se saída compacta importa mais que latência da primeira página, o trade-off está detalhado em object streams e atualizações incrementais no HotPDF. Exportadores de Office esbarram na mesma tensão pelo outro lado, e é por isso que alguns deles emitem o layout descrito em hybrid cross-reference streams em PDFs gerados por Office
A linearização também precisa de PDF 1.2 ou posterior. Com um Version mais baixo, o HotPDF promove o documento para 1.2 ao salvar. Com StrictVersionLock definido, ele levanta exceção em vez disso, porque uma versão que você fixou de propósito não deveria mudar pelas suas costas
O teto de 4 GiB na saída linearizada
Tabelas de hint guardam offsets e comprimentos em campos de 32 bits, então um arquivo linearizado não consegue endereçar nada além de 4 GiB, e o HotPDF se recusa a produzir um em vez de escrever offsets que dão a volta. O teto vem das larguras de campo que o Anexo F define
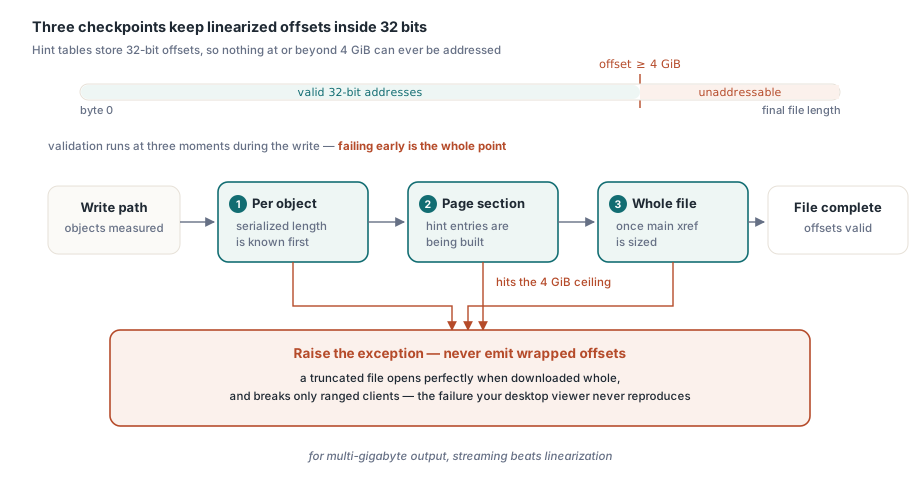
A checagem roda em três pontos, todos antes do primeiro byte alcançar o destino: em cada objeto assim que o comprimento serializado dele fica conhecido, em cada comprimento de seção de página enquanto as entradas de hint são construídas, e no comprimento final do arquivo assim que a tabela de cross-reference principal é dimensionada. Offsets que dão a volta seriam a pior forma de falhar: um visualizador que baixa o arquivo inteiro pode ignorar os hints, enquanto o cliente de byte-range salta para os bytes errados, então testes em desktop nunca reproduzem a falha. Para saída de múltiplos gigabytes, o caminho de streaming na Direct File API para workflows de PDF grandes é o lugar para olhar
Checando se um arquivo de entrada é linearizado
O THotPDF.IsLoadedLinearized reporta se o documento carregado se declara linearizado. A checagem acontece antes do parsing: o HotPDF lê até 1024 bytes a partir da posição zero da origem, acha o primeiro objeto e olha dentro desse objeto por /Linearized com o valor 1. Comentários, strings literais e strings hex são pulados, então o nome aparecendo dentro de uma string não conta, e a varredura para em stream ou endobj. Só 1 ou um equivalente como 1.0 é aceito
A resposta é cacheada na carga porque, quando o código do aplicativo pergunta, o parser já moveu a posição do stream e o LoadFromFile já soltou o stream de origem dele
A flag reporta o que o arquivo alega. O Anexo F adiciona uma segunda condição: o /L tem que bater com o comprimento real do arquivo, e uma atualização incremental anexada depois da linearização quebra essa batida, então leitores voltam a tratar o arquivo como comum. Um pipeline que aceita arquivos de editores que anexam os saves deles pode comparar os dois números por conta própria
// Auxiliar seu, não faz parte do HotPDF: compara /L com o tamanho real
// Parse simplificado; assume um único espaço depois de /L
function DeclaredLengthMatches(const FileName: string): Boolean;
var
  FS: TFileStream;
  Head: AnsiString;
  ActualSize: Int64;
  P, Q: Integer;
begin
  FS := TFileStream.Create(FileName, fmOpenRead or fmShareDenyWrite);
  try
    ActualSize := FS.Size;
    SetLength(Head, 1024);
    SetLength(Head, FS.Read(Head[1], 1024));
  finally
    FS.Free;
  end;
  P := Pos(AnsiString('/L '), Head);
  Result := P > 0;
  if not Result then
    Exit;
  Inc(P, 3);
  Q := P;
  while (Q <= Length(Head)) and (Head[Q] in ['0'..'9']) do
    Inc(Q);
  Result := StrToInt64Def(string(Copy(Head, P, Q - P)), -1) = ActualSize;
end;

procedure InspectUpload(const FileName: string);
var
  PDF: THotPDF;
begin
  PDF := THotPDF.Create(nil);
  try
    if PDF.LoadFromFile(FileName) <= 0 then
      Exit;
    if not PDF.IsLoadedLinearized then
      Writeln('Not linearized')
    else if not DeclaredLengthMatches(FileName) then
      Writeln('Linearized, but modified after linearization')
    else
      Writeln('Ready for Fast Web View');
  finally
    PDF.Free;
  end;
end;
O LinearizeOutput e o IsLoadedLinearized fazem parte do HotPDF Delphi Component para Delphi e C++Builder, e a página do produto documenta como eles interagem com cross-reference streams, object streams e version locking