A PDF Library for Delphi escreve intervalos de page labels com o AddPageLabels, e desde a v3.539.10 essa chamada também funciona em arquivos carregados cuja number tree do /PageLabels está dividida em nós /Kids: a raiz é achatada numa folha única de /Nums antes do intervalo novo entrar, para o rótulo realmente aparecer no viewer em vez de ser silenciosamente ignorado. A vítima típica é um PDF estilo livro vindo de uma ferramenta de layout, com numerais romanos na parte pré-textual, numeração arábica no corpo e um apêndice rotulado A-1, A-2, em que você só queria rotular de novo o apêndice e nada mudou
O que são page labels de PDF e como eles são armazenados?
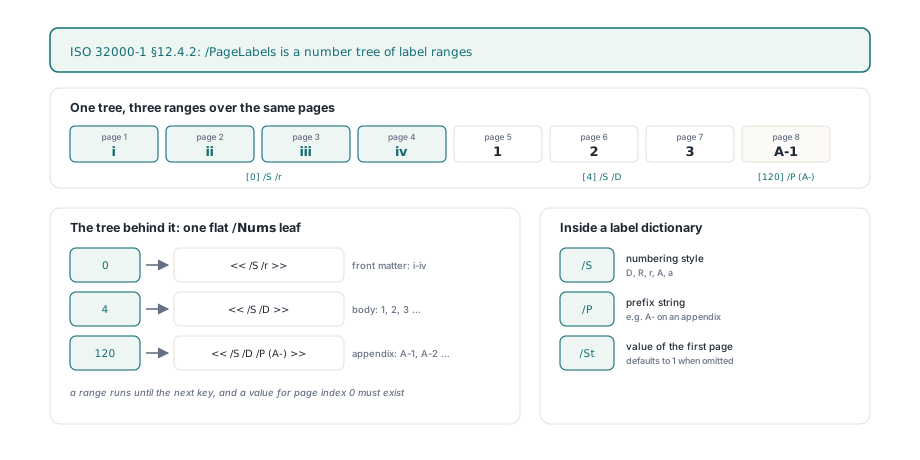
Page labels são as strings que um viewer mostra na caixa de página dele em vez do índice físico de página, e a ISO 32000-1 §12.4.2 os armazena como uma number tree sob a chave de catálogo /PageLabels. Cada chave é um índice de página 0-based que inicia um intervalo de rotulação, e cada valor é um dicionário de page label com até três entradas: /S para o estilo de numeração (D, R, r, A ou a), /P para uma string de prefixo, e /St para o valor numérico da primeira página do intervalo, que tem default 1. Um intervalo vai até a próxima chave, e a especificação exige que a árvore contenha um valor para o índice de página 0, então toda página fica coberta por algum intervalo
var
  Lib: TPDFlib;
begin
  Lib := TPDFlib.Create;
  try
    if Lib.LoadFromFile('handbook.pdf', '') <> 1 then
      Exit;
    // Páginas 1-4: i, ii, iii, iv (romano minúsculo)
    Lib.AddPageLabels(1, 3, 1, '');
    // Páginas 5-120: 1, 2, 3 ... (decimal)
    Lib.AddPageLabels(5, 1, 1, '');
    // Páginas 121 em diante: A-1, A-2 ... (decimal com prefixo)
    Lib.AddPageLabels(121, 1, 1, 'A-');
    WriteLn(Lib.GetPageLabel(5));    // 1
    WriteLn(Lib.GetPageLabel(122));  // A-2
    Lib.SaveToFile('handbook-labeled.pdf');
  finally
    Lib.Free;
  end;
end;
O TPDFlib.AddPageLabels(Start, Style, Offset, Prefix) mapeia os argumentos dele nesse dicionário sem surpresas depois que você conhece três regras. Start é 1-based como todo argumento de página na biblioteca e é escrito na árvore como Start - 1. Style vai de 0 a 5, em que 0 significa só prefixo e 1 a 5 viram valores /S D, R, r, A e a; qualquer coisa fora desse intervalo retorna 0 e não toca em nada. Offset vira /St só quando é maior que zero, então passar 0 simplesmente omite a chave e o viewer cai no default de 1. Como page labels chegaram no PDF 1.3, a chamada também roda EnsureMinVersion('1.3', '/PageLabels'), que sobe a versão de output de um arquivo mais velho a menos que você tenha travado explicitamente a versão de save
Por que novos page labels desaparecem quando a árvore tem /Kids?
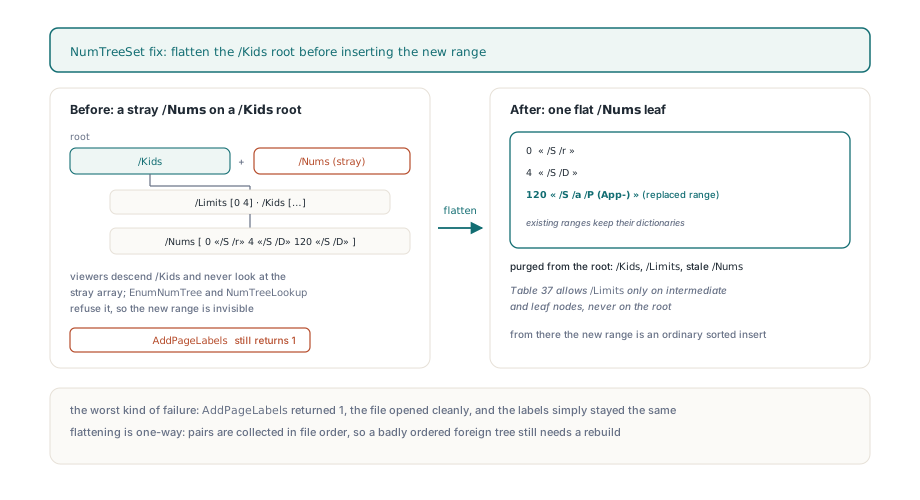
Os rótulos novos desaparecem porque a ISO 32000-1 §7.9.7 (Tabela 37) faz a raiz de uma number tree carregar /Kids ou /Nums, nunca os dois, e o helper NumTreeSet antigo só sabia procurar /Nums. Produtores que emitem documentos longos costumam dividir a árvore em nós intermediários, cada um com um par /Limits, e pendurá-los numa raiz que só tem /Kids. O código antigo não encontrava /Nums nessa raiz, criava um novo ao lado do /Kids existente e inseria o intervalo novo ali. O resultado era uma raiz com dois pontos de entrada mutuamente exclusivos. Os viewers descem pelo /Kids e nunca olham o array solto, o EnumNumTree da própria biblioteca também confere /Kids primeiro, e o NumTreeLookup recusa um nó em que HasKids xor HasNums é falso. O AddPageLabels ainda retornava 1 e o arquivo salvo ainda abria limpo, que é o pior tipo de falha: nada reclama, os rótulos simplesmente continuam os mesmos
A correção no NumTreeSet converte a raiz numa folha antes de inserir qualquer coisa. Quando a raiz carrega /Kids, o EnumNumTree percorre toda folha em ordem e coleta cada par de chave e valor, um array /Nums plano novo é construído a partir dessa lista, e /Kids, /Limits e qualquer /Nums obsoleto são purgados da raiz antes de o array plano ser anexado. Largar o /Limits não é cosmética, já que a Tabela 37 permite essa entrada só em nós intermediários e folhas, nunca na raiz. A partir daí a inserção é um sorted insert comum num único array, e os intervalos existentes sobrevivem com os dicionários de label originais deles. O trade-off é deliberado: a árvore não é reconstruída em nós /Kids balanceados depois. Para page labels isso não custa nada, porque até um manual de referência grande raramente tem mais que umas poucas dezenas de intervalos, e uma folha única é o que a maioria dos produtores escreve de qualquer forma
// Relabela o apêndice num arquivo cuja raiz /PageLabels usa /Kids
if Lib.LoadFromFile('vendor-manual.pdf', '') = 1 then
begin
  WriteLn('Before: ', Lib.GetPageLabel(121));  // ex.: A-1
  // Substitui o intervalo que começa na página 121: App-a, App-b ...
  if Lib.AddPageLabels(121, 5, 1, 'App-') = 1 then
    Lib.SaveToFile('vendor-manual-relabeled.pdf');
  // Os intervalos romano e decimal existentes continuam na folha achatada
  WriteLn('After: ', Lib.GetPageLabel(121));   // App-a
  WriteLn('Front: ', Lib.GetPageLabel(2));     // ii, sem mudança
end;
Como um array /Nums pode ser lido errado como chaves?
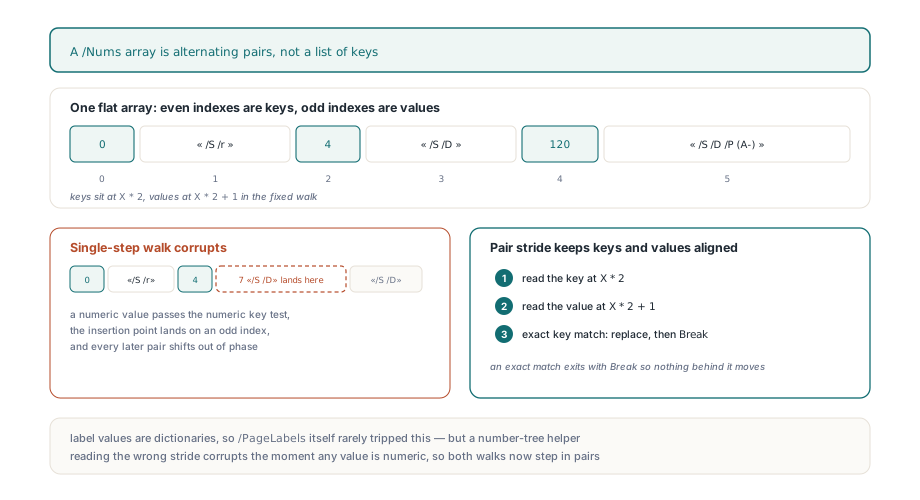
Um array /Nums é lido errado quando o código o percorre um elemento por vez, porque o array é uma sequência plana de pares alternados, [key0 value0 key1 value1 ...], e só as posições pares são chaves. O loop do NumTreeSet antigo testava cada elemento quanto a tipo numérico, então um valor que por acaso era um número era comparado como se fosse chave; um acerto de comparação menor podia pôr o ponto de inserção num índice ímpar e derrubar o par novo no meio de um existente, desfasando todo par posterior. O EnumNumTree tinha o mesmo passo único. Ambos agora iteram pares com stride de dois, lendo a chave em X * 2 e o valor em X * 2 + 1, e um match exato de chave substitui o valor e sai com Break. Para ser justo, os valores de page label são dicionários, então esse segundo bug raramente disparava no /PageLabels em si, mas um helper de number tree que lê o stride errado corrompe no momento em que qualquer valor é numérico, e foi corrigido na mesma passada
Lendo os rótulos de volta e fazendo round trip deles
O TPDFlib.GetPageLabel(Page) retorna o rótulo de uma página 1-based e tem dois fallbacks que valem conhecer. Sem entrada /PageLabels nenhuma, ele retorna o número decimal da página, então quem chama pode usá-lo incondicionalmente. Com a árvore presente mas nenhum intervalo cobrindo a página, ele retorna uma string vazia, que é exatamente o que acontece quando um arquivo pula a entrada obrigatória do índice 0; a documentação de referência diz que um intervalo começando na página 1 precisa existir para os rótulos exibirem corretamente, e o código torna esse requisito visível. Estilos de letra seguem a especificação, não colunas de planilha: depois do Z vem AA, depois BB, repetindo a letra em vez de carregar
var
  P: Integer;
  Data: WideString;
begin
  // Auditoria rápida do que um viewer vai mostrar na caixa de página dele
  for P := 1 to Lib.PageCount do
    WriteLn(P, ' -> ', Lib.GetPageLabel(P));

  // O valor de opção 4 exporta só intervalos de label como registros PageLabelBegin
  Data := Lib.ExportDocumentData(4);
  // O import os reproduz via ClearPageLabels + AddPageLabels
  Lib.ImportDocumentData(Data, 0);
end;
Para edições em massa, o ExportDocumentData com valor de opção 4 escreve todo intervalo como um bloco PageLabelBegin com linhas PageLabelNewIndex, PageLabelStart, PageLabelPrefix e PageLabelNumStyle, e o ImportDocumentData trata o primeiro registro de label que vê como uma substituição completa: ele chama ClearPageLabels uma vez e depois alimenta cada registro ao AddPageLabels. Isso torna o round trip em texto determinístico mesmo quando o arquivo original usava uma árvore /Kids, porque limpar remove a entrada de catálogo inteira e a árvore reconstruída é uma folha única desde o início
O que a correção ainda não garante?
O achatamento é de mão única e confia na ordem que encontra. O EnumNumTree coleta os pares na ordem do arquivo, e o GetPageLabel aplica o último intervalo cuja chave é menor ou igual ao índice de página, então um arquivo de terceiros cujas folhas estão fora de ordem, o que a §7.9.7 proíbe mas que circula mesmo assim, ainda pode produzir rótulos errados até você reconstruir os intervalos com ClearPageLabels e chamadas novas de AddPageLabels. Os rótulos também estão amarrados a índices de página, não a objetos de página, então qualquer operação que mude a contagem ou a ordem de páginas deixa os intervalos onde estavam. Uma troca in-place como substituir páginas preservando números de objeto mantém a contagem e portanto os rótulos alinhados, enquanto um merge como intercalar scans duplex embaralhados produz uma sequência de páginas nova que merece um conjunto de intervalos escrito do zero
As chamadas de page label, o tratamento de number tree e o export e import de dados de documento descritos aqui entram na PDF Library for Delphi para Delphi, C++Builder e Lazarus, com a entrada de referência do AddPageLabels documentando os valores de estilo e os códigos de retorno