O PDFlibPas, a PDF Library da losLab para Delphi, caminha por name trees e number trees de PDF com uma pilha explícita e um visited set desde a v3.539.45, então /Kids cíclicos, filhos compartilhados e árvores de milhares de níveis de profundidade não esgotam mais a call stack nem duplicam entradas. Desde a v3.539.51 um par /Limits ausente, malformado ou invertido nunca mais esconde um ramo que contém a chave. Named destinations, page labels, attachments e JavaScript de nível de documento todos leem através desses dois caminhos de código, o que os torna parte da attack surface de qualquer PDF que você mesmo não produziu
O gatilho raramente é exótico. Um fuzzer, um upload hostil ou um incremental save com bug escreve uma entrada /Kids que aponta de volta para um ancestral, e um walker recursivo morre com stack overflow num arquivo de dois kilobytes. A falha mais silenciosa é um lookup que confia num array /Limits quebrado e reporta "not found" para uma destination que está claramente lá
Onde name trees e number trees aparecem num PDF?
Name trees e number trees aparecem onde quer que um PDF mapeie um grande conjunto de chaves para objetos, e o PDFlibPas lê pelo menos quatro deles por APIs públicas. A ISO 32000-1 §7.9.6 define a name tree (chaves string, Table 36) e a §7.9.7 a number tree (chaves inteiras, Table 37). Ambas são árvores mais ou menos balanceadas cujos nodes raiz e intermediários carregam /Kids, cujas folhas carregam os pares chave/valor ordenados em /Names ou /Nums, e cujos nodes não raiz carregam um array /Limits de dois elementos com a menor e a maior chave abaixo deles
| Tree | Onde mora | Especificação | API de leitura do PDFlibPas |
|---|---|---|---|
| Named destinations | /Dests no name dictionary | §12.3.2.3 | GetNamedDestination, depois GetDestPage / GetDestType |
| Page labels | /PageLabels no catálogo (number tree) | §12.4.2 | GetPageLabel |
| Attachments | /EmbeddedFiles no name dictionary | §7.7.4, §7.11.4 | EmbeddedFileCount, GetEmbeddedFileStrProperty |
| JavaScript de nível de documento | /JavaScript no name dictionary | §7.7.4 | GlobalJavaScriptCount, GlobalJavaScriptPackageName |
Dois detalhes dessa tabela são fáceis de perder. Named destinations também têm uma forma mais antiga do PDF 1.1, um dicionário /Dests simples no catálogo chaveado por name objects, e o GetNamedDestination confere esse dicionário primeiro antes de descer a name tree do PDF 1.2. E o GetDocJavaScript não é um leitor de name tree de forma alguma: ele retorna os scripts anexados aos triggers de documento no dicionário /AA do catálogo (WS, DS, WP, DP, DC), enquanto os pacotes de scripts nomeados que rodam quando um documento abre moram na name tree /JavaScript
Cada byte dessas estruturas vem do arquivo. A especificação diz o que um writer deve produzir; ela não pode impedir um reader de receber outra coisa, que é a mesma lição por trás de endurecer um parser de PDF Pascal contra arquivos maliciosos, aplicada aqui à forma da árvore em vez de tamanhos de buffer
Por que um array /Kids cíclico derruba um walker de árvore recursivo?
Um array /Kids cíclico derruba um walker recursivo porque nada na recursão nota que já viu um node antes, então um filho que referencia o próprio ancestral dele transforma um arquivo finito numa descida infinita. Antes da v3.539.45, NameTreeLookup, NumTreeLookup, EnumNumTree e o TPDFNameTree.ProcessNode interno todos se chamavam uma vez por filho. Uma única autorreferência bastava para acabar com o processo, e uma árvore legítima mas muito funda podia fazer o mesmo sem ciclo nenhum
Uma variante mais branda corrompe resultados em vez de travar. Quando duas entradas /Kids referenciam a mesma folha, uma enumeração ingênua a visita duas vezes, e uma contagem de attachments ou uma lista de pacotes de scripts reporta entradas que não existem
A correção troca a recursão por uma pilha explícita last-in, first-out no heap e um visited set chaveado pela identidade do dicionário. Um node é marcado quando é desempilhado, não quando é empilhado, então uma referência cíclica pode ficar na pilha brevemente, mas é descartada no instante em que volta para cima. Cada node distinto expande os filhos dele exatamente uma vez, o que limita o trabalho total pelo número de dicionários distintos mais o comprimento total dos arrays /Kids deles. Profundidade para de importar: uma cadeia de 4.096 níveis é só 4.096 iterações de um loop e 4.096 entradas num hash set
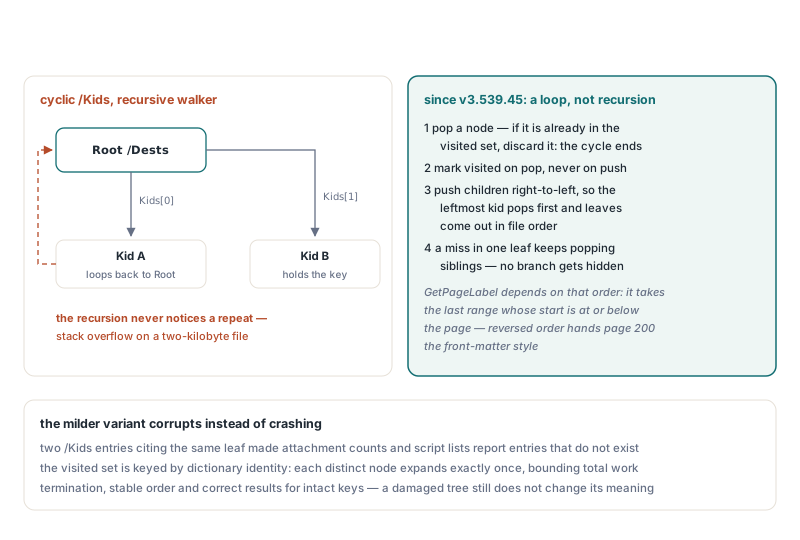
A ordem ainda importa, porém, e a pilha precisa ser alimentada de trás para frente para mantê-la. Os filhos são empurrados do último índice até o primeiro, então o filho mais à esquerda sai primeiro e as folhas aparecem na mesma ordem da esquerda para a direita em que o produtor as escreveu. O GetPageLabel depende disso: ele caminha por toda range enumerada e aplica a última cujo índice de início está em ou abaixo da página, então inverter a enumeração entregaria silenciosamente à página 200 o estilo de folha de rosto. O esqueleto abaixo mostra o padrão sobre um tipo de node abstrato, independente de qualquer modelo de objetos de PDF
uses
  System.Generics.Collections;

type
  TTreeNode = class
  public
    Kids: TArray<TTreeNode>;   // vazio numa folha
    Keys: TArray<string>;      // chaves de folha, ordenadas por um produtor bem comportado
    Values: TArray<Integer>;   // paralelo a Keys
    HasLimits: Boolean;
    LoKey, HiKey: string;
  end;

// /Limits é uma dica: só um par bem formado e ordenado pode podar um ramo
function LimitsExclude(Node: TTreeNode; const Key: string): Boolean;
begin
  Result := Node.HasLimits and (Node.LoKey <= Node.HiKey) and
    ((Key < Node.LoKey) or (Key > Node.HiKey));
end;

function FindValue(Root: TTreeNode; const Key: string;
  out Value: Integer): Boolean;
var
  Pending: TList<TTreeNode>;
  Visited: TDictionary<TTreeNode, Byte>;
  Node: TTreeNode;
  I: Integer;
begin
  Result := False;
  Value := 0;
  if Root = nil then
    Exit;
  Pending := TList<TTreeNode>.Create;
  Visited := TDictionary<TTreeNode, Byte>.Create;
  try
    Pending.Add(Root);
    while Pending.Count > 0 do
    begin
      Node := Pending[Pending.Count - 1];
      Pending.Delete(Pending.Count - 1);
      if Visited.ContainsKey(Node) then
        Continue;                      // ciclo ou filho compartilhado: já visto
      Visited.Add(Node, 0);
      if Length(Node.Kids) > 0 then
      begin
        // Empurre da direita para a esquerda para o kid mais à esquerda sair primeiro
        for I := High(Node.Kids) downto 0 do
          if (Node.Kids[I] <> nil) and not LimitsExclude(Node.Kids[I], Key) then
            Pending.Add(Node.Kids[I]);
      end
      else
        for I := 0 to High(Node.Keys) do
          if (Node.Keys[I] = Key) and (I <= High(Node.Values)) then
          begin
            Value := Node.Values[I];
            Exit(True);
          end;
      // Um miss nesta folha não é veredito: continue desempilhando irmãos
    end;
  finally
    Visited.Free;
    Pending.Free;
  end;
end;
Por que um lookup não pode parar no primeiro ramo que casa?
Um lookup não pode parar no primeiro ramo cuja range casa, porque ranges de /Limits num arquivo real podem se sobrepor ou mentir, e o ramo que reivindica a chave não é necessariamente o ramo que a segura. Os lookups pré-v3.539.45 setavam uma flag Found no primeiro filho cujo /Limits cobria a chave, desciam nele, e nunca olhavam outro irmão. Se esse filho se revelasse vazio, obsoleto ou um loop de volta à raiz, a resposta era nil, mesmo quando o irmão seguinte segurava a chave
O FindTreeValue reescrito, que agora sustenta tanto o NameTreeLookup quanto o NumTreeLookup, empurra todo filho cuja range não exclui a chave e continua desempilhando até achar um match ou esvaziar a pilha. Um miss dentro de uma folha é só um miss dentro de uma folha. Numa árvore bem formada isso não custa nada extra; numa danificada custa algumas visitas de node a mais e devolve a resposta certa
A busca na folha segue a mesma filosofia. A ISO 32000-1 exige que as chaves num array /Names estejam ordenadas por valor de byte, então a folha primeiro é buscada com binary search. Se isso falha, o PDFlibPas cai para um scan linear dos pares, porque uma folha fora de ordem tornaria uma chave presente invisível. Ordenação é fast path, não filtro
O lookup também se recusa a adivinhar numa contradição estrutural. A Table 36 permite que um node carregue /Kids ou /Names, nunca ambos, e o caminho de lookup trata um node que carrega ambos como malformado e o pula em vez de escolher uma interpretação. Caminhos de enumeração como o EnumNumTree são mais tolerantes e seguem /Kids quando ambos estão presentes
No que um reader pode confiar quanto ao /Limits?
Um reader pode confiar no /Limits só para pular trabalho, nunca para decidir que uma chave está ausente, e só quando o par é bem formado. A Table 36 diz que nodes intermediários e folhas devem carregar /Limits como um array de dois elementos com a menor e a maior chave, mas na prática a entrada some depois de edições manuais, contém números numa name tree, ou chega com os bounds invertidos. O PDFlibPas v3.539.45 e v3.539.51 resolvem cada caso do mesmo jeito: se a range não pode ser lida como um par ordenado do tipo certo, o filho continua pesquisável
/Limitsausente: a checagem de range antiga retornava False e o filho era pulado por inteiro, então um produtor que esqueceu a entrada deixava a subárvore dele inteira inalcançável. Desde a v3.539.45 o filho é pesquisado- Tipo errado ou comprimento errado, como números numa name tree ou um array de um elemento: tratado exatamente como uma entrada ausente desde a v3.539.45
- Bounds invertidos como
[(Z) (A)]ou[9 0]: a v3.539.45 ainda os usava, e nenhuma chave pode satisfazerLo <= Key <= HiquandoLo > Hi, então o ramo era excluído para todo lookup. Desde a v3.539.51 uma range é usada para poda só quando o bound inferior dela não excede o superior - Bem formado, ordenado e correto: usado para pular o ramo, que é todo o propósito da entrada
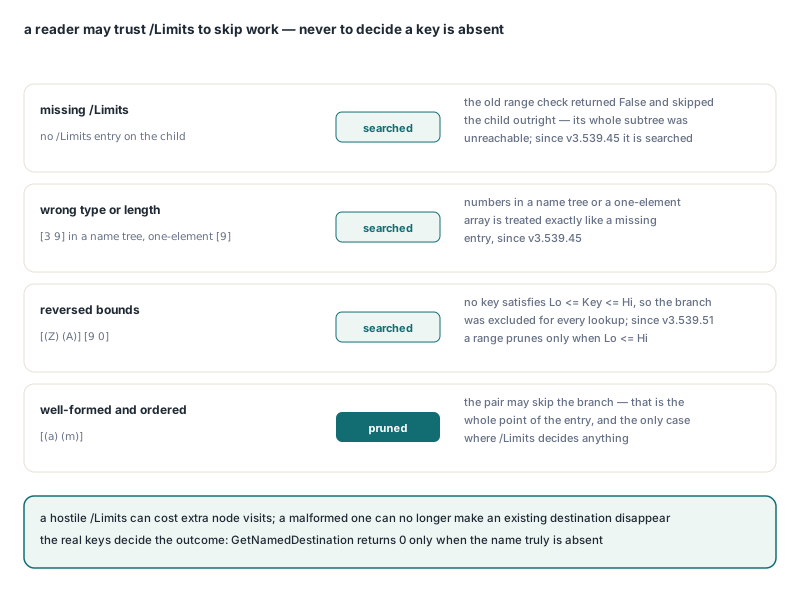
As chaves reais decidem o resultado em todo caso. Um /Limits hostil pode fazer o PDFlibPas visitar mais nodes do que o necessário, mas um malformado não pode mais fazer uma destination existente sumir. Do lado de quem chama nada muda: o GetNamedDestination retorna 0 quando o nome realmente está ausente e um destination ID caso contrário, e as funções de destination seguem a partir daí
uses
  PDFlibrary;

procedure LookUpDestination(const FileName, DestName: string);
var
  Lib: TPDFlib;
  DestID: Integer;
begin
  Lib := TPDFlib.Create;
  try
    if Lib.LoadFromFile(FileName, '') <> 1 then
    begin
      WriteLn('Load failed, error ', Lib.LastErrorCode);
      Exit;
    end;
    // /Dests do catálogo (PDF 1.1) primeiro, depois a name tree /Dests
    DestID := Lib.GetNamedDestination(DestName);
    if DestID = 0 then
      WriteLn('No destination named ', DestName)
    else if Lib.GetDestPage(DestID) = 0 then
      WriteLn(DestName, ' exists but does not resolve to a page')
    else
      WriteLn(DestName, ' -> page ', Lib.GetDestPage(DestID),
        ', view type ', Lib.GetDestType(DestID));  // 1 = XYZ, 2 = Fit ...
  finally
    Lib.Free;
  end;
end;
Rodado contra um arquivo escrito à mão cuja raiz /Dests tem um filho que volta à raiz sob uma range [(a) (z)] e um segundo filho segurando a entrada real sob limits invertidos [(z) (a)], este procedure resolve a destination para a página 2 com view type 2 (Fit). Antes da v3.539.45 o mesmo lookup retornava 0, porque o filho em loop reivindicava a chave primeiro e a busca nunca chegava ao irmão dele; a v3.539.45 sozinha ainda retornava 0, porque a range invertida excluía a folha real. Se você então lê o outline que aponta para essas destinations, o artigo companheiro sobre ler actions de bookmark e annotation de PDF em Delphi cobre o lado das actions
Como uma folha com 32.769 nomes quebrou o TPDFNameTree?
Uma folha com 32.769 pares nome/valor quebrou o TPDFNameTree porque o FindIndex interno dele empacotava dois números num único Integer de 32 bits: a posição da folha na array list interna nos 16 bits altos e o offset da entrada dentro do array /Names dessa folha nos 16 bits baixos. Cada par ocupa duas posições de array, então o par número 32.769, índice de par 32.768, começa no offset 65.536, que é $10000. Esse valor vaza para a metade alta, e o decodificador o lia de volta como offset 0 na folha seguinte
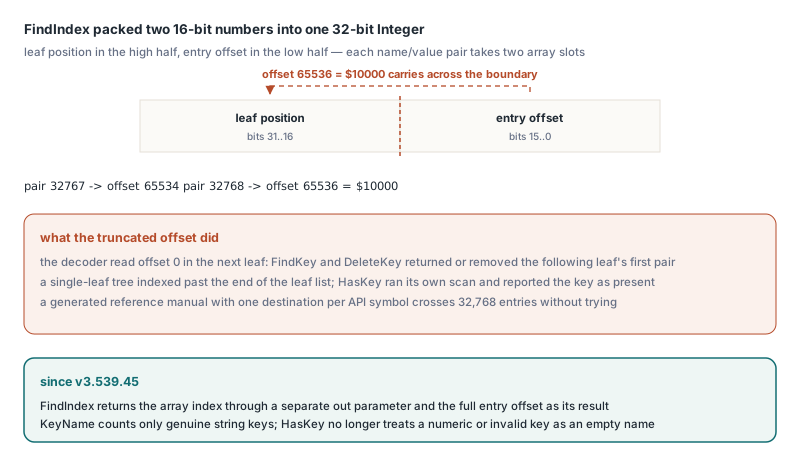
O TPDFNameTree é a classe por trás de attachments, pacotes globais de JavaScript e escritas de named destination, o que torna as consequências concretas. Numa árvore de folha única não há folha seguinte, então FindKey e DeleteKey indexavam além do fim da lista de folhas; numa árvore de múltiplas folhas eles retornavam ou deletavam o primeiro par da folha seguinte em vez do pedido. Enquanto isso o HasKey rodava o próprio scan dele e reportava a chave como presente, então a classe se contradizia. Um manual de referência gerado com uma named destination por símbolo de API cruza 32.768 entradas sem esforço, e alguns produtores escrevem todas elas numa única folha plana
Desde a v3.539.45, o FindIndex retorna o índice de array através de um parâmetro out separado e o offset completo da entrada como resultado, então nenhum dos dois valores é truncado. A mesma release apertou dois vizinhos. O KeyName agora conta e retorna só chaves string genuínas e retorna uma string vazia para um índice de 0 ou abaixo, onde antes ele fazia cast de qualquer objeto que seguisse uma chave inválida. O HasKey não trata mais uma chave numérica ou inválida como nome vazio. Para uma folha como [(Valid) 42 123 456], HasKey('') agora é False e KeyName(2) retorna uma string vazia
procedure AuditTrees(const FileName: string);
var
  Lib: TPDFlib;
  I: Integer;
begin
  Lib := TPDFlib.Create;
  try
    if Lib.LoadFromFile(FileName, '') <> 1 then
      Exit;
    // number tree /PageLabels; arquivos sem uma retornam números de página simples
    for I := 1 to Lib.PageCount do
      WriteLn('Page ', I, ' label: ', Lib.GetPageLabel(I));
    // name tree /EmbeddedFiles; índices são 1-based, chaves não string puladas
    for I := 1 to Lib.EmbeddedFileCount do
      WriteLn('Attachment ', I, ': ', Lib.GetEmbeddedFileStrProperty(I, 1),
        ' (', Lib.GetEmbeddedFileStrProperty(I, 2), ')');  // nome, tipo MIME
    // name tree /JavaScript: liste nomes de pacotes, não execute nada
    for I := 1 to Lib.GlobalJavaScriptCount do
      WriteLn('Script package: ', Lib.GlobalJavaScriptPackageName(I));
  finally
    Lib.Free;
  end;
end;
No mesmo arquivo escrito à mão, cuja raiz /PageLabels lista uma folha duas vezes e referencia a si mesma, esta auditoria imprime i e A-1 para as duas páginas, cada range uma vez, e o único pacote de scripts de uma tree /JavaScript que também aponta de volta para a própria raiz dela. O lado de escrita de page labels tem história própria com raízes /Kids, coberto em consertar page labels de PDF guardadas em number trees /Kids; o AddPageLabels achata tal raiz antes de inserir, e ele depende da mesma enumeração EnumNumTree descrita aqui
O que este hardening ainda não garante?
O hardening garante terminação, ordem estável e resultados corretos para árvores cujas chaves reais estão intactas; ele não faz uma árvore danificada significar o que o autor dela pretendia. Vários limites valem conhecer antes de construir sobre isso
- O visited set funciona por identidade de objeto. Dois dicionários distintos com conteúdo idêntico são dois nodes, então um produtor que copia uma folha em vez de referenciá-la ainda produz entradas duplicadas
- Um
/Limitsbem formado, ordenado, mas errado, ainda poda. Um reader que usa ranges como otimização não pode também ser imune a uma range que mente de forma plausível; a única alternativa é ignorar/Limitsinteiramente e escanear cada folha - A enumeração preserva a ordem do arquivo mas não ordena. O
GetPageLabelaplica a última range enumerada em ou abaixo da página, então um produtor que escreve ranges fora de ordem recebe semântica de ordem de arquivo - A memória cresce com o número de nodes e entradas distintos. A travessia acrescenta uma lista e um hash set, nada mais, mas uma name tree de 100 MB continua sendo uma name tree de 100 MB depois do parse
- Chaves duplicadas dentro de uma folha não são reportadas. A binary search retorna o par que ela acerta primeiro; o fallback linear mantém o último match que escaneia
Referência rápida: ler árvores de PDF de arquivos não confiáveis
- Faça upgrade para a v3.539.45 ou posterior para travessia safe contra ciclos e contra stack de name trees e number trees, e para a v3.539.51 ou posterior para que
/Limitsinvertidos não escondam mais chaves - Trate o
GetNamedDestinationretornando 0 como "ausente", e oGetDestPageretornando 0 como "presente mas inutilizável" - Use
GlobalJavaScriptCounteGlobalJavaScriptPackageNamepara a name tree/JavaScript; oGetDocJavaScriptlê triggers/AAdo catálogo em vez disso - Indexe attachments e pacotes de scripts de 1 até a contagem que a biblioteca reporta; chaves inválidas não são contadas
- No seu próprio código de árvore, marque nodes visitados no pop, empurre filhos em ordem reversa, e deixe
/Limitspodar só quando for um par bem tipado e ordenado
Tools de pre-flight, archivers e viewers leem essas árvores antes de qualquer página ser renderizada, então eles precisam sobreviver ao que quer que chegue numa fila de uploads. Os readers de árvore descritos acima saem com o PDFlibPas, a PDF Library para Delphi, que compila tanto com Delphi quanto com Free Pascal