Aqui vai um erro que um leitor JBIG2 escrito à mão comete no primeiro arquivo incomum que encontra. Ele analisa o file header, analisa o primeiro segment header, lê o comprimento de dados de quatro bytes e toma aquele número de bytes como corpo do segmento. Na maioria dos arquivos .jb2 isso é exatamente certo. Num arquivo cujo byte de flags tem o bit 0 zerado, esses bytes de "corpo" são na verdade o segundo, o terceiro e o quarto segment headers, e o decodificador aritmético os transforma num bitmap de ruído ou sai correndo do fim do buffer. O arquivo não está quebrado. Ele usa a organização random-access do ITU-T T.88 Anexo D.2, em que todo segment header vem primeiro e todos os dados de segmento vêm depois, na mesma ordem
Arquivos random-access são raros. Eles saem de sistemas de arquivamento e imageamento de documentos que querem que um leitor veja toda página e dependência de dicionário antes de tocar num byte comprimido. Se um job de conversão mistura arquivos de tal origem com digitalizações comuns, um arquivo random-access pode sentar no meio de um lote que de resto é todo sequential. O decodificador que os lê é o mesmo decodificador Pascal nativo que cuida de tabelas Huffman customizadas JBIG2 e códigos de prefixo canônicos, então o lado de codificação não muda; só a ordem em que os segmentos são encontrados difere
Três layouts de arquivo atrás de um byte de flags
O PDF Library for Delphi lê arquivos JBIG2 independentes por meio do TPLJBIG2Decoder na unit PDFlibJBIG2, e o decodificador descobre o layout sozinho a partir do file header. O Anexo D do T.88 permite que os mesmos segmentos sejam arranjados de três formas: sequential (D.1) põe cada header diretamente na frente dos dados dele, random-access (D.2) põe todos os headers primeiro e todos os dados depois, e embedded (D.3) é a forma sem header usada dentro de outros contêineres. Um arquivo independente começa com o identificador de oito bytes 97 4A 42 32 0D 0A 1A 0A, depois um byte de flags, depois uma contagem de páginas de quatro bytes, a menos que as flags digam que a contagem é desconhecida
O bit 0 desse byte de flags escolhe a organização: 1 significa sequential, 0 significa random-access. Bit 1 ligado significa que o número de páginas é desconhecido e a contagem de quatro bytes está ausente, então o primeiro segment header começa no byte 9 em vez do byte 13. Os bits 2 a 7 são reservados; o decodificador aceita arquivos que os ligam em vez de rejeitá-los, porque um bit reservado solto não diz nada sobre se os próprios segmentos são legíveis
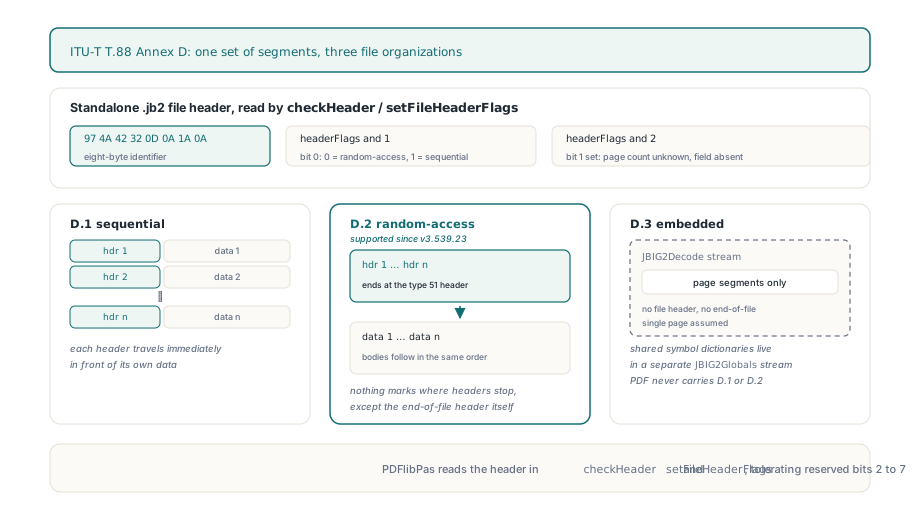
O PDF em si nunca carrega o layout random-access. Um image stream JBIG2Decode, descrito na ISO 32000-1 §7.4.7, guarda apenas segmentos de página em forma embedded, com dicionários de símbolos compartilhados movidos para um stream JBIG2Globals separado e sem file header, end-of-page ou end-of-file. Quando o decodificador não encontra o identificador de oito bytes, ele trata a entrada como exatamente esse tipo de stream: sequential, uma página. No sentido contrário, quando o PDF Library for Delphi exporta uma imagem JBIG2Decode como um arquivo .jb2 nativo, ele escreve o byte de flags $03 (sequential, contagem de páginas desconhecida) e acrescenta um segment header de end-of-file. Random access, portanto, só chega de fora, como um arquivo independente entregue direto ao TPLJBIG2Decoder, normalmente a caminho de ser convertido ou recomprimido para PDF com os backends de encoder JBIG2 do PDFlibPas
Por que não se pode ler um arquivo random-access na ordem do arquivo?
Porque nada no fluxo de bytes marca onde o bloco de headers termina e o bloco de dados começa, exceto o próprio segment header de end-of-file (tipo 51). Segment headers JBIG2 não têm tamanho fixo. A contagem de segmentos referidos é uma forma curta de três bits ou uma forma longa seguida de um bitmap de retenção; cada número de segmento referido toma um, dois ou quatro bytes dependendo de quão grande é o número do próprio segmento corrente; o campo de associação de página é de um ou quatro bytes. Um leitor precisa analisar cada campo de um header só para saber onde o próximo começa
Um leitor sequential que caminha o arquivo em ordem acerta o primeiro header e erra tudo depois. Pior: ele pode não notar por um tempo; um decodificador de generic region alimentado com bytes de header produz pixels, não um erro, até que alguma checagem posterior de comprimento ou referência finalmente tropece. O nosso ver é que um decodificador que não indexa headers primeiro deve recusar arquivos random-access de cara. Uma rejeição clara custa um arquivo num lote; um bitmap plausível mas errado pode entrar num arquivo morto e ficar lá
Indexando todo header antes do primeiro corpo
Quando o byte de flags diz random-access, o PDF Library for Delphi faz uma passada pelo bloco de headers antes de decodificar qualquer coisa. Cada header é analisado por completo e então jogado fora; a única coisa guardada é o offset dele no arquivo. Os dados comprimidos nunca são copiados para um segundo buffer reordenado, o que importa em digitalizações grandes de arquivo morto, em que o bloco de dados pode ser a maior parte do arquivo. A passada para no primeiro header de end-of-file, e nesse ponto a posição de leitura senta no primeiro byte dos dados do primeiro segmento
Um arquivo random-access tem menos redundância que um sequential, então o pre-scan é estrito. Ele rejeita o arquivo quando:
- um header é cortado pelo fim do buffer, reportado como
JBIG2 truncated random-access header at byte Ncom o offset em que aquele header começou - números de segmento não crescem estritamente (comparados como valores sem sinal), porque dois headers reivindicando o mesmo número deixam ambígua a lista de referidos de uma região posterior
- um data length tem o bit mais alto ligado, o que inclui o marcador
0xFFFFFFFFde "comprimento desconhecido"; neste layout não há outro jeito de achar onde o próximo corpo começa, então o decodificador o recusa de imediato em vez de varrer à procura de um marcador de fim - o header de end-of-file declara qualquer dado, ou nunca aparece (
JBIG2 random-access file is missing its end-of-file header) - os comprimentos declarados somam mais que os bytes que restam, ou menos
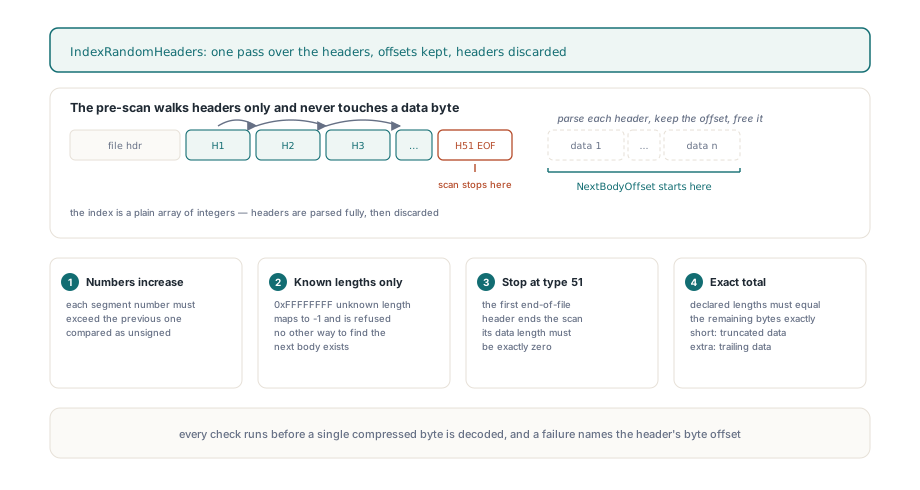
A última regra é a que as pessoas tropeçam. Um único byte extra depois do corpo final falha com JBIG2 trailing random-access data. Isso parece duro perto do caminho sequential, em que a decodificação simplesmente para no segmento de end-of-file e qualquer coisa depois é ignorada. A assimetria tem razão. No layout sequential cada header senta ao lado dos próprios dados dele, então lixo no fim não pode ter deslocado nada. No layout random-access os headers são o único mapa do bloco de dados, e se os comprimentos não fecham, o decodificador não distingue padding inofensivo de um byte perdido ou acrescentado muito antes que deslocou todo corpo depois dele
Por que um loop contado por bytes derruba o último segmento end-of-page?
Um loop que roda "enquanto sobram bytes" termina cedo demais num arquivo random-access, porque os dados acabam antes do índice de headers. Segmentos end-of-page (tipo 49) e end-of-file carregam zero bytes de dados e normalmente vêm por último. Uma vez que o corpo da região final foi consumido, a posição de leitura está exatamente no fim do buffer; um loop contado por bytes sai ali, e o segmento end-of-page de comprimento zero nunca é despachado, o que deixa a página inacabada
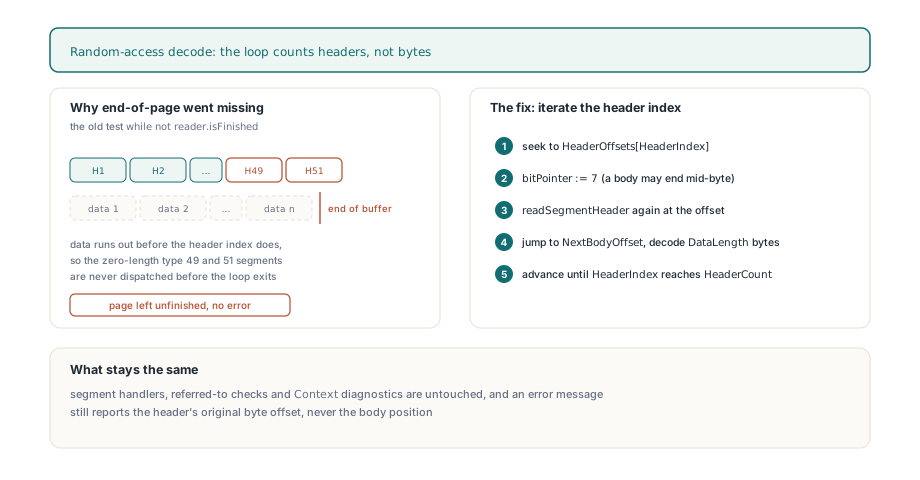
Então, para arquivos random-access, o decodificador conta headers, não bytes. Cada passo salta de volta ao próximo header indexado, realinha a um limite de byte (um corpo codificado aritmeticamente pode terminar no meio de um byte), analisa o header de novo, depois salta para onde o próximo corpo começa e avança além dele pelo comprimento declarado. Um corpo cujo decodificador termina cedo é pulado até o fim declarado dele; um que lê além é rejeitado. Daí o segmento passa pelos mesmos handlers e checagens de referência de um arquivo sequential. Erros lançados ao decodificar um corpo carregam a posição original do header, na forma JBIG2 segment N (type T) at byte B: ..., então o offset no LastError aponta para algo que você pode achar num editor hex
Carregando um arquivo .jb2 random-access no Delphi
O código da aplicação não muda com a organização. TPLJBIG2Decoder.LoadFromByteArray detecta o file header e o layout, devolve False em qualquer entrada recusada com o motivo no LastError, e expõe a página decodificada por meio de Width, Height e GetScanline, que enche um byte por pixel com 1 para preto
uses
  SysUtils, Classes, PDFlibJBIG2;

function ReadJb2(const FileName: string): TJBIG2ByteArray;
var
  FS: TFileStream;
begin
  FS := TFileStream.Create(FileName, fmOpenRead or fmShareDenyWrite);
  try
    SetLength(Result, FS.Size);
    if Length(Result) > 0 then
      FS.ReadBuffer(Result[0], Length(Result));
  finally
    FS.Free;
  end;
end;

function CountBlackPixels(const FileName: string): Integer;
var
  Decoder: TPLJBIG2Decoder;
  Row: TJBIG2ByteArray;
  X, Y: Integer;
begin
  Result := 0;
  Decoder := TPLJBIG2Decoder.Create;
  try
    // Arquivos standalone sequential e random-access usam a mesma chamada
    if not Decoder.LoadFromByteArray(ReadJb2(FileName)) then
      raise Exception.Create('JBIG2 rejected: ' + Decoder.LastError);
    for Y := 0 to Decoder.Height - 1 do
      if Decoder.GetScanline(Y, Row) then
        for X := 0 to Decoder.Width - 1 do
          if Row[X] = 1 then
            Inc(Result);
  finally
    Decoder.Free;
  end;
end;
Se você quer saber qual layout um arquivo usa, para log ou para ordenar um corpus antes de uma conversão, leia o byte de flags você mesmo. A biblioteca não expõe a organização que detectou, e nove bytes são tudo de que você precisa. O helper abaixo é algo a acrescentar ao seu próprio código; ele apenas reenuncia as regras de header do T.88:
type
  TJb2Layout = (jlNoFileHeader, jlSequential, jlRandomAccess);

// Helper seu, fora do PDFlibJBIG2: classifica um buffer pelo file header T.88 dele
function DetectJb2Layout(const Data: TJBIG2ByteArray;
  out PageCountKnown: Boolean): TJb2Layout;
const
  Signature: array[0..7] of Byte = ($97, $4A, $42, $32, $0D, $0A, $1A, $0A);
var
  I: Integer;
begin
  Result := jlNoFileHeader;          // p. ex. um stream embutido tirado de um PDF
  PageCountKnown := False;
  if Length(Data) < 9 then
    Exit;
  for I := 0 to 7 do
    if Data[I] <> Signature[I] then
      Exit;
  PageCountKnown := (Data[8] and 2) = 0;   // bit 1 ligado: sem contagem de páginas de quatro bytes
  if (Data[8] and 1) = 0 then
    Result := jlRandomAccess
  else
    Result := jlSequential;
end;
Jobs em lote: buffers com padding e arquivos recusados
A regra de trailing data é onde código em lote costuma errar, e quando um arquivo que abre em outro lugar é recusado assim, olhe o buffer antes do arquivo. Um .jb2 tirado de uma coluna BLOB de banco de dados, uma leitura de rede de tamanho fixo ou um formato contêiner com padding de alinhamento pode chegar com alguns bytes zero depois do fim real. Um arquivo sequential dá de ombros. Um arquivo random-access com o mesmo padding falha com JBIG2 trailing random-access data, e um buffer cortado alguns bytes antes também falha, como truncado. Passe exatamente os bytes do arquivo, dimensionados pelo comprimento real da origem, nunca por um tamanho de chunk ou uma capacidade
Um arquivo recusado também não deixa nada para trás. LoadFromByteArray zera Width, Height e os scanlines antes de começar a decodificar, então uma chamada que falha reporta dimensões zero em vez da página do arquivo anterior, e a mesma instância de decodificador pode seguir direto para o próximo arquivo:
procedure DecodeBatch(const Files, Log, Quarantine: TStrings);
var
  Decoder: TPLJBIG2Decoder;
  I: Integer;
begin
  Decoder := TPLJBIG2Decoder.Create;
  try
    for I := 0 to Files.Count - 1 do
      if Decoder.LoadFromByteArray(ReadJb2(Files[I])) then
        Log.Add(Format('%s: %d x %d', [Files[I], Decoder.Width, Decoder.Height]))
      else
      begin
        // Width e Height são 0 aqui; nada do arquivo anterior sobrevive
        Log.Add(Files[I] + ': ' + Decoder.LastError);
        if Pos('trailing random-access data', Decoder.LastError) > 0 then
          Quarantine.Add(Files[I]);   // veja como os bytes foram guardados antes de culpar o arquivo
      end;
  finally
    Decoder.Free;
  end;
end;
Conferir isso no seu próprio pipeline não precisa de arquivos de amostra raros. Reorganize um .jb2 sequential no layout random-access, guardando todo header e todo byte comprimido, mova os headers de end-of-page e end-of-file para o fim do bloco de headers, e os pixels decodificados devem bater com o original sequential exatamente, tanto com quanto sem o campo de contagem de páginas. Depois alimente-o com todo prefixo truncado, um número de segmento duplicado, um byte final extra e um comprimento 0xFFFFFFFF; cada um deve devolver False com Width e Height em zero
O que o decodificador devolve e o que ele espera
Random access aqui é uma propriedade do layout do arquivo. O TPLJBIG2Decoder devolve o bitmap da primeira página seja qual for a organização do arquivo, e Width e Height descrevem essa página. Todo segmento deve declarar o comprimento dos dados dele; o T.88 deixa um immediate generic region usar o marcador 0xFFFFFFFF, e o decodificador recusa esse marcador em qualquer layout com unknown or oversized segment length is not supported. Comprimentos de prefixo Huffman customizados e contagens de entrada de tabela são limitados do mesmo jeito que em arquivos sequential
Decodificar JBIG2 é um estágio de um caminho de imagem maior que também cobre extração de imagens de PDF, recompressão e encoding JBIG2; a página de produto do PDF Library for Delphi cobre o resto desse pipeline e os formatos de imagem suportados