Faça um dump byte a byte de um segmento JBIG2 Tables (tipo 53) e a primeira surpresa é o que ele deixa de fora: os próprios códigos Huffman. Você recebe um byte de flags, dois limites e uma sequência de números pequenos, e esses números são comprimentos de código. Encoder e decoder reconstruem os bit patterns reais a partir dos comprimentos com o procedimento do ITU-T T.88 Annex B.3. Reconstrua numa ordem um pouco diferente e você ainda obtém um prefix code válido, todo pattern continua decodificando, e todo valor sai anexado ao pattern errado
Numa página codificada com symbol IDs Huffman e tables fornecidas pelo encoder, essa divergência parece um scan ruim: glyphs alguns pixels fora de lugar, caracteres montados dos symbols errados, ou números plausíveis até uma largura sair da faixa vários segmentos depois. A maior parte do JBIG2 em arquivos PDF é arithmetic-coded, e a maior parte do JBIG2 Huffman-coded fica nas standard tables B.1 a B.15. Arquivos que embarcam as próprias tables são raros, e costumam exercitar o parser de tables, refinement Huffman-coded e collective bitmaps não comprimidos todos de uma vez
O que um segmento Tables realmente carrega
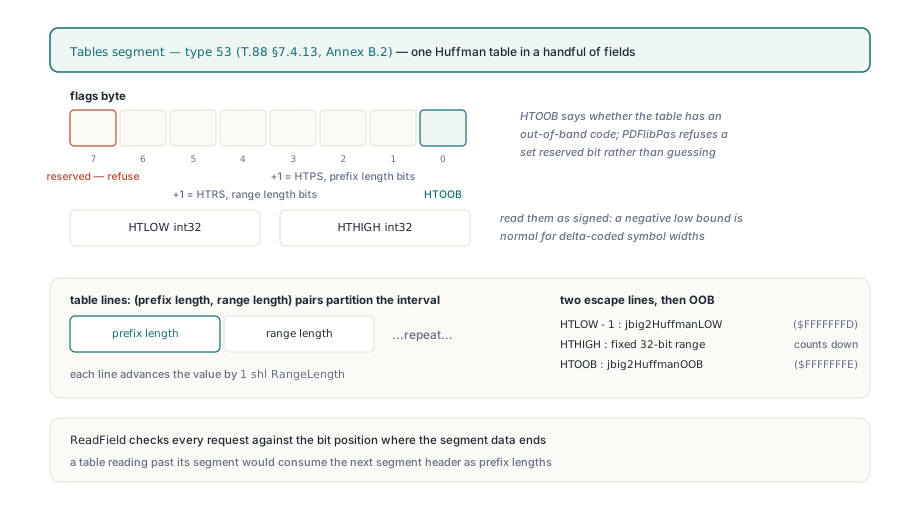
Um segmento Tables descreve exatamente uma tabela Huffman. O T.88 §7.4.13 e o Annex B.2 o definem como um byte de flags, um HTLOW signed de 32 bits, um HTHIGH signed de 32 bits, e depois pares (prefix length, range length) que ladrilham o intervalo de HTLOW até HTHIGH. O bit 0 das flags é o HTOOB, que diz se a tabela tem um código out-of-band. Os bits 1 a 3 mais um dão o HTPS, a largura de cada campo de prefix length. Os bits 4 a 6 mais um dão o HTRS, a largura de cada campo de range length. O bit 7 é reservado
Os limites são onde um parser escrito à mão costuma tropeçar primeiro. Leia o HTLOW como unsigned e uma tabela que começa em -2, o que é comum para larguras e alturas de symbols delta-coded, de repente alega começar um pouco abaixo de 4,3 bilhões. O PDF Library for Delphi lê os dois limites como valores signed, recusa uma tabela cujo HTLOW não esteja abaixo do HTHIGH ou cujo range length exceda 32, e confere toda leitura de campo contra o bit em que os dados declarados do segmento acabam. Essa última checagem importa mais do que parece: uma tabela que lê além do segmento dela consome o header do próximo segmento como prefix lengths e parseia um nonsense completo. Bit 7 setado falha com reserved custom Huffman table flag. Preferimos essa recusa a um chute, porque uma tabela chutada produz pixels errados que ninguém consegue rastrear até a causa
Depois das linhas regulares vêm as escape lines do Annex B.2. A lower range line começa em HTLOW menos um e conta para baixo por um offset de 32 bits, a upper range line começa em HTHIGH com um range de 32 bits, e a out-of-band line existe só quando o HTOOB está setado. Essas linhas carregam os mesmos marcadores que as standard tables embutidas usam, então uma custom table e a Table B.6 passam por um único loop de decodificação. Uma custom table pode ter até 65.536 linhas
Por que os prefix codes têm de ser atribuídos na ordem das linhas da tabela?
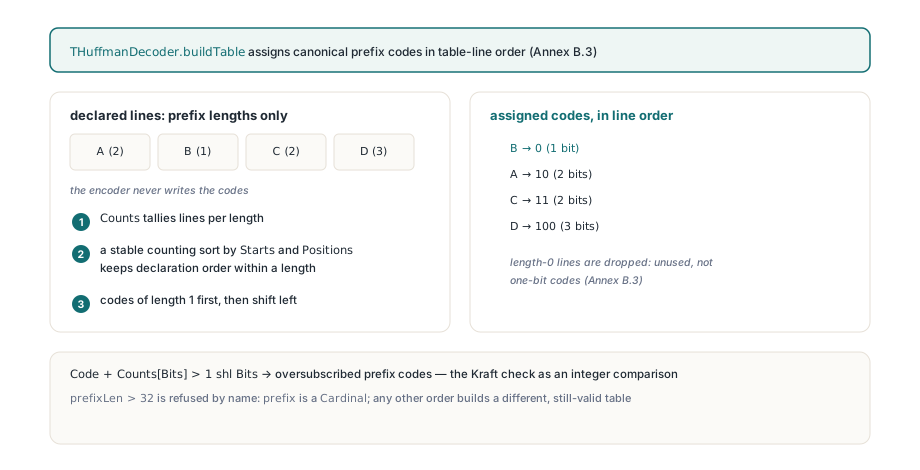
Porque a ordem de declaração é a única coisa que liga um bit pattern a uma faixa de valores. O Annex B.3 conta quantas linhas usam cada prefix length, distribui códigos de comprimento 1 primeiro, desloca à esquerda para mudar para o comprimento 2, e assim por diante; dentro de um comprimento, os códigos vão para as linhas na ordem em que aparecem no segmento. Uma tabela pequena torna isso concreto. Seis linhas, rotuladas A a F em ordem de arquivo, com estes prefix lengths:
| Linha | Prefix length | Código (ordem de arquivo mantida) | Código se B e D trocam |
|---|---|---|---|
| A | 2 | 00 | 00 |
| B | 3 | 100 | 101 |
| C | 2 | 01 | 01 |
| D | 3 | 101 | 100 |
| E | 3 | 110 | 110 |
| F | 0 | não usado | não usado |
As duas colunas são prefix codes válidos. Só a da esquerda é o que o encoder queria dizer: com B e D trocadas, o pattern 100 rende a faixa de valores de D e o decoder continua com um número do intervalo errado. A linha F tem comprimento 0, que o B.3 define como não usada; dê a ela um código de um bit e toda atribuição posterior se desloca
O caminho fácil para obter a coluna da direita é um sort genérico por prefix length. O TArray.Sort e o TList<T>.Sort do Delphi não são estáveis, então comprimentos iguais podem voltar em qualquer ordem. Para canonical codes nas suas próprias ferramentas, caminhe pelas linhas em ordem de arquivo, uma vez por comprimento:
uses
  System.SysUtils;

type
  TCodeLine = record
    PrefixLen: Integer;   // como lido do segmento Tables
    Code: Cardinal;       // atribuído abaixo
  end;

// Atribuição canônica do Annex B.3, escrita para as suas próprias ferramentas.
// Comprimentos iguais mantêm a ordem de arquivo; comprimento 0 não recebe código.
procedure AssignCanonicalCodes(var Lines: array of TCodeLine);
var
  LenCount: array[0..32] of UInt64;
  FirstCode: array[0..32] of UInt64;
  NextCode: UInt64;
  CurLen, I: Integer;
begin
  FillChar(LenCount, SizeOf(LenCount), 0);
  for I := 0 to High(Lines) do
  begin
    if (Lines[I].PrefixLen < 0) or (Lines[I].PrefixLen > 32) then
      raise Exception.Create('prefix length out of range');
    Inc(LenCount[Lines[I].PrefixLen]);
  end;
  LenCount[0] := 0;
  FirstCode[0] := 0;
  for CurLen := 1 to 32 do
  begin
    FirstCode[CurLen] := (FirstCode[CurLen - 1] + LenCount[CurLen - 1]) shl 1;
    // Kraft check: mais códigos do que este comprimento comporta
    if FirstCode[CurLen] + LenCount[CurLen] > (UInt64(1) shl CurLen) then
      raise Exception.Create('oversubscribed prefix lengths');
    NextCode := FirstCode[CurLen];
    for I := 0 to High(Lines) do       // a ordem de arquivo é o desempate
      if Lines[I].PrefixLen = CurLen then
      begin
        Lines[I].Code := Cardinal(NextCode);
        Inc(NextCode);
      end;
  end;
end;
Alimente com as seis linhas acima e A recebe 00, C recebe 01, B recebe 100, D recebe 101 e E recebe 110; F fica sem código. O PDF Library for Delphi faz o mesmo trabalho com uma passada de contagem, que é estável por construção e evita reescanear a tabela 32 vezes, e aplica os mesmos dois guards. Comprimentos sobrecarregados falham com oversubscribed Huffman prefix codes; deixe passar e um pattern pode casar com duas linhas. Prefixos maiores que 32 bits também falham pelo nome, embora o T.88 os permita no papel. Achamos que esse teto é o trade certo: cada código cabe numa word de máquina, e um arquivo que precise de mais tem muito mais chance de estar danificado do que de ser esperto
Os valores pedem o mesmo cuidado. A lower range line decodifica como HTLOW menos um menos um offset unsigned de 32 bits, e com um intermediário Integer de 32 bits essa subtração pode dar wrap numa largura positiva de aparência comum. O decoder faz a conta em 64 bits e levanta Huffman value exceeds signed integer range quando o resultado verdadeiro não cabe
Ordem dos seletores, e duas armadilhas que se cobrem mutuamente
Uma text region ou um symbol dictionary não nomeia as tables dele. Ele carrega seletores de dois bits, e cada seletor setado para custom toma o próximo segmento Tables da lista referred-to, na ordem de referral. O T.88 §7.4.3.1.2 ordena os seletores de text region como FS, DS, DT, RDW, RDH, RDX, RDY e RSIZE; o §7.4.2.1.1 ordena os seletores de symbol dictionary como DH, DW, BMSIZE e AGGINST. Valores 0 e 1 escolhem standard tables, 3 escolhe uma custom, e 2 é reservado em campos com só duas standard tables. O PDF Library for Delphi rejeita valores de seletor reservados, e falha com missing custom Huffman table reference quando os seletores querem mais custom tables do que a região refere
Se você escrever o seu próprio decoder, dois erros são fáceis de cometer aqui, e cada um esconde o outro. O primeiro morde no Delphi, ou no FPC em modo Delphi (o modo objfpc rejeita o código como identificador duplicado): um setter de flags cujo parâmetro tem o mesmo nome do campo. O parâmetro sombreia o campo, Flags := Flags atribui a ele mesmo, e o campo fica zero. Todo seletor então lê zero, uma text region usa as standard tables B.6, B.8 e B.11 para FS, DS e DT não importando o que o arquivo pediu, e o caminho custom nunca roda
O segundo fica no symbol dictionary. Um Huffman dictionary pode armazenar os symbols dele como um collective bitmap não comprimido (BMSIZE de zero), em que cada linha termina num byte parcial. O valor de padding é o número de bits válidos naquele byte, e é tentador lê-lo como a posição do bit válido mais baixo:
// Último byte de uma linha de collective-bitmap, bits lidos MSB primeiro.
// Padding := TotalWidth mod 8  -> número de bits VÁLIDOS neste byte

// Errado: trata Padding como o índice do bit mais baixo a copiar
for BitPos := 7 downto Padding do
  CopyPixel((LastByte shr BitPos) and 1);

// Certo: o índice do bit válido mais baixo é 8 - Padding (0 quando Padding = 0)
for BitPos := 7 downto ((8 - Padding) and 7) do
  CopyPixel((LastByte shr BitPos) and 1);

// CopyPixel representa o que quer que escreva o pixel no seu próprio decoder
Confira as larguras de fronteira. Uma linha de 63 pixels tem padding 7: o loop errado copia um bit do último byte, o certo copia sete. Uma linha de 9 pixels tem padding 1: o loop errado copia sete, o certo copia um. A 64 pixels ambos copiam os oito, então múltiplos de 8 nunca o expõem. Collective bitmaps sintéticos de 7 e 9 pixels de largura cravam os dois lados da fronteira de byte. E o dano viaja, porque o refinement usa esses symbols como referências
Se o seu próprio decoder tiver as duas armadilhas, debugar fica miserável. Corrija só o setter e o caminho custom finalmente roda, direto para collective bitmaps quebrados, então a página continua parecendo errada. Corrija só o padding e nada visível muda, porque o caminho custom continua inalcançável. Teste os dois com inputs sintéticos antes de confiar em qualquer uma das mudanças. Um detalhe relacionado: um Huffman symbol dictionary cujo input e new symbols somam um recebe um symbol code length de 0 pela fórmula log2, mas a variante Huffman escreve todo symbol ID com pelo menos um bit. O PDF Library for Delphi sobe esse comprimento para 1 em modo Huffman
Onde o refinement Huffman lê o tamanho do bitmap dele?
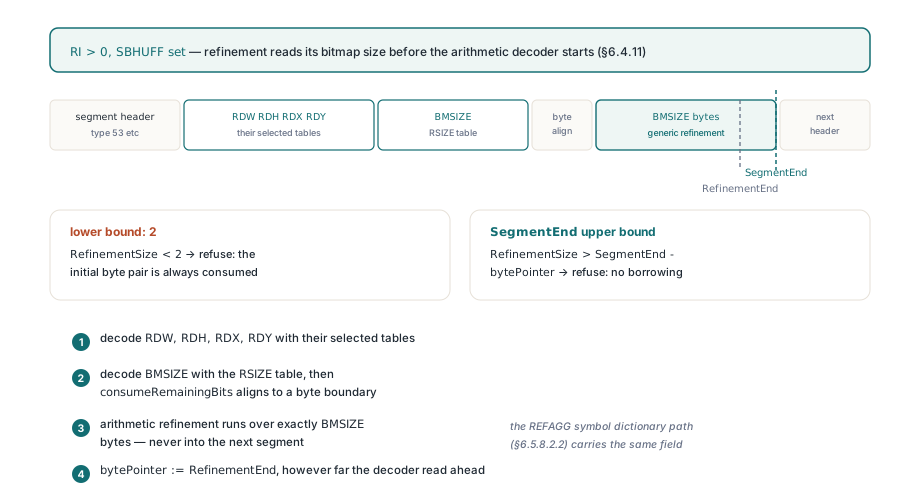
De um campo BMSIZE que só existe em modo Huffman, decodificado à frente dos dados de refinement aritmético. Quando uma instância de text region tem refinement (RI não-zero) e o SBHUFF está setado, o T.88 §6.4.11 manda o decoder ler RDW, RDH, RDX e RDY com as tables selecionadas, depois BMSIZE com a table RSIZE, depois pular para uma fronteira de byte, e só então rodar decodificação de refinement genérico sobre exatamente BMSIZE bytes. Text regions em modo aritmético não têm esse campo, então um decoder que compartilha um caminho de código entre os modos o pula, inicia o arithmetic decoder cedo, e refina todo symbol contra ruído. O caminho de symbol dictionary com REFAGG e uma única instância de refinement (§6.5.8.2.2) tem o mesmo campo
O PDF Library for Delphi limita o BMSIZE dos dois lados. O mínimo é 2, o par inicial de bytes que o arithmetic decoder sempre consome. O máximo é o que resta do segmento corrente, deliberadamente não do stream inteiro: um BMSIZE que só cabe tomando bytes emprestados do próximo segmento está malformado, e uma checagem de comprimento de stream deixaria o arithmetic decoder ler para dentro do header seguinte. Tamanhos fora da faixa falham com invalid refinement bitmap size. Depois o leitor Huffman retoma exatamente BMSIZE bytes além do campo, não importando o que o arithmetic decoder leu à frente
O comprimento declarado do segmento é a fronteira
Todo header de segmento declara quantos bytes de dados vêm depois, e o decoder segura o segmento nesse número nas duas direções: ler além do fim é erro, terminar cedo é normal, e o próximo header é sempre lido de onde o arquivo disse que ele começa. Regras menores se seguem. O unknown data length do T.88 §7.2.7 é recusado de cara em vez de escanear por um terminador. Segmentos referred-to precisam carregar números menores que o corrente e já existir. END_OF_PAGE e END_OF_FILE precisam declarar zero bytes de dados. Um segmento Profiles (tipo 52) precisa ter exatamente 4 mais 4 vezes a contagem de identificadores dele; ele é então pulado mas mantido, para que segmentos posteriores ainda possam referenciá-lo, e um identificador de profile desconhecido não para o decode
O caso clássico de terminar cedo é MMR. Um decoder MMR está pronto quando produz o último pixel da última linha, o que pode acontecer antes do terminador EOFB que o T.88 §6.2.5.7 põe no fim dos dados. Um leitor que assume que agora está no próximo header parseia os bytes EOFB restantes como um número de segmento e falha alguns bytes depois, longe da causa real. Pular para o fim declarado evita a questão. O mesmo hábito percorre como o PDF Library for Delphi parseia estruturas PDF não confiáveis em geral
Decodificando um image stream JBIG2 do Delphi
O decoder vive na unit PDFlibJBIG2 como TPLJBIG2Decoder. O LoadFromByteArray recebe os dados JBIG2 embutidos de uma imagem /JBIG2Decode e, opcionalmente, os dados do stream /JBIG2Globals dela, que é onde custom tables e symbol dictionaries compartilhados costumam viver. Retorna False em qualquer recusa e deixa o motivo no LastError; output de uma chamada anterior é limpo no início de cada chamada, então um decode falhado nunca deixa pixels velhos para o caller confundir com um resultado
uses
  System.SysUtils, PDFlibJBIG2;

// ImageBytes: os dados do image stream com quaisquer filtros à frente de
//   JBIG2Decode já removidos
// GlobalBytes: os dados do stream /JBIG2Globals, ou um array vazio
function DecodeAndCountBlack(const ImageBytes, GlobalBytes: TJBIG2ByteArray;
  out BlackPixels: Int64): Boolean;
var
  Decoder: TPLJBIG2Decoder;
  Line: TJBIG2ByteArray;
  Row, Col: Integer;
begin
  BlackPixels := 0;
  Decoder := TPLJBIG2Decoder.Create;
  try
    Result := Decoder.LoadFromByteArray(ImageBytes, GlobalBytes);
    if not Result then
    begin
      // Form: 'JBIG2 segment <n> (type <t>) at byte <offset>: <reason>'
      Writeln('JBIG2 refused: ', Decoder.LastError);
      Exit;
    end;
    for Row := 0 to Decoder.Height - 1 do
    begin
      Decoder.GetScanline(Row, Line);   // um byte por pixel, 0 ou 1
      for Col := 0 to Decoder.Width - 1 do
        Inc(BlackPixels, Line[Col]);    // 1 = preto no JBIG2
    end;
  finally
    Decoder.Free;
  end;
end;
A contagem de pixels pretos é uma checagem sua, um fingerprint barato para comparar contra um segundo renderer. Falhas de segmento chegam prefixadas com número de segmento, tipo e offset de byte, então um (type 53) na frente de oversubscribed Huffman prefix codes aponta direto para um segmento Tables. Mantenha os dois canais de erro separados: o TPLJBIG2Decoder.LastError é o texto de diagnóstico deste decoder, enquanto o TPDFlib.LastErrorCode é o código numérico da API de nível de library. A seleção de página segue o stream: o decoder retorna o bitmap do primeiro segmento page-information que encontra e não procura associação de página 0, porque JBIG2 embutido em PDF carrega uma página e encoders rotineiramente a numeram 1
Comparar renderers nesses arquivos pede alguma humildade, porque decoders JBIG2 independentes nem sempre concordam em arquivos de custom tables com refinement Huffman. Dois decoders em desacordo não decide nada. Os campos do formato decidem: quais tables os seletores escolheram, o que o BMSIZE declarou, onde cada segmento termina
A codificação é coberta no artigo sobre backends de encoder JBIG2 e como são linkados. O caminho de leitura precisa aceitar o que o encoder de outra pessoa emitiu, e compartilha as regras dele com o decoder TIFF embutido e as checagens de BigTIFF e layout tiled dele: recuse pelo nome, nunca tome bytes emprestados através de uma fronteira declarada, mantenha a aritmética intermediária larga. Se uma pasta de PDFs escaneados continua tropeçando outros toolkits, verifique se as imagens são JBIG2 Huffman-coded com custom tables, então teste-as contra o caminho de leitura nativo Delphi e C++Builder descrito na página do produto PDF Library for Delphi