Escape um comentário de cliente direito, de forma que <b>urgent</b> entre no seu template HTML como <b>urgent</b>, entregue-o a um renderer que parseia o markup duas vezes, e o PDF pode voltar com a palavra urgent em negrito. O escaping estava correto. O renderer decodificou uma vez por passada. Qualquer caminho HTML-to-PDF que parseia, escreve o resultado de volta como HTML e parseia de novo tem de decodificar entidades exatamente uma vez na viagem inteira
A versão help desk dessa história é comum. Tickets são exportados para PDF, o comentário do cliente senta dentro de um <p>, e alguém digita angle brackets na caixa de comentário. Um nome de tag desconhecido simplesmente desaparece da página. Uma âncora escapada vira uma link annotation clicável num documento que o seu pessoal confia. O arquivo é válido e abre em todo lugar; ele simplesmente diz algo diferente dos dados
Onde texto escapado vira markup de volta
Texto escapado vira markup no ponto em que um renderer two-pass escreve texto já decodificado de volta para HTML sem escapá-lo de novo. O que quer que o primeiro parse tenha decodificado é então sintaxe viva para o segundo parse
As duas passadas no DrawHTMLText e no DrawHTMLTextBox do PDF Library for Delphi (PDFlibPas) existem por uma boa razão. O primeiro parse divide o input em tags e palavras. O renderer então resolve a cascata de stylesheet: regras de blocos <style> são matched contra cada tag, fundidas com atributos style inline, e a lista inteira de elementos é escrita de volta como uma string HTML normalizada com toda tag carregando o style final dela. A passada de layout parseia essa string. Selector matching, flexbox, grid e o resto do suporte CSS descrito em flexbox, CSS grid e layout de footnotes no rendering HTML do PDFlibPas dependem todos desse passo intermediário
O perigo senta em como as palavras voltam para fora. Tags podem ser escritas de volta da forma fonte delas, mas palavras são seguradas como texto decodificado, porque é isso que o line breaker mede. Concatene a palavra que veio de <unsafe> à string normalizada como está, e <unsafe> chega ao segundo parse como um elemento. Um design que decodifica uma vez tem de fechar três vazamentos menores também:
- Se
&não está no conjunto decodificado,R&Dimprime literalmente e não há jeito nenhum de pôr a grafia<na página como texto - Se o estágio de desenho substitui
de novo depois de o parsing terminar, uma grafia literal de entidade desaparece no último momento - Se um producer HTML upstream, como um conversor Markdown ou um exporter de dataset, escapa só os angle brackets, uma grafia de entidade dentro de um code sample ou valor de célula é decodificada em markup
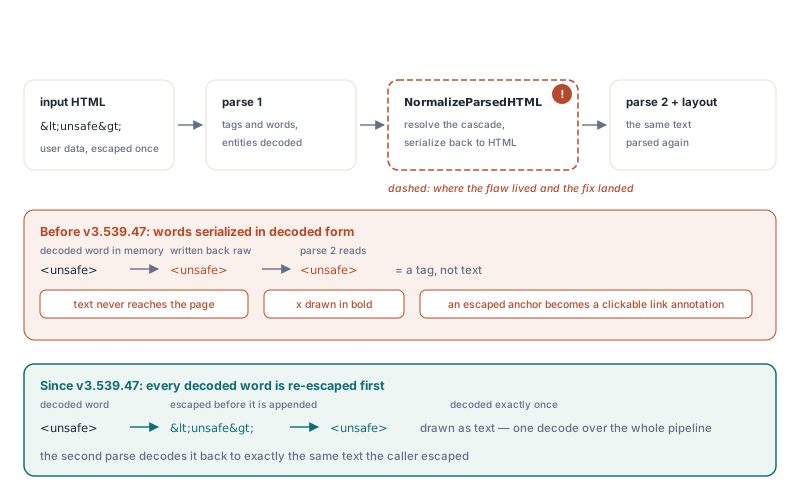
A tabela abaixo lista o que chega à página para um punhado de inputs, comparando um renderer two-pass ingênuo com o pipeline do PDFlibPas
| Input chegando ao renderer | Renderer two-pass ingênuo | PDFlibPas |
|---|---|---|
<unsafe> | Parseado como tag, o texto nunca chega à página | <unsafe> desenhado como texto |
<b>x</b> | x desenhado em negrito | <b>x</b> desenhado como texto |
R&D | R&D impresso literalmente | R&D |
&lt; | &lt; impresso literalmente | < |
Code span Markdown contendo | Um non-breaking space | desenhado como texto |
Valor de célula de dataset < | < | < |
Como o PDF Library for Delphi decodifica cada entidade exatamente uma vez?
O PDF Library for Delphi decodifica cada entidade exatamente uma vez seguindo três regras juntas: o parser decodifica & por último, o estágio de desenho não decodifica nada, e todo lugar que transforma palavras decodificadas de volta em HTML as escapa primeiro. Derrube qualquer uma das três e uma das linhas da tabela acima vira a coluna ingênua
Comece pelo que é decodificado. Em conteúdo de texto o parser reconhece <, >, & e . Referências numéricas como A e named entities como " ficam como texto literal. Essa lista curta decide como você deve escapar o seu próprio input, o que volta mais abaixo
A ordem dentro do decoder importa mesmo dentro de uma única passada. Decodifique & primeiro e o input &lt; vira <, e a substituição seguinte o transforma em <: um double decode sem segundo parse nenhum. O caminho de palavras de 8 bits por isso substitui <, > e primeiro e & por último, então o ampersand que ele produz nunca é olhado de novo. O caminho de palavras UTF-16 toma uma rota diferente para o mesmo resultado — um único scan da esquerda para a direita em passos de dois bytes que reescreve cada match no lugar e avança além dele
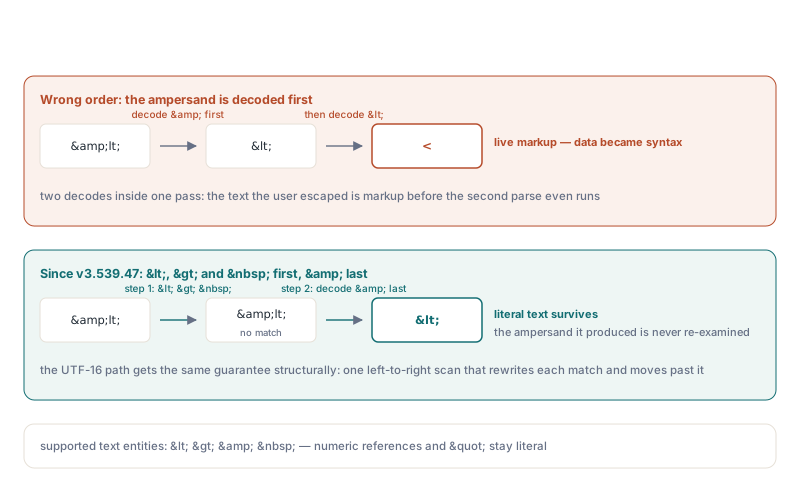
O estágio de desenho não recebe substituição tardia de . Uma palavra que chega ao line breaker é texto final, e a decodificação vive no parser e em lugar nenhum mais
A regra de fronteira carrega o maior peso. Quando o renderer escreve o HTML normalizado, ele escapa &, < e > em toda palavra decodificada antes de concatená-la, e o segundo parse decodifica de volta para os mesmos caracteres. Efeito líquido sobre as duas passadas: um decode. A string de continuação que o DrawHTMLTextBox retorna segue a mesma regra. Palavras que não couberam são escapadas antes de entrarem no remainder, e o resto do remainder é copiado do HTML normalizado, que já está escapado. Uma box que couber com tudo retorna string vazia
Por que o escaping UTF-16BE não pode usar um replace a nível de byte?
O escaping UTF-16BE não pode usar um replace a nível de byte porque os dois bytes de um ampersand podem cavalgar dois caracteres sem relação. A code unit de 16 bits inteira é a única unidade de trabalho segura
O renderer guarda palavras Unicode como UTF-16 big-endian empacotadas em byte strings, byte alto primeiro, então um ampersand é 00 26. Tome U+0100 (Latin capital A with macron, bytes 01 00) seguido de U+2603 (o boneco de neve, bytes 26 03). O buffer lê 01 00 26 03, e os bytes dois e três soletram 00 26. Uma busca por bytes por #0'&' encontra um ampersand que nenhum caractere contém, enxerta & no meio de dois code points, e desloca todo caractere posterior em um byte
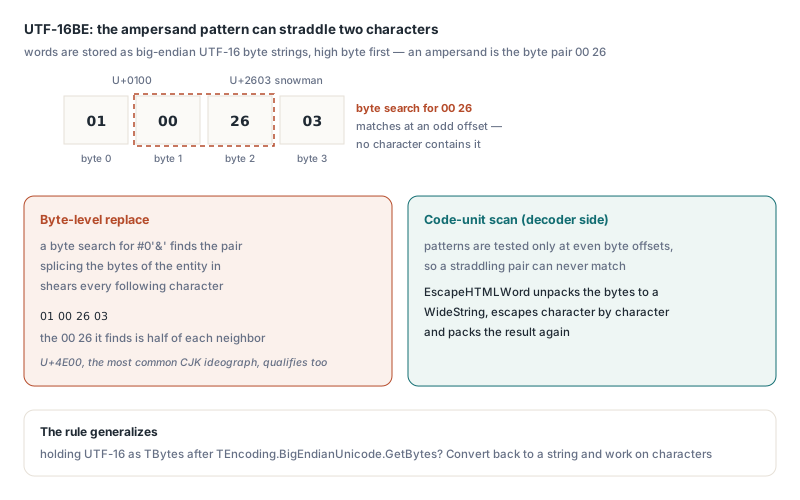
Isso não é um canto exótico. Qualquer caractere cujo byte baixo é zero pode fornecer a primeira metade, e U+4E00, um dos ideógrafos CJK mais frequentes, é tal caractere. Os angle brackets ficam expostos do mesmo jeito: 00 3C e 00 3E aparecem sempre que tal caractere é seguido por um de U+3C00 a U+3EFF no CJK Extension A. Então o PDFlibPas escapa palavras Unicode desempacotando-as para um WideString, escapando caractere por caractere e empacotando o resultado de novo. O decoder é seguro pela razão correspondente: ele só testa padrões em offsets pares
O seu próprio código pode bater na mesma parede. Uma vez que texto UTF-16 viva em TBytes, por exemplo depois de TEncoding.BigEndianUnicode.GetBytes, procurar nele por padrões de bytes é um bug esperando o par certo de caracteres. Converta de volta para string e trabalhe sobre caracteres
Code Markdown e células de dataset: o ampersand vai primeiro
Ambos os producers HTML dentro do PDFlibPas, o conversor Markdown e o exporter de dataset, escapam o ampersand antes dos angle brackets, então o único decode no renderer restaura o texto original byte a byte
No MarkdownToHTML, inline code spans e fenced ou indented code blocks mapeiam & para &, < para < e > para >. Espaços viram e um tab vira quatro deles, o que mantém a indentação intacta. Prosa comum escapa só os angle brackets: HTML cru digitado em prosa não pode injetar tags, enquanto um autor que deliberadamente escreve & ainda recebe um ampersand, do jeito que autores Markdown esperam. DrawMarkdownText e DrawMarkdownTextBox rodam a mesma conversão, então um code block aparece exatamente como digitado:
uses
System.SysUtils, PDFlibrary;
procedure RenderCodeSample;
var
Lib: TPDFlib;
Md, Html: WideString;
begin
Md := 'Comparison helper:' + sLineBreak + sLineBreak +
'```' + sLineBreak +
'if (A < B) and (Flags <> 0) then' + sLineBreak +
' WriteLn(''<tag> & R&D'');' + sLineBreak +
'```';
Lib := TPDFlib.Create;
try
// Inspecione o HTML: dentro de code, '&' vira '&' e '<' vira '<'
Html := Lib.MarkdownToHTML(Md);
Lib.SetOrigin(1); // origem topo-esquerda, Y cresce para baixo
Lib.SetMeasurementUnits(0); // points
// A página mostra o código exatamente como digitado, grafias de entidades incluídas
Lib.DrawMarkdownText(50, 50, 495, Md);
Lib.SaveToFile('code-sample.pdf');
finally
Lib.Free;
end;
end;O exporter de dataset é onde mora o atalho tentador. Se um renderer não decodificasse &, escapar o ampersand imprimiria & em toda célula que contém um, então escapar só os angle brackets parece a escolha mais amigável. Ela desmorona na primeira célula cujo valor por acaso contém <, que então chega à página como <. Como o renderer decodifica &, o exporter por trás do PDFlibExportDataSet escapa & primeiro, e um valor como R&D < & pousa no PDF verbatim. O resto desse exporter é coberto em exportar um TDataSet para um relatório PDF no Delphi
Por que primeiro, e não só em algum ponto da cadeia? Escape < primeiro e você obtém <. Escape & segundo e isso vira &lt;, que um decode único correto exibe como < em vez de <. Uma cadeia de replaces sequenciais só funciona quando o escape character em si é tratado antes de qualquer passo que o introduza
Como escapar texto não confiável para o DrawHTMLTextBox?
Escape conteúdo de texto não confiável para o PDFlibPas substituindo &, depois <, depois >, exatamente uma vez, e mantenha dados não confiáveis fora de valores de atributo de uma vez por todas. O helper abaixo é seu para adicionar; é código RTL puro:
uses
System.SysUtils, PDFlibrary;
// Helper seu (não faz parte da library): escapa texto não confiável
// para conteúdo de texto HTML do PDFlibPas. '&' precisa ser substituído primeiro,
// senão o ampersand dentro de um '<' recém-produzido é
// escapado uma segunda vez
function EscapeHTMLText(const S: string): string;
begin
Result := StringReplace(S, '&', '&', [rfReplaceAll]);
Result := StringReplace(Result, '<', '<', [rfReplaceAll]);
Result := StringReplace(Result, '>', '>', [rfReplaceAll]);
end;
procedure RenderTicket(const CustomerComment: string);
var
Lib: TPDFlib;
Html: WideString;
begin
Lib := TPDFlib.Create;
try
Lib.SetOrigin(1);
Lib.SetMeasurementUnits(0);
Html := '<p><b>Customer comment</b></p>' +
'<p>' + EscapeHTMLText(CustomerComment) + '</p>';
Lib.DrawHTMLText(50, 50, 495, Html);
Lib.SaveToFile('ticket.pdf');
finally
Lib.Free;
end;
end;Alimente-o com o comentário Try <a href="https://example.com">this</a> & <b> e a página mostra esses caracteres um a um. Sob um renderer que decodifica duas vezes, o mesmo input escapado vira uma link annotation viva. Esse é o passo de defeito cosmético para problema de segurança: um comentário de ticket nunca deveria poder plantar uma URL clicável num PDF que vai para o seu próprio pessoal
Repare no que o helper deixa em paz. Escapers de propósito geral também transformam " em " e ' em ', o que é certo para um browser e errado aqui — a decodificação de texto do PDFlibPas conhece só as quatro entidades listadas antes, então essas duas imprimiriam literalmente como " e '. Não reaproveite um escaper de browser para isso. Aspas são inofensivas em conteúdo de texto; elas só importam dentro de valores de atributo, e o renderer não decodifica entidades em atributos de forma nenhuma. Para atributos preferimos uma regra a um escaper mais esperto, porque nenhum esquema de escaping é conferido ali de qualquer jeito: mantenha valores de usuário fora de href, src e style. Se um link target realmente precisa vir de input de usuário, valide-o você mesmo contra uma allow-list de schemes e caracteres e rejeite qualquer coisa contendo aspas ou angle brackets
Dois hábitos seguem direto da decodificação single-pass:
- Sempre escape
&. Pule-o, e texto de usuário contendo<aparece como<— inofensivo, mas não o que o usuário digitou - Escape num único ponto. Texto que passa por dois escapers renderiza
<como a grafia visível<, então ache o único lugar em que os seus dados entram na string HTML e escape ali
Paginando com LeftOverText sem quebrar escapes
O DrawHTMLTextBox retorna o HTML que não coube, geralmente chamado de LeftOverText, e esse remainder mantém grafias literais de entidades e angle brackets escapados intactos quando entra na próxima box. Passe-o de volta exatamente como o recebeu
const
  BoxLeft = 50;
  BoxTop = 50;
  BoxWidth = 495;    // dimensionado para uma página A4 em points
  BoxHeight = 740;
  MaxPages = 500;    // cap de segurança seu

procedure RenderLongHTML(Lib: TPDFlib; const Html: WideString);
var
  Rest: WideString;
  Pages: Integer;
begin
  Lib.SetOrigin(1);
  Lib.SetMeasurementUnits(0);
  Rest := Lib.DrawHTMLTextBox(BoxLeft, BoxTop, BoxWidth, BoxHeight, Html);
  Pages := 1;
  while (Rest <> '') and (Pages < MaxPages) do
  begin
    Lib.NewPage;
    Inc(Pages);
    // O remainder já é HTML escapado: nunca escape nem desescape ele
    Rest := Lib.DrawHTMLTextBox(BoxLeft, BoxTop, BoxWidth, BoxHeight, Rest);
  end;
  if Rest <> '' then
    raise Exception.CreateFmt('Content still left after %d pages', [MaxPages]);
end;
Trate o remainder como opaco. Ele é HTML normalizado com styles já resolvidos sobre cada tag, então rodá-lo pelo seu próprio escaper transforma cada < em &lt;, e decodificá-lo entrega à próxima box tags vivas. Enxertar texto fresco de usuário nele tem os mesmos dois modos de falha. O cap de páginas custa uma comparação: se algum elemento nunca couber na box, um loop sem cap não tem saída natural
Markdown tem a própria continuação dele. O DrawMarkdownTextBox retorna um remainder que começa com um comentário marcador, que diz aos entry points Markdown para pular a conversão na chamada seguinte. Devolva-o ao DrawMarkdownTextBox ou ao DrawMarkdownText, do mesmo jeito que você devolveria um LeftOverText ao DrawHTMLTextBox. Um remainder Markdown pertence aos entry points Markdown, então mantenha-o desse lado e roteie só remainders do DrawHTMLTextBox pelas chamadas HTML
A forma por trás de tudo isso — parsear, escrever de volta na mesma sintaxe, parsear de novo — também aparece em template engines, HTML sanitizers e cadeias Markdown-to-HTML-to-PDF, e a falha vem em duas direções. Re-encoding de menos transforma dados em sintaxe. Encoding de mais, ou um decoder que roda duas vezes, mostra grafias de entidades ao reader ou as come. Remendar uma direção sozinha costuma quebrar a outra, e é por isso que o renderer do PDFlibPas trata a decodificação de &, decodificá-la por último, nenhum decode tardio e re-escaping em toda fronteira como um pacote único. A direção de export segue a mesma regra em export semântico PDF para Markdown e DOCX do Delphi, onde cada caractere literal é escapado para a sintaxe alvo exatamente uma vez
Desenho HTML e Markdown, o exporter de relatórios de dataset e o resto da layout engine vêm como fonte Pascal nativa no PDF Library for Delphi, tanto para Delphi quanto para Free Pascal. Edições, cobertura de plataformas e o download de avaliação estão listados na página do produto PDF Library for Delphi