Meio ponto decide. Em um relatório com texto de corpo de 10 pontos, um título de seção em negrito de 11 pontos converte para Markdown como um parágrafo comum, enquanto uma legenda de 12 pontos na capa, em peso normal, volta como ### Quarterly figures. Isso parece invertido até você lembrar o que uma página PDF realmente guarda: glifos em coordenadas, um nome de fonte e um tamanho. Nada na página diz "título". Todo título que um conversor emite é um palpite construído desses três fatos, e o palpite tem limiares
Por que uma página PDF não tem parágrafos para exportar
Uma página PDF contém operadores de exibição de texto, não parágrafos. Cada operador posiciona uma run de glifos em uma posição, na ordem em que a aplicação produtora resolveu emiti-los, e a ISO 32000-1 não impõe ao produtor obrigação alguma de dizer que duas runs pertencem à mesma frase, quanto mais ao mesmo item de lista ou célula de tabela. O formato descreve uma página impressa com exatidão, e chega lá jogando fora a estrutura que produziu a página
Então todo conversor reconstrói o que o gerador descartou. Linhas vêm de baselines compartilhadas e espaçamento vertical. Quebras de parágrafo vêm de mudanças de espaçamento e endentação. Uma lista é uma sequência de blocos que começam com um caractere de bullet ou um padrão numérico. Uma tabela é uma grade de blocos de texto cujas bordas se alinham entre linhas e colunas. Em documentos que seguem hábitos tipográficos comuns isso funciona bem; em um folheto diagramado para efeito visual tem muito pouco onde se agarrar
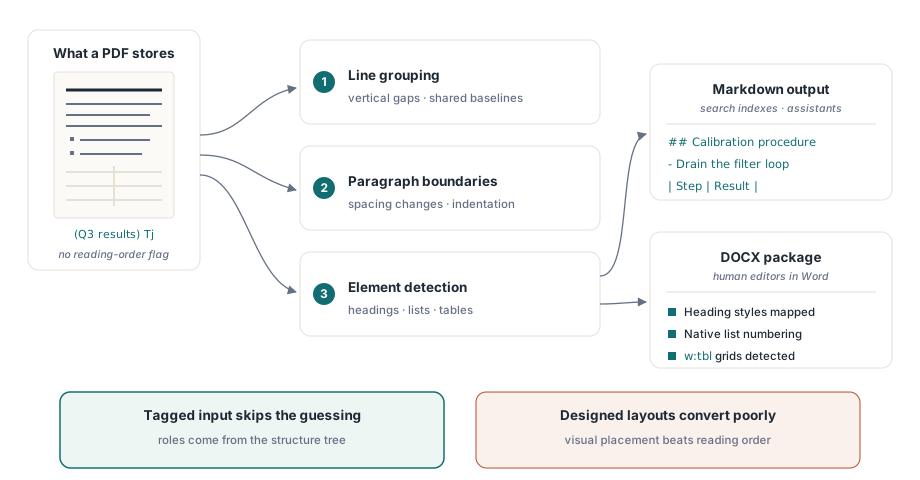
PDFs tagged são a grande exceção. Quando um documento carrega uma árvore de estrutura, os papéis de parágrafo, título, lista e tabela são gravados pelo produtor em vez de adivinhados depois, e é por isso que o trabalho descrito em estrutura de acessibilidade de PDF tagged também rende na qualidade de conversão. Se você controla o produtor, taggear a saída é a coisa mais barata que pode fazer por quem converter depois
De onde vêm os níveis de título
A PDF Library for Delphi decide os níveis de título de duas formas, dependendo da entrada. Em uma página tagged, um bloco cujo papel de estrutura é H1 a H6 mantém esse nível, e H ou Title vira nível 1. Em uma página sem tags a exportação cai para o tamanho de fonte relativo ao texto de corpo da página, e considera apenas parágrafos de linha única de 200 caracteres ou menos
A regra de tamanho precisa de uma razão e de uma diferença absoluta, medidas contra o tamanho de corpo dominante:
| Saída Markdown | Maior texto da linha | Com corpo de 10 pt |
|---|---|---|
# | pelo menos 1,6 vez o tamanho do corpo e pelo menos 4 pt maior | 16 pt e acima |
## | pelo menos 1,35 vez e pelo menos 2,5 pt maior | 13,5 pt e acima |
### | pelo menos 1,15 vez e pelo menos 1,25 pt maior | 11,5 pt e acima |
Isso explica o exemplo de abertura. Um título em negrito de 11 pontos sobre texto de 10 pontos perde o terceiro degrau por meio ponto, e o peso não tem papel algum no nível. A legenda da capa com 12 pontos passa. A diferença absoluta existe para corpos pequenos: em texto de corpo de 6 pontos, tamanho de nota de rodapé, uma razão sozinha promoveria uma linha de 7 pontos a título, e a exigência extra de 1,25 pt impede isso
Achamos que essa é a troca certa. Negrito é comum demais dentro de texto de corpo (frases de abertura, termos definidos, totais em uma linha de resumo) para ser um sinal confiável de título por si só, e um conversor que promove toda linha em negrito produz Markdown com dúzias de seções espúrias. Perder alguns títulos só-em-negrito custa menos. Se seus documentos dependem de títulos em negrito no tamanho do corpo, o conserto confiável é a montante: taggeie-os, ou aumente o tamanho do título em um ponto e meio
Negrito e itálico na saída são lidos do nome da fonte. Uma run cujo nome de fonte contém Bold, Black ou Demi vira **bold**; Italic ou Oblique vira *italic*. Produtores que fazem subset de fontes sob nomes opacos como F3, ou que falsificam negrito traçando glifos regulares, não dão nada para a exportação ler, e esse texto chega sem estilo
Exportação Markdown para pipelines de recuperação
A rota Markdown é a que se escolhe quando o destino é um pipeline de texto: um site de documentação, um índice de busca, um corpus fragmentado para um assistente. ExportPageMarkdown devolve uma página como WideString, ExportDocumentMarkdown devolve um intervalo de páginas, e SaveMarkdownToFile e SaveMarkdownToStream gravam o mesmo texto como UTF-8 sem byte-order mark. A ausência de BOM é deliberada; uma porção de geradores de site estático e ferramentas de diff a tratam como conteúdo
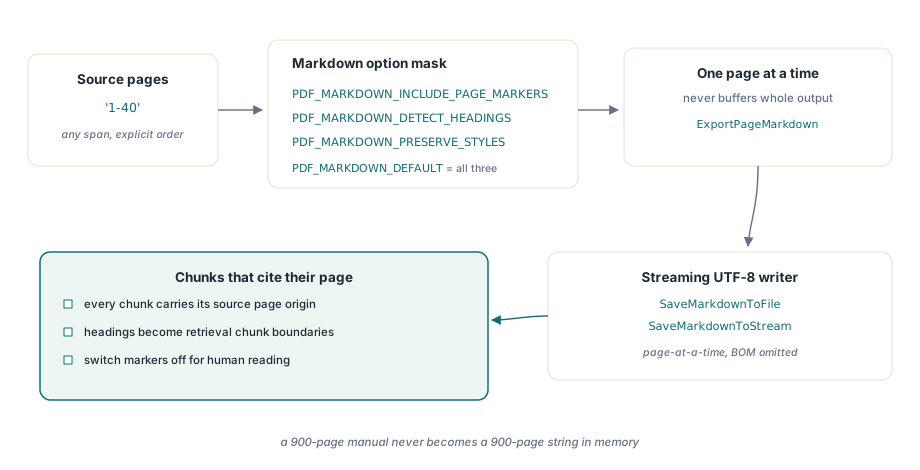
As opções são uma máscara de bits: PDF_MARKDOWN_INCLUDE_PAGE_MARKERS (1), PDF_MARKDOWN_DETECT_HEADINGS (2) e PDF_MARKDOWN_PRESERVE_STYLES (4), com PDF_MARKDOWN_DEFAULT combinando as três. Uma segunda configuração, no nível do documento, controla a análise em si: o SetStructuredTextOptions recebe as flags PDF_STRUCTURED_*, e seu padrão detecta colunas, detecta cabeçalhos e rodapés de repetição e junta tabelas que continuam através de uma quebra de página
uses
  SysUtils, PDFlibrary;

var
  Pdf: TPDFlib;
  Exported: Integer;
begin
  Pdf := TPDFlib.Create;
  try
    if Pdf.LoadFromFile('handbook.pdf', '') = 0 then
      raise Exception.Create('Cannot open handbook.pdf');

    // A detecção de cabeçalhos e rodapés de repetição vem ligada por padrão;
    // adicionar EXCLUDE_FURNITURE também os derruba da saída
    Pdf.SetStructuredTextOptions(PDF_STRUCTURED_ADVANCED_DEFAULT or
      PDF_STRUCTURED_EXCLUDE_FURNITURE);

    // Marcadores de página e títulos, mas sem ênfase ** e *
    Exported := Pdf.SaveMarkdownToFile('1-40',
      PDF_MARKDOWN_INCLUDE_PAGE_MARKERS or PDF_MARKDOWN_DETECT_HEADINGS,
      'handbook.md');
    if Exported = 0 then
      raise Exception.CreateFmt('Markdown export failed, error %d',
        [Pdf.LastErrorCode]);

    // JSON com uma entrada por página: readingSource é tagged, mixed,
    // geometric ou geometric-columns
    Writeln(Pdf.GetLastStructuredTextDiagnostics);
  finally
    Pdf.Free;
  end;
end;
Para um corpus de recuperação descartamos o PDF_MARKDOWN_PRESERVE_STYLES. A ênfase é aplicada run por run, então uma frase em negrito diagramada em várias runs sai como **Net** **revenue**, que lê bem na tela e adiciona ruído a cada embedding. Marcadores de página são o caso oposto: guarde-os. Cada marcador é um comentário HTML, <!-- page: 12 -->, invisível quando o Markdown é renderizado e trivial de parsear quando você divide chunks, então um trecho recuperado pode citar a página de onde veio. Quando uma tabela continua da página anterior, o marcador da página nova fica de fora para que a tabela de pipes continue em uma peça só
Dois comportamentos pegam quem exporta página por página em um loop. Primeiro, cabeçalhos de repetição são reconhecidos pela repetição: um parágrafo nos 12 por cento superiores ou inferiores da página conta como mobiliário quando texto correspondente senta na mesma banda em outra página da mesma exportação, com dígitos normalizados para que "Page 3 of 40" case com "Page 4 of 40". Uma chamada de página única não tem outra página para comparar, então um cabeçalho de repetição sem tags permanece no texto. Segundo, imagens no Markdown são embutidas inline como URIs data:, o que mantém o arquivo autossuficiente e significa que uma página com uma fotografia grande pode adicionar centenas de kilobytes de base64 ao arquivo. Se o seu chunker tem limite de tamanho, remova as linhas que começam com 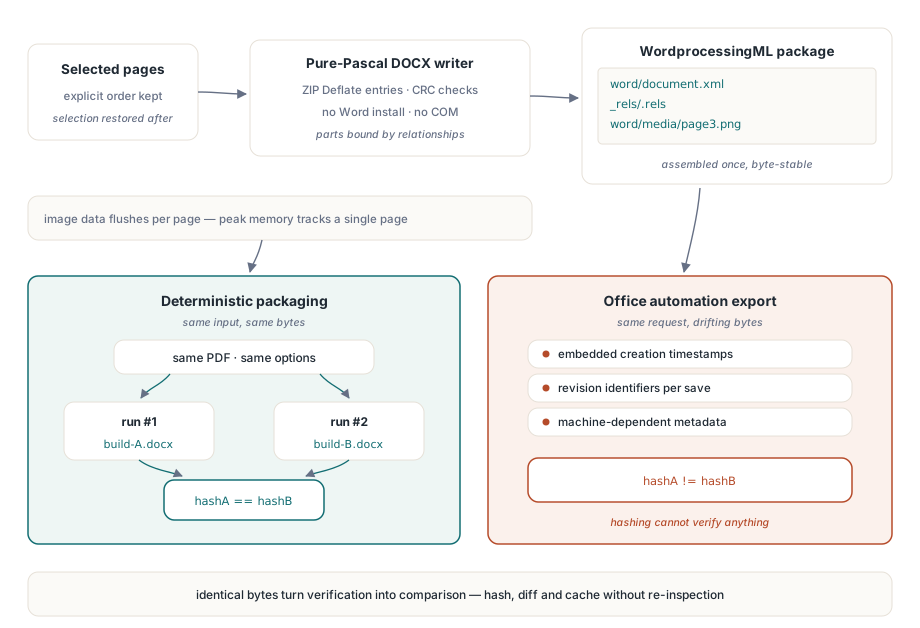
Duas escolhas fazem isso se sustentar. Toda entrada ZIP carrega a mesma data DOS fixa, 1º de janeiro de 1980, em vez da hora da execução, e a parte de propriedades core não tem datas de criação ou modificação. Cada entrada é comprimida com Deflate cru apenas quando isso realmente a torna menor, então mídia PNG, que já é comprimida, é armazenada como está. Você pode confirmar o primeiro ponto com unzip -v handbook.docx: toda linha mostra a mesma data
Automação do Office não pode te dar isso. Salvar pelo Word estampa a hora atual nos metadados do pacote e nos cabeçalhos do ZIP, então o mesmo documento convertido duas vezes difere de formas que derrotam um hash. O mesmo raciocínio está por trás dos identificadores de arquivo estáveis em IDs de PDF determinísticos para builds reprodutíveis: uma vez que a saída é reprodutível, a verificação vira uma comparação
Quais entradas convertem bem, e quais nunca vão
A qualidade da conversão varia mais com a entrada do que com o conversor, e vale avisar seus usuários disso de cara. PDFs tagged e documentos de negócio gerados limpos (faturas, relatórios, contratos) convertem bem: títulos caem como títulos, tabelas sobrevivem, listas renumeram no Word. Diagramações acadêmicas de duas colunas saem na ordem de leitura certa quando a geometria das colunas é regular, e os diagnósticos reportam geometric-columns para essas páginas. Tabelas que quebram entre páginas são rejugadas por inferência, então confira-as por amostragem. Material de marketing fortemente diagramado, onde o texto é posicionado por efeito em vez de em ordem de leitura, dá a qualquer conversor pouco a recuperar; espere retocar o resultado à mão
Documentos escaneados são um caso à parte. Uma página que é uma imagem grande não contém objetos de texto, então não há nada a exportar até existir uma camada de texto, e rodar OCR é pré-requisito para os dois formatos. Antes de se comprometer com um lote grande, amostre uma dúzia de arquivos representativos e enumere o que suas páginas contêm, como descrito em busca textual e enumeração de elementos de página; uma página com imagens e nenhuma run de texto te diz mais em um segundo do que ler a saída convertida dirá
Escolha o formato pelo que vem depois. Markdown serve a máquinas e pipelines: títulos viram fronteiras de chunks, tabelas permanecem legíveis como tabelas de pipes, e marcadores de página dão a cada chunk uma citação. DOCX serve a pessoas que precisam mudar o documento, porque o que elas querem de volta é um arquivo editável no Word, com listas e tabelas de verdade, e o texto sozinho não dá isso a elas
A PDF Library for Delphi vem para Delphi, C++Builder e Lazarus, com edições DLL e ActiveX que expõem as mesmas chamadas de exportação Markdown e DOCX a hosts C#, C++ e scripting. A referência de toda flag de opção e um download de avaliação estão na página do produto PDF Library for Delphi