40-stronicowy podręcznik użytkownika, którego pierwsza zakładka najwyższego poziomu celuje w stronę 5, a rozdzielacz tnący "od tej zakładki do następnej" zapisze pliki rozdziałów sumujące się do 36 stron. Okładka, strona praw autorskich i dwustronicowy spis treści siedzą przed każdym wpisem konspektu, więc nigdy nie lądują w żadnym pliku. Konspekt tylko zaznacza, gdzie zaczynają się sekcje. Nie pokrywa tego, co jest przed pierwszym wpisem, i nic w formacie nie wymaga, by wpisy były wypisane w kolejności stron, więc niezawodny rozdzielacz zbiera strony zakładek jako punkty cięcia, sortuje je i dokłada jawną strefę materiału wstępnego
Jedna pętla za każdym trybem podziału
PDFium Component dzieli dokument tymi samymi czterema krokami na drugim TPdf, cokolwiek rozstrzyga granice: CreateDocument startuje pusty PDF w pamięci, ImportPages kopiuje zakres stron ze źródła do niego, SaveAs zapisuje plik, a Active := False zamyka wyjście z powrotem. Podział strona po stronie, kawałki o stałym rozmiarze i sekcje po zakładkach różnią się wyłącznie stringiem zakresu podawanym do ImportPages
Reset na końcu każdego przebiegu nie jest opcjonalny. CreateDocument odmawia działania na komponencie, który jest nadal aktywny, i podnosi EPdfError o komunikacie zaczynającym się od "Cannot perform this operation on an active", więc druga iteracja pętli zapominającej Active := False stanie z wyjątkiem po dokładnie jednym zapisanym pliku. Reset w bloku finally chroni przed tym, że nieudany import albo zapis zostawi wyjście otwarte na następny przebieg. Jedna instancja TPdf obsługuje cały przebieg i tylko jeden dokument wyjściowy jest kiedykolwiek trzymany w pamięci
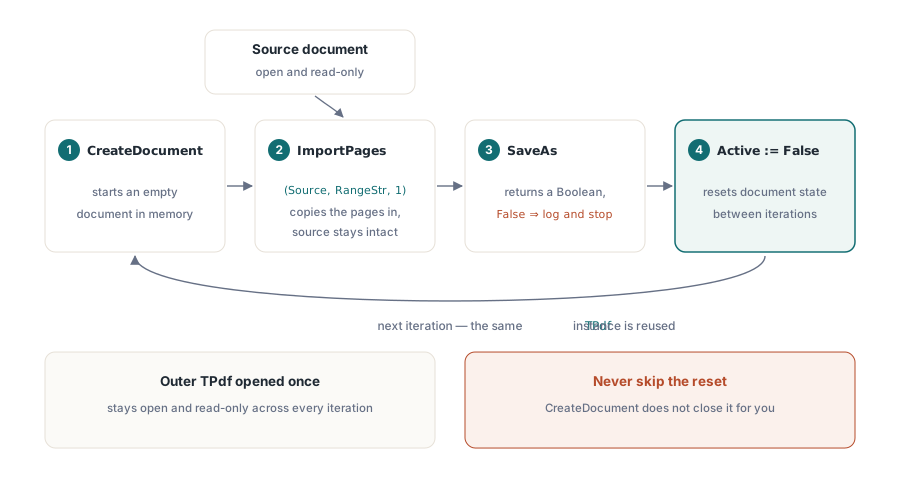
Otwarcie źródła zasługuje na własną kontrolę. Przypisanie Active := True nigdy nie rzuca: gdy plik jest brakujący, uszkodzony albo potrzebuje hasła, którego nie podano, TPdf łapie błąd ładowania i zostawia Active na False. ImportPages też próbuje aktywować źródło samodzielnie, co znaczy, że nieotwarte źródło pokazuje się wyłącznie jako zwrócone False na pierwszej stronie i nie daje wskazówki o przyczynie. Jawne otwarcie i test Active zamienia to w błąd nazywający plik, zanim jakiekolwiek wyjście istnieje:
procedure SplitIntoPages(const SourceFile, OutputDir: string);
var
  Source, PdfOut: TPdf;
  I: Integer;
  OutFile: string;
begin
  Source := TPdf.Create(nil);
  PdfOut := TPdf.Create(nil);
  try
    Source.FileName := SourceFile;
    Source.Active := True;               // niepowodzenie ładowania zostawia Active = False
    if not Source.Active then
      raise Exception.Create('Cannot open ' + SourceFile);

    for I := 1 to Source.PageCount do
    begin
      PdfOut.CreateDocument;             // rzuca, póki PdfOut jest nadal aktywny
      try
        // Zakres numeruje od 1; pozycja 1 to start pustego dokumentu
        if not PdfOut.ImportPages(Source, IntToStr(I), 1) then
          raise Exception.CreateFmt('Cannot import page %d', [I]);
        OutFile := IncludeTrailingPathDelimiter(OutputDir) +
          Format('page_%.4d.pdf', [I]);
        if not PdfOut.SaveAs(OutFile) then
          raise Exception.Create('Cannot save ' + OutFile);
      finally
        PdfOut.Active := False;          // zamknij wyjście przed następnym przebiegiem
      end;
    end;
  finally
    PdfOut.Free;
    Source.Free;
  end;
end;
Trzeci argument ImportPages to pozycja liczona od 1 w dokumencie docelowym, gdzie ląduje pierwsza importowana strona. W pustym dokumencie 1 to jedyna pozycja, jaka jest. Sama składnia zakresu (pojedyncze strony, domknięte przedziały jak '5-10', listy po przecinku) i pomyłki pozycji odwracające scaloną paczkę opisuje scalanie wielu plików PDF w jeden dokument, czyli to samo API skierowane w drugą stronę
Kawałki o stałym rozmiarze i zakresy od wołającego
Cięcie dokumentu co N stron to problem liczenia i jedyny przypadek wymagający uwagi to ogon. Skan 230 stron podzielony na części po 25 stron daje dziewięć pełnych części i dziesiątą z pięciu stron, więc koniec każdego przedziału jest zaciśkany do Source.PageCount:
procedure SplitEvery(Source: TPdf; ChunkSize: Integer; const OutputDir: string);
var
  PdfOut: TPdf;
  FirstPage, LastPage, Part: Integer;
  Range, OutFile: string;
begin
  if ChunkSize < 1 then
    raise Exception.Create('ChunkSize must be at least 1');
  PdfOut := TPdf.Create(nil);
  try
    Part := 0;
    FirstPage := 1;
    while FirstPage <= Source.PageCount do
    begin
      LastPage := FirstPage + ChunkSize - 1;
      if LastPage > Source.PageCount then
        LastPage := Source.PageCount;    // ostatnia część jest zwykle krótsza
      if FirstPage = LastPage then
        Range := IntToStr(FirstPage)     // jednostronicowy ogon jako goła liczba
      else
        Range := Format('%d-%d', [FirstPage, LastPage]);
      Inc(Part);

      PdfOut.CreateDocument;
      try
        if not PdfOut.ImportPages(Source, Range, 1) then
          raise Exception.Create('Cannot import pages ' + Range);
        OutFile := IncludeTrailingPathDelimiter(OutputDir) +
          Format('part_%.3d.pdf', [Part]);
        if not PdfOut.SaveAs(OutFile) then
          raise Exception.Create('Cannot save ' + OutFile);
      finally
        PdfOut.Active := False;
      end;
      FirstPage := LastPage + 1;
    end;
  finally
    PdfOut.Free;
  end;
end;
Zakresy wpisane przez użytkownika to inna sprawa. ImportPages raportuje zły zakres przez wartość zwracaną: numer strony poza Source.PageCount, zero, odwrócony przedział albo tekst, który nie parsuje się, każe wywołaniu zwrócić False i żadna ze stron tamtego stringa nie jest kopiowana. Wewnątrz pętli ta awaria przychodzi na czwartym wpisie, gdy trzy pliki sekcji już leżą na dysku. Sprawdzanie każdego wpisu wobec Source.PageCount przed pierwszym CreateDocument kosztuje kilka linii parsowania i znaczy, że literówka we wpisie czwartym nie zapisze niczego — zachowanie, którego oczekuje człowiek ponawiający zadanie
Gdy wybór już mieszka w tablicy liczb całkowitych, na przykład strony wybrane w widoku miniatur, ImportPagesByIndex(Source, PageIndices, InsertAt) pomija krok ze stringiem. Zarówno indeksy, jak i InsertAt są tam liczone od zera, więc ten sam wybór, który czyta się jako zakres '1,3-5', staje się [0, 2, 3, 4]
Dlaczego sekcje po zakładkach wychodzą krótkie albo ich brak?
Sekcje po zakładkach psują się, gdy kod ufa, że konspekt jest ogarnięty. TPdf.Bookmarks zwraca wpisy najwyższego poziomu w kolejności ułożonej przez autora, każdy jako rekord TBookmark z Title i PageNumber liczonym od 1. Cztery rzeczy w prawdziwych plikach łamią naiwną regułę "od tego wpisu do następnego":
- Wpis konspektu może nieść cel jako wpis
/Destalbo jako akcja GoTo w/A(ISO 32000-1 §12.3.3 i §12.6.4.2).PageNumberjest wypełniane z/Dest; dla wpisu opartego na akcji zostaje0, a strona siedzi wActionPageNumber - Kolejność konspektu to kolejność czytania taka, jaką widział autor. Wpis "Indeks" postawiony jako drugi albo dodatek wypisany przed rozdziałami czyni "następna zakładka minus jeden" mniejszym od bieżącego startu i ta sekcja znika
- Dwa wpisy najwyższego poziomu mogą celować w tę samą stronę, typowo tytuł części i jej pierwszy rozdział
- Wpis może celować poza ostatnią stronę, gdy strony usunięto narzędziem, które zostawiło konspekt w spokoju
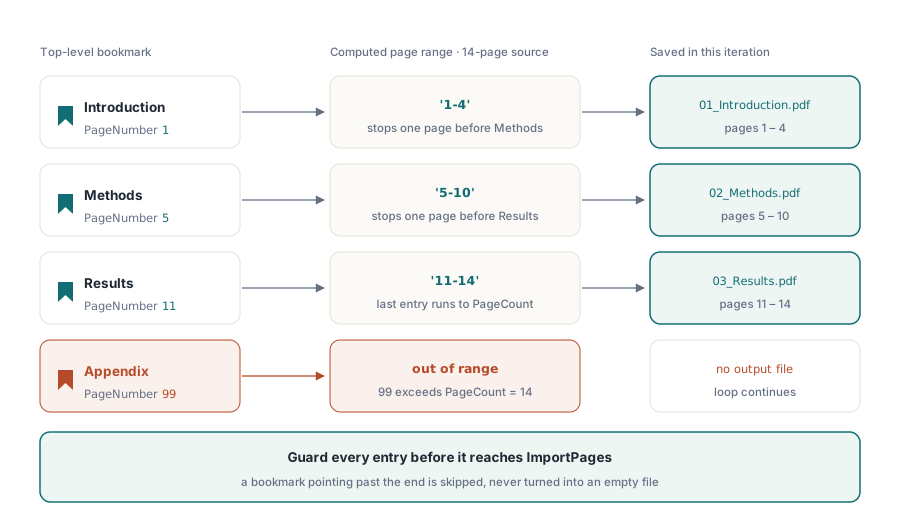
Wersja niżej traktuje konspekt jako źródło punktów cięcia. Rozwiązuje stronę każdego wpisu, wyrzuca wpisy celujące nigdzie albo za końcem, trzyma pierwszy tytuł na współdzielonej stronie, sortuje po numerze strony i dokłada sekcję "Front matter", gdy pierwszy punkt cięcia wypada po stronie 1. Materiał wstępny dostaje tu własny plik zamiast być doklejonym do rozdziału 1, bo człowiek otrzymujący rozdział 1 oczekuje, że otworzy się on na stronie nazwanej przez zakładkę, nie na spisie treści
procedure SplitByBookmarks(Source: TPdf; const OutputDir: string);
var
  Bm: TBookmarks;
  Starts: array of Integer;
  Titles: array of string;
  I, J, K, N, P, EndPage: Integer;
  Known: Boolean;
  PdfOut: TPdf;
  OutFile: string;
begin
  Bm := Source.Bookmarks;                // tylko wpisy najwyższego poziomu
  if Length(Bm) = 0 then
    Exit;                                // brak punktów cięcia
  SetLength(Starts, Length(Bm) + 1);     // +1 zostawia miejsce na materiał wstępny
  SetLength(Titles, Length(Bm) + 1);
  N := 0;
  for I := 0 to High(Bm) do
  begin
    P := Bm[I].PageNumber;               // rozwiązane z /Dest
    if P < 1 then
      P := Bm[I].ActionPageNumber;       // rozwiązane z akcji GoTo w /A
    if (P < 1) or (P > Source.PageCount) then
      Continue;                          // nierozwiązane albo za ostatnią stroną
    Known := False;
    for J := 0 to N - 1 do
      if Starts[J] = P then
        Known := True;                   // pierwszy tytuł na stronie wygrywa
    if Known then
      Continue;
    J := N;                              // sortowanie przez wstawianie po numerze strony
    while (J > 0) and (Starts[J - 1] > P) do
    begin
      Starts[J] := Starts[J - 1];
      Titles[J] := Titles[J - 1];
      Dec(J);
    end;
    Starts[J] := P;
    Titles[J] := Bm[I].Title;
    Inc(N);
  end;
  if N = 0 then
    Exit;
  if Starts[0] > 1 then                  // okładka, spis treści i wszystko przed nimi
  begin
    for J := N downto 1 do
    begin
      Starts[J] := Starts[J - 1];
      Titles[J] := Titles[J - 1];
    end;
    Starts[0] := 1;
    Titles[0] := 'Front matter';
    Inc(N);
  end;

  PdfOut := TPdf.Create(nil);
  try
    for K := 0 to N - 1 do
    begin
      if K < N - 1 then
        EndPage := Starts[K + 1] - 1
      else
        EndPage := Source.PageCount;
      PdfOut.CreateDocument;
      try
        if not PdfOut.ImportPages(Source,
          Format('%d-%d', [Starts[K], EndPage]), 1) then
          raise Exception.CreateFmt('Cannot import pages %d-%d',
            [Starts[K], EndPage]);
        // Zadeklaruj SafeFileName (pokazany niżej) przed tą rutyną
        OutFile := IncludeTrailingPathDelimiter(OutputDir) +
          Format('%.2d_%s.pdf', [K + 1, SafeFileName(Titles[K])]);
        if not PdfOut.SaveAs(OutFile) then
          raise Exception.Create('Cannot save ' + OutFile);
      finally
        PdfOut.Active := False;
      end;
    end;
  finally
    PdfOut.Free;
  end;
end;
Bo starty po sortowaniu są ściśle rosnące, każdy wyliczony przedział jest poprawny i straż na ImportPages nigdy nie powinna odpalić na czytelnym źródle. Dokument bez zakładek po prostu nie produkuje w tym trybie żadnych plików; wołający rozstrzyga, czy to spada z powrotem na cięcie co N. Żeby ciąć poziom głębiej, na przykład po rozdziałach wewnątrz części, BookmarkChildren[Bm[I]] zwraca dzieci wpisu najwyższego poziomu w tej samej formie TBookmarks i ta sama logika punktów cięcia dotyczy listy połączonej
Co niesie każdy plik wyjściowy
Każdy plik wyjściowy niesie same strony i wszystko, do czego referują ich słowniki stron: strumienie treści, czcionki, obrazy i listę adnotacji każdej strony. Widgety formularzy przychodzą jako adnotacje, ale nowy plik nie ma AcroForm, więc nie są już działającymi polami. Źródło jest wyłącznie czytane. ImportPages kopiuje obiekty do nowego dokumentu i zostawia otwarte źródło nietknięte, więc ta sama instancja Source karmi każdą iterację
Konspekt zostaje z tyłu. Zakładki mieszkają w katalogu dokumentu pod /Outlines (ISO 32000-1 §7.7.2), poza jakąkolwiek stroną, więc plik zbudowany z importowanych stron startuje bez zakładek w ogóle. Dla plików rozdziałów to często w porządku. Gdy każda część potrzebuje własnej nawigacji, konspekt trzeba zbudować pod nowe numerowanie stron, czym jest edycja konspektu PDF i przemapywanie jego stron. Wewnętrzne łącza zachowują się tak samo: łącze "patrz rozdział 7" na stronie 12 celuje w stronę, która trafiła do innego pliku i w tym pliku nie ma na czym lądować
Zaszyfrowane źródła potrzebują hasła, zanim pętla się zacznie. Przypisz Source.Password, póki komponent jest nieaktywny, potem ustaw Active := True; przy złym haśle komponent zostaje nieaktywny, co kontrola w SplitIntoPages zamienia w błąd. Wyjście zapisane przez SaveAs to nowy dokument bez słownika szyfrowania. To pasuje plikom podziału przeznaczonym różnym odbiorcom, a gdy każda część ma być chroniona ponownie, SaveAsEncrypted(FileName, Options) bierze rekord TPdfEncryptOptions z własnymi hasłami użytkownika i właściciela
Nazwy plików, nieudane zapisy i ponowne przebiegi
Tytuły zakładek to tekstowe stringi PDF i mogą zawierać cokolwiek, włącznie ze znakami, które Windows odrzuca w nazwach plików. Reguły pochodzą z systemu plików, nie z PDF: < > : " / \ | ? * i znaki kontrolne są nieważne, końcowe spacje i kropki są ścinane przez API plików Win32, a nazwy jak CON, PRN albo COM1 to zarezerwowane urządzenia. Numerowany prefiks w SplitByBookmarks już załatwia nazwy urządzeń, trzyma pliki w kolejności czytania w listingu katalogu i blokuje nadpisanie się dwóch rozdziałów oba zatytułowanych "Summary". Reszta to mała funkcja, którą piszesz sam:
// Pomocnik strony czytelnika, nie część PDFium Component
function SafeFileName(const Title: string): string;
const
  Forbidden = '<>:"/\|?*';
var
  I: Integer;
begin
  Result := Title;
  if Length(Result) > 80 then
    SetLength(Result, 80);               // trzymaj pełne ścieżki daleko pod MAX_PATH
  for I := 1 to Length(Result) do
    if (Ord(Result[I]) < 32) or (Pos(Result[I], Forbidden) > 0) then
      Result[I] := '_';
  while (Result <> '') and
    ((Result[Length(Result)] = '.') or (Result[Length(Result)] = ' ')) do
    SetLength(Result, Length(Result) - 1);
  if Result = '' then
    Result := 'section';
end;
SaveAs z nazwą pliku zapisuje do pliku tymczasowego w folderze docelowym i podmienia go na miejsce dopiero po udanym zapisie. Cel jest więc albo poprzednim plikiem, albo kompletnym nowym, nigdy wpół zapisanym, więc ponowne przepuszczenie podziału przez istniejący folder wyjściowy jest nieszkodliwe. Niepowodzenia wracają dwoma drogami. SaveAs zwraca False, gdy dokumentu nie da się serializować, a plik tymczasowy jest usuwany. Problemy w systemie plików — folder wyjściowy, który nie istnieje, ścieżka odrzucona przez system operacyjny albo cel zablokowany przez podgląd — podnoszą wyjątek z warstwy plików
Reakcja batcha na te niepowodzenia to wybór i przy dzieleniu różni się od scalania. Scalana paczka z brakującą częścią to zły dokument, więc zatrzymanie jest tam poprawne. Wyjścia podziału są od siebie niezależne: jeśli section_147.pdf nie da się zapisać, bo kolega ma go otwartego, pozostałe sekcje są nadal dobre. Dla zadań podziału łap wyjątki per plik wewnątrz pętli, notuj nazwę pliku i komunikat, jedź dalej, a po zamknięciu pętli porównaj liczbę zapisanych plików z liczbą zaplanowanych zakresów. Przykłady wyżej rzucają przy pierwszym niepowodzeniu wyłącznie dla zwięzłości. Log mówiący "199 z 200 plików zapisanych" i nazywający ten zablokowany naprawia się jednym ponownym przebiegiem, podczas gdy przebieg przerwany na pliku 147 zostawia kogoś nad wyliczaniem, których 53 plików brakuje
Pętla podziału, rekordy zakładek i szyfrowany zapis użyte tutaj przychodzą z PDFium Component, biblioteki PDF na bazie PDFium dla Delphi i C++Builder