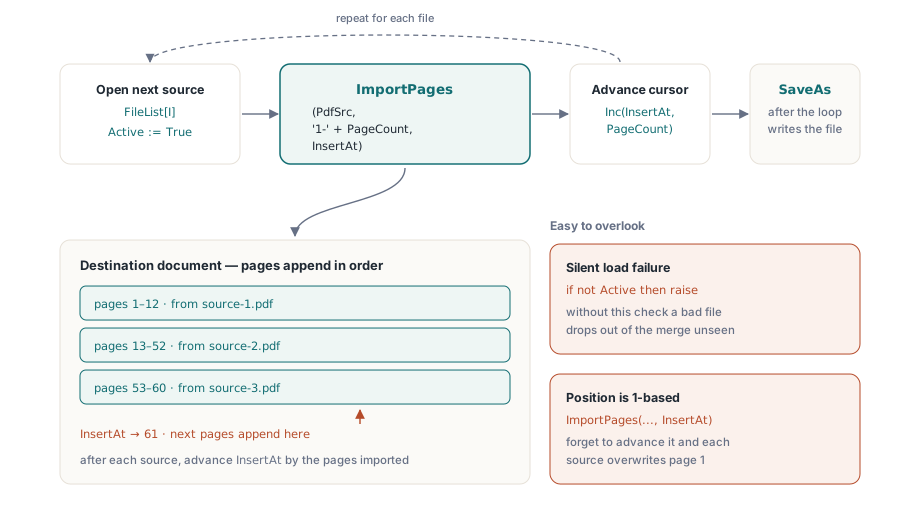
Pętla łącząca, która przekazuje 1 jako pozycję wstawienia przy każdym wywołaniu, wytwarza plik o właściwej liczbie stron i dokumentach w odwrotnej kolejności. Ostatni plik z listy ląduje na stronie 1, bo pozycja 1 znaczy „wstaw przed obecną pierwszą stroną”, a każde nowe źródło przepycha wcześniejsze dalej w tył. Nic nie ginie, i dokładnie dlatego błąd przeżywa szybkie sprawdzenie liczby stron, a wychodzi na jaw, gdy ktoś faktycznie przeczyta paczkę
Pętla strona po stronie z ImportPages
PDFium Component buduje scalony PDF w Delphi z dwóch instancji TPdf: jednego celu tworzonego pustym przez CreateDocument i jednego źródła, które po kolei otwiera każdy plik wejściowy. TPdf.ImportPages(Pdf, Range, PageNumber) kopiuje strony nazwane w Range z Pdf do celu i zwraca True przy sukcesie. PageNumber jest liczone od jedynki i domyślnie wynosi 1. Nazywa pozycję w celu, gdzie ląduje pierwsza importowana strona, więc 1 dokłada z przodu, a PageCount + 1 dokłada na końcu
Najczystszy sposób, by trzymać pliki w kolejności listy, to w ogóle przestać śledzić kursor i zapytać cel, gdzie jest jego koniec. Biegnący licznik InsertAt też działa, ale musi być pchany o liczbę stron faktycznie zaimportowanych, a tę liczbę łatwo zgubić, gdy w grę wchodzą zakresy. PdfDest.PageCount + 1 jest zawsze właściwe:
procedure MergeFileList(const FileList: TStrings; const OutputPath: string);
var
  PdfDest, PdfSrc: TPdf;
  I: Integer;
begin
  PdfDest := TPdf.Create(nil);
  PdfSrc  := TPdf.Create(nil);
  try
    PdfDest.CreateDocument;
    for I := 0 to FileList.Count - 1 do
    begin
      PdfSrc.FileName := FileList[I];
      PdfSrc.Active   := True;            // nie podnosi przy porażce
      if not PdfSrc.Active then
        raise Exception.CreateFmt('Cannot open %s', [FileList[I]]);

      // pozycja od 1: PageCount + 1 dokłada po ostatniej stronie
      if not PdfDest.ImportPages(PdfSrc,
        '1-' + IntToStr(PdfSrc.PageCount), PdfDest.PageCount + 1) then
        raise Exception.CreateFmt('Page import failed for %s', [FileList[I]]);

      PdfSrc.Active := False;             // FileName zmienia się tylko gdy nieaktywne
    end;

    if not PdfDest.SaveAs(OutputPath) then
      raise Exception.Create('Cannot write ' + OutputPath);
  finally
    PdfSrc.Free;
    PdfDest.Free;
  end;
end;
Dwa sprawdzenia w tej pętli niosą realną wagę. Ustawienie Active := True nigdy nie podnosi: jeśli pliku brakuje, jest uszkodzony albo potrzebuje hasła, TPdf łapie błąd wczytania i zostawia Active na False. Komponent zostaje w spójnym stanie zamkniętym, a formularz nie kładzie się na złym pliku. Pętla łącząca, która pomija to sprawdzenie, po prostu wytwarza krótsze wyjście. Drugim sprawdzeniem jest wynik Boolean ImportPages, który wraca jako False, gdy ciąg zakresu się nie parsuje albo pozycja leży poza PageCount + 1. Zauważ też, że FileName i Password da się przypisać tylko, gdy komponent jest nieaktywny, dlatego źródło jest zamykane na dole każdego przebiegu
Ciągi zakresu: co akceptuje parser
Argument zakresu to lista pojedynczych stron i zamkniętych rozpiętości oddzielona przecinkami, numerowana od 1 w dokumencie źródłowym. '1-3' bierze pierwsze trzy strony, '2,4,6' bierze trzy konkretne, a '1,3-5' bierze okładkę plus trójstronicowe podsumowanie. Liczby zawsze odnoszą się do źródła; gdzie te strony lądują w celu, rozstrzyga tylko argument pozycji
Rozpiętości bez końca to miejsce, gdzie ludzie się przewracają. Ciąg taki jak '7-' wygląda jak „strona 7 do końca”, ale parser zakresów PDFium wymaga obu końców rozpiętości i odrzuca cały ciąg. To samo dzieje się z odwróconą rozpiętością ('5-3'), numerem strony 0 albo dowolną stroną poza liczbą stron źródła. Jeden zły element zawodzi całe wywołanie: ImportPages zwraca False i żadna strona z tego ciągu nie jest kopiowana. Dlatego pętla wyżej buduje '1-' + IntToStr(PdfSrc.PageCount), zamiast pisać '1-'
Gdy masz już indeksy stron w tablicy, ImportPagesByIndex(Source, PageIndices, InsertAt) pomija krok z ciągiem. Uważaj jednak na zmianę konwencji: i indeksy, i InsertAt są tam liczone od zera, więc dokładanie na końcu to InsertAt = PdfDest.PageCount, a wybór okładka-plus-podsumowanie staje się [0, 2, 3, 4]. Przekazanie pustej tablicy importuje każdą stronę
Czy jest scalenie jednym wywołaniem dla listy plików?
Tak. TPdf.MergeFiles(Sources, Options, Report) bierze tablicę rekordów TPdfBatchMergeSource, każdy zbudowany przez TPdfBatchMergeSource.FromFile(FileName, PageRange, Password), otwiera je pojedynczo i wypełnia TPdfBatchMergeReport tym, co się wydarzyło. Pusty PageRange znaczy każdą stronę. Składnia zakresu to ten sam format przecinków i rozpiętości, a zniekształcony zakres staje się błędem per plik w raporcie, zamiast cichego pominięcia
Warto znać domyślne z TPdfBatchMergeOptions.Default, zanim cokolwiek zmienisz. CreateDestination jest True, więc nieaktywny cel zostanie utworzony za ciebie. InsertAt to -1, znaczy dokładaj na końcu; każda inna wartość to indeks liczony od zera, zgodny z ImportPagesByIndex, a nie z ImportPages. ErrorPolicy to bmepStop, a RollbackOnCancelOrFailure to True, więc jeden nieczytelny plik kończy przebieg i usuwa każdą stronę, którą przebieg dodał. CopyViewerPreferences kopiuje preferencje przeglądarki pierwszego źródła, które zaimportuje się z powodzeniem
procedure BuildBundle(const OutputPath: string; Log: TStrings);
var
  Dest: TPdf;
  Sources: TPdfBatchMergeSources;
  Options: TPdfBatchMergeOptions;
  Report: TPdfBatchMergeReport;
  I: Integer;
begin
  SetLength(Sources, 3);
  Sources[0] := TPdfBatchMergeSource.FromFile('cover.pdf');
  Sources[1] := TPdfBatchMergeSource.FromFile('annual-report.pdf', '1,3-5');
  Sources[2] := TPdfBatchMergeSource.FromFile('appendix.pdf', '', 'user-password');

  Options := TPdfBatchMergeOptions.Default;
  Options.ErrorPolicy := bmepSkip;        // idź dalej przez nieczytelne pliki

  Dest := TPdf.Create(nil);               // nieaktywny: MergeFiles go utworzy
  try
    if not Dest.MergeFiles(Sources, Options, Report) then
      raise Exception.Create('Merge failed: ' + Report.ErrorMessage);

    for I := 0 to High(Report.Issues) do
      Log.Add(Format('%s: %s',
        [Report.Issues[I].FileName, Report.Issues[I].MessageText]));
    Log.Add(Format('%d pages from %d of %d files',
      [Report.ImportedPageCount, Report.ImportedSourceCount, Report.SourceCount]));

    Dest.SaveAs(OutputPath);
  finally
    Dest.Free;
  end;
end;
Która polityka błędów zależy od tego, co brakujący plik znaczy dla wyjścia. Dla paczki umowy albo przebiegu faktur paczka bez jednej ze swoich części to zły dokument: trzymaj domyślne bmepStop z rollbackiem. Przełącz na bmepSkip tylko dla kolekcji „na najlepsze starania”, jak tygodniowy zbiór raportów, i wtedy traktuj bmrsCompletedWithErrors w Report.Status jako coś, na co człowiek musi patrzeć. Cokolwiek wybierzesz, czytaj Report.Issues: każdy wpis niesie indeks źródła, nazwę pliku i komunikat, co odpowiada na pytanie „który plik był winny”, na które ręcznie pisana pętla musi odpowiadać własnymi wyjątkami
Dwie kolejne opcje mają znaczenie dla długich przebiegów. OnProgress i CancellationToken pozwalają interfejsowi pokazać bieżący plik i zatrzymać przebieg, a anulowany przebieg jest wycofywany jak nieudany. ResourcePolicy domyślnie to bmrpSourceScoped, które importuje wybrane strony każdego źródła jednym natywnym wywołaniem, więc czcionki i obrazy współdzielone przez te strony są kopiowane raz. bmrpChunked importuje w porcjach po PageChunkSize stron, co daje dokładniejsze punkty anulowania w cenie ponownego kopiowania współdzielonych zasobów dla każdej porcji
Co niesie importowana strona i co zostaje w źródle
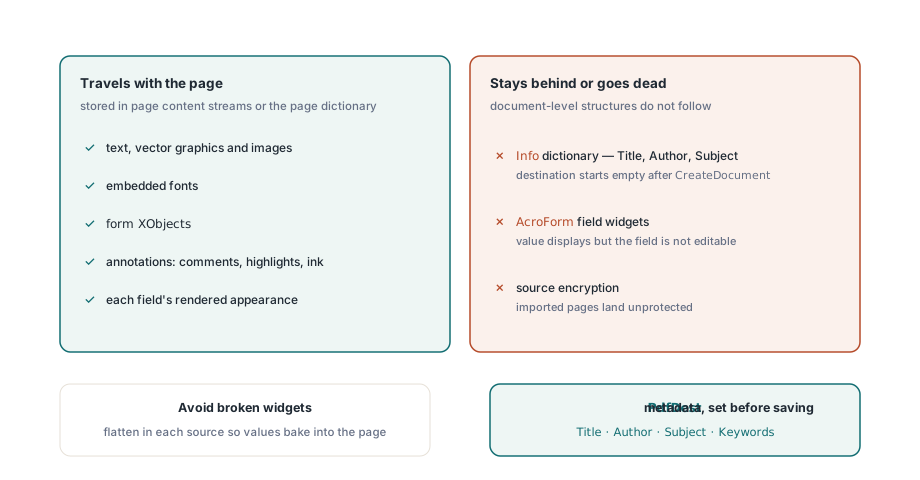
Importowana strona przynosi wszystko osiągalne ze swojego słownika strony: strumień treści, czcionki, obrazy i formularzowe XObjecty w swoich zasobach oraz swoje adnotacje, w tym komentarze, wyróżnienia i pociągnięcia odręczne. Cokolwiek mieszka na poziomie dokumentu w źródle, nie przychodzi razem, bo ISO 32000-1 trzyma to poza drzewem stron
- Słownik informacji o dokumencie (ISO 32000-1 §14.3.3) zostaje z tyłu, więc scalony plik nie ma żadnych Title, Author ani Keywords źródeł. Właściwości
TitleiAuthornaTPdfsą tylko do odczytu, co czyni je wygodnymi do logowania tego, co każde źródło zadeklarowało, zanim je zamkniesz - Zakładki (§12.3.3) są porzucane przy domyślnym
OutlinePolicyrównymbmopDiscard;bmopRejectzamienia źródło z zakładkami w błąd per plik. Żeby zachować zakładki, jednostkaFPdfMergedodajeMergeFilesWithNavigation, które przebudowuje zakładki, przemianowuje kolidujące nazwane miejsca docelowe domyślnie prefiksemImported_i przemapowuje łącza między stronami; artykuł o edycji zakładek i przemapowaniu stron opisuje, jak te miejsca docelowe są przepisywane - Szyfrowanie (§7.6) należy do pliku źródłowego. Chronione źródło otwiera się ze swoim
Password, ale cel utworzony przezCreateDocumentjest niezaszyfrowany, i strony skopiowane do niego też. Jeśli scalony plik musi być chroniony, zapisz go przezSaveAsEncryptedzamiastSaveAs
Dlaczego pola formularzy przestają działać po scaleniu?
Pola formularzy są rozcięte na dwa poziomy PDF. Widżetowa adnotacja, która rysuje pole tekstowe, siedzi na stronie, podczas gdy samo pole, ze swoją nazwą i wartością, jest wypisane w tablicy /Fields interaktywnego słownika formularza katalogu (ISO 32000-1 §12.7.2). Natywny import strony kopiuje widżet razem z innymi adnotacjami strony, ale nic nie dodaje go do drzewa pól celu. Pudełko nadal rysuje swój ostatni wygląd. Przeglądarka, która buduje swój model formularzy z /AcroForm, nie ma jednak pola, do którego można przyczepić widżet, więc wartości nie da się edytować i każda operacja formularzowa przechodząca drzewo pól ją pomija
TPdfBatchMergeOptions.FormPolicy daje trzy odpowiedzi dla zwykłego scalenia. bmfpPreserveNative, domyślne, zachowuje natywny wynik importu opisany wyżej. bmfpFlatten generuje wyglądy i spłaszcza wybrane strony każdego źródła niosącego formularz w pamięci przed ich importem, więc wartości stają się zwykłą treścią strony; plik źródłowy na dysku nie jest modyfikowany. bmfpReject zamienia każde źródło z formularzem AcroForm albo XFA w błąd per plik
Gdy pola muszą zostać wypełnialne, użyj MergeFilesWithForms z jednostki FPdfFormMerge. Importuje treść strony, przebudowuje widżety z drzewa pól każdego źródła i przeszczepia te pola do formularza celu. Nazwy pól to twarda część. Podług §12.7.3.2 dwa pola z tą samą w pełni kwalifikowaną nazwą to to samo pole i dzielą jedną wartość, więc pole Total na fakturze i pole Total na liście przewozowej nadpisałyby się nawzajem. Domyślne CollisionPolicy to pagcpReject, które stawia scalenie przy pierwszej kolizji:
uses
  PDFium, FPdfCompress, FPdfFormMerge;

procedure MergeFillableForms(Dest: TPdf;
  const Sources: TPdfBatchMergeSources; Log: TStrings);
var
  Options: TPdfFormMergeOptions;
  Report: TPdfFormMergeReport;
begin
  Options := TPdfFormMergeOptions.Default;
  // Kolidujące nazwy dostają RenamePrefix ('Imported_', chyba że zmienisz)
  Options.GraftOptions.CollisionPolicy := pagcpRename;

  if Dest.MergeFilesWithForms(Sources, Options, Report) then
    Log.Add(Format('%d fields grafted, %d renamed',
      [Report.GraftedFieldCount, Report.RenamedFieldCount]))
  else
    Log.Add('Form merge failed: ' + Report.ErrorMessage);
end;
pagcpNamespace wkłada zamiast tego pola każdego źródła pod jego własny prefiks (Imported plus numer źródła), a pagcpMergeCompatible łączy pola o tej samej nazwie tylko wtedy, gdy ich typy i opcje się zgadzają. MergeFilesWithForms działa na źródłach i celach AcroForm bez pól podpisów. Odmawia formularzy XFA i podpisanych plików kategorycznie, bo przepisanie podpisanego pliku unieważnia podpisany zakres bajtów opisany w ISO 32000-1 §12.8.1. Otwarty cel musi być też niezaszyfrowany: scalanie do pliku chronionego hasłem zawodzi, więc dodaj ochronę później przez SaveAsEncrypted. Strona wybrana dwa razy w jednym źródle, jak w '1,1', potrzebuje jawnego RepeatedPagePolicy
Dokument celu jest podmieniany dopiero po tym, jak odstawiony wynik został ponownie otwarty i sprawdzony. Nazwy pól, wartości i typy są porównywane strona po stronie, a nieudane scalenie formularzy zostawia Dest takim, jakim było. Artykuł o przeszczepie AcroForm schodzi głębiej w obsługę kolizji
Zapisywanie scalonego dokumentu
SaveAs ma przeciążenie plikowe i przeciążenie TStream, oba biorące opcjonalne TSaveOption (domyślnie saNone) i TPdfVersion (domyślnie pvUnknown, co zostawia nagłówek bibliotece). Oba zwracają Boolean, a w zadaniu seryjnym ten wynik zasługuje na to samo sprawdzenie co Active. Przypnij wersję czymś w stylu pv17 tylko, gdy system po stronie konsumenckiej nalega na konkretny nagłówek
Odwrócona robota, cięcie jednego pliku na kilka, używa tych samych ciągów zakresu i tych samych pozycji liczonych od jedynki; artykuł o cięciu przeprowadza przez to
ImportPages, MergeFiles i scalenie świadome formularzy opisane tu płyną z PDFium Component, które przynosi te operacje na stronach aplikacjom Delphi i C++Buildera