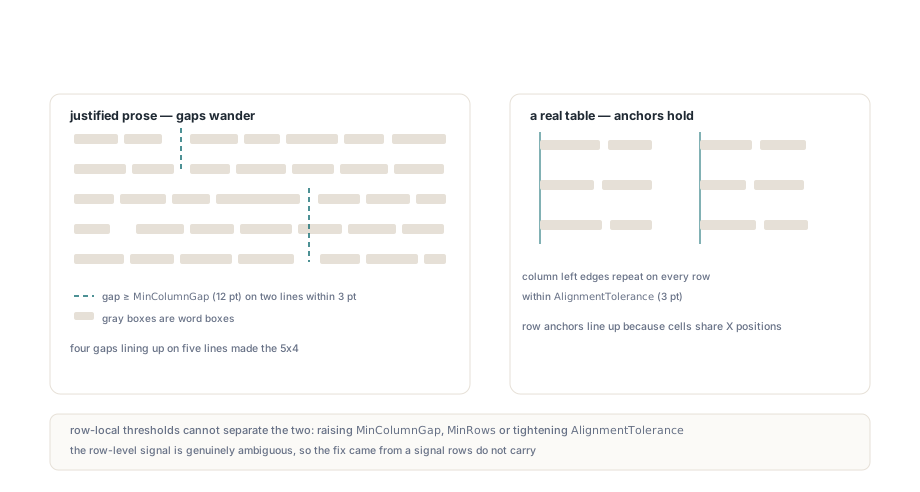
Strona wyjustowanego tekstu głównego może wrócić z detektora tabel po białych znakach jako siatka kilku kolumn, w której każda komórka trzyma połamaną pół-wypowiedź, a wartość pewności stoi wysoko ponad jakikolwiek próg, jaki przyszłoby ci do głowy. Nie ma na tej stronie żadnej tabeli. Detektor znalazł odstępy między słowami na tyle szerokie, by przejść za separatory kolumn, i kilka kolejnych wierszy, w których te odstępy wypadły na prawie tej samej pozycji X — a na samym wyrównaniu to dokładnie tak wygląda tabela. Odpowiedzią jest przestanie oceniania granicy kolumny wiersz po wierszu i pytanie, czy między kolumnami w dół strony biegnie pas pustego papieru
Czemu wyjustowany tekst przechodzi test tabeli po białych znakach?
Wyjustowany tekst przechodzi, bo wyjustowany wiersz to rząd słów rozdzielonych odstępami, które silnik składu rozciągnął, a gdy rozciągnięty odstęp przekroczy próg kolumnowy, nic w tym pojedynczym wierszu nie odróżnia go od marginesu kolumnowego. Strategia białych znaków w PDFium Component działa jak większość detektorów białych znaków. TPdf.ExtractTables grupuje ramki słów w wiersze wizualne, dzieli każdy wiersz tam, gdzie odległość pozioma od jednego słowa do następnego wynosi co najmniej MinColumnGap (12 punktów w TPdfTableExtractionOptions.Default), i klastruje lewe krawędzie powstałych grup słów w kotwice kolumn w granicach AlignmentTolerance, domyślnie 3 punktów. Kotwica przeżywa tylko wtedy, gdy powtarza się na co najmniej MinRows wierszach, a każdy wiersz kandydata musi trafić w co najmniej MinColumns różnych kotwic. Dla prawdziwej wyrównanej tabeli ta reguła jest słuszna — i to ta reguła, którą opisuje przegląd wykrywania tabel
Arytmetyka po stronie prozy jest mniej wybaczająca, niż wygląda. Weź wiersz o stopniu 10 w kolumnie biuletynu szerokiej na 180 punktów, kończący się 30 punktów przed prawym marginesem, bo następne słowo się nie zmieściło, trzymający tylko trzy odstępy międzysłowne, bo jego słowa są długie. Silnik justowania rozsmarowuje te 30 punktów na trzy odstępy, więc każdy rośnie z około 2,5 punktu do 12,5 punktu i przekracza domyślne MinColumnGap. Drugi wiersz potrzebuje tylko jednego rozciągniętego odstępu, którego następne słowo startuje w granicach 3 punktów od pozycji z pierwszego wiersza — i detektor ma kandydata na dwuwierszową, dwukolumnową tabelę
Nie ma znaczenia, jak rozciągnięcie jest zakodowane. ISO 32000-1 §9.3.3 nakłada odstęp słowny (Tw) wyłącznie na jednobajtowy kod znaku 32, więc producenci używający czcionek wielobajtowych zwykle pozycjonują słowa numerycznymi korektami w tablicy TJ (§9.4.3); a ramki słów wychodzą identyczne tak czy inaczej. Ostatni wiersz każdego akapitu jest składany poszarpany i niesie zwykłe spacje — dlatego fałszywe trafienia pokrywają zwykle korpus akapitu i kończą się o wiersz przed jego końcem
Szybkim sposobem sprawdzenia własnego korpusu jest przepuszczenie przez detektor dokumentów, o których wiesz, że to sama proza — listów albo komunikatów prasowych — i wypisanie każdej tabeli w trybie białych znaków, jaką zgłosi. Oczekiwane wyjście na takich dokumentach to nic
uses
  SysUtils, PDFium;

// Wypisuje każdą tabelę wyrównaną po białych znakach w wczytanym dokumencie,
// żeby strony, o których wiesz, że to sama proza, dało się szybko sprawdzić
procedure ReportWhitespaceTables(Pdf: TPdf; MinRows: Integer = 2);
var
  Options: TPdfTableExtractionOptions;
  Tables: TPdfTables;
  I: Integer;
begin
  Options := TPdfTableExtractionOptions.Default;  // MinColumnGap 12, AlignmentTolerance 3
  Options.MinRows := MinRows;
  Tables := Pdf.ExtractDocumentTables(Options);   // przywraca aktywną stronę
  for I := 0 to High(Tables) do
    if Tables[I].DetectionMode = ptdmWhitespace then
      Writeln(Format('page %d: %dx%d whitespace table, confidence %.2f, ' +
        'first cell "%s"',
        [Tables[I].PageNumber, Tables[I].RowCount, Tables[I].ColumnCount,
         Tables[I].Confidence, Tables[I].Cells[0].Text]));
end;
Ile kosztuje każdy z progów
Każdy próg na poziomie wiersza wymienia jedną klasę dokumentów na inną — i dlatego przy tym problemie lepiej je zostawić w spokoju. Podniesienie MinColumnGap do 20 punktów gubi zwarte kolumny gęstych sprawozdań finansowych, gdzie margines między kolumną etykiet a jej wartościami bywa ledwo szerszy od wartości domyślnej. Podniesienie MinRows do 3 odrzuca prawdziwe dwuwierszowe tabele i tylko obniża szanse przy długich akapitach, bo strona prozy daje wiele okazji, by trzy wiersze się ustawiły. Zacieśnienie AlignmentTolerance poniżej 3 punktów zaczyna rozłamywać prawdziwe kolumny, których lewe krawędzie lekko drżą, jak na skanach z warstwą tekstu z OCR
MinConfidence wygląda na naturalny filtr i jest najsłabszy z czwórki. Tabela po białych znakach w PDFium Component zdobywa 0,58 plus 0,30 razy udział niepustych komórek, z sufitem 0,88, więc wynik mierzy, jak pełna jest siatka. Fragment akapitu wypełnia każdą komórkę, co znaczy, że prozowa fałszywka punktuje blisko sufitu zakresu, podczas gdy prawdziwa tabela z pustymi komórkami punktuje niżej
Dwa wiersze wyjustowanej prozy i dwa wiersze dwukolumnowej tabeli potrafią wyprodukować identyczne grupy słów na identycznych kotwicach. Dowód, który je rozdziela, siedzi między wierszami
Prawdziwa granica kolumny to pionowy korytarz
Prawdziwa granica kolumny to pionowy pas strony, który pozostaje wolny od tekstu w każdym wierszu, który rozdziela. Tabela ma taki pas między każdą parą kolumn z założenia, bo komórki układano względem wspólnych pozycji X. Wyjustowany akapit rozciąga swoje odstępy w innym miejscu poziomym w każdym wierszu, więc żaden pas nie przeżyje więcej niż wiersza czy dwóch. PDFium Component sprawdza dokładnie to, gdy grupy słów kandydata zostaną przypisane do kolumn kotwic. Dla każdej pary sąsiednich kolumn każdy wiersz z treścią w obu komórkach wnosi przedział od najbardziej prawej krawędzi słów lewej komórki do najbardziej lewej krawędzi słów prawej komórki; przedziały są przecinane przez wiersze, a całego kandydata odrzuca się, gdy przecięcie jest węższe niż połowa MinColumnGap — 6 punktów przy wartościach domyślnych
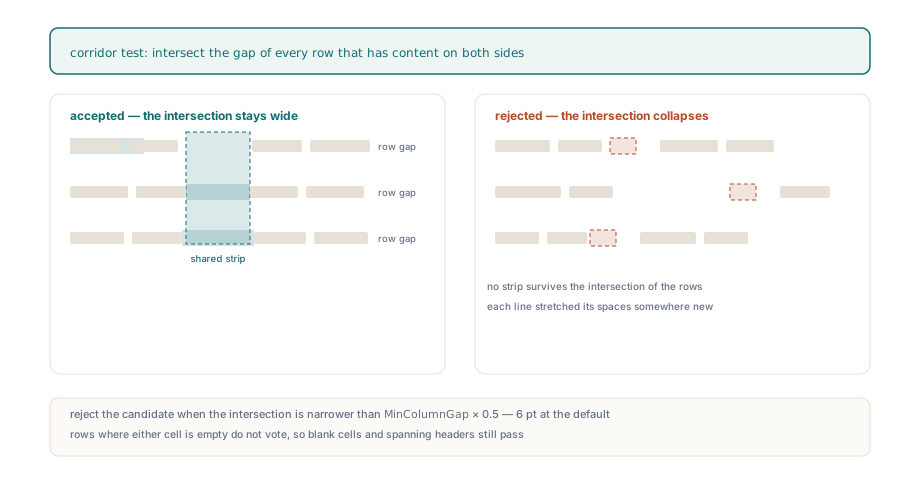
Na niewygodnych prawdziwych tabelach znaczące są dwa szczegóły. Wiersze, w których którakolwiek komórka jest pusta, nie głosują, więc tabela z pustymi komórkami albo nagłówek obejmujący mniej kolumn niż ciało nadal przechodzą. A szerokość korytarza jest wyprowadzana z MinColumnGap zamiast być osobną opcją, bo obie wartości opisują to samo fizyczne zjawisko: odstęp, który projektant zostawia między kolumnami. Połowa zostawia miejsce na wiersz, w którym długi wpis w lewej kolumnie biegnie blisko następnej
Sprawdzenie jest na tyle małe, że da się je odtworzyć we własnym kodzie layoutu; listy komórek poniżej to twoja własna struktura — jedna tablica indeksów słów na komórkę, w porządku wiersz-główny
uses
  Math, PDFium;

type
  TIndexList = array of Integer;
  TCellIndexes = array of TIndexList;   // twoja własna struktura: Row * ColumnCount + Column

// Zwraca False, gdy dowolna para sąsiednich kolumn nie ma pionowego
// korytarza wolnego od tekstu o szerokości co najmniej MinColumnGap / 2 w wierszach, które go używają
function HasTextFreeCorridors(const Words: TPdfWordBoxes;
  const Cells: TCellIndexes; RowCount, ColumnCount: Integer;
  MinColumnGap: Double): Boolean;
var
  Col, Row, I, LeftCell, RightCell, Supported: Integer;
  CorridorLeft, CorridorRight, RowLeft, RowRight: Double;
begin
  for Col := 0 to ColumnCount - 2 do
  begin
    CorridorLeft := -MaxDouble;
    CorridorRight := MaxDouble;
    Supported := 0;
    for Row := 0 to RowCount - 1 do
    begin
      LeftCell := Row * ColumnCount + Col;
      RightCell := LeftCell + 1;
      if (Length(Cells[LeftCell]) = 0) or (Length(Cells[RightCell]) = 0) then
        Continue;                             // puste komórki nie głosują
      RowLeft := -MaxDouble;
      RowRight := MaxDouble;
      for I in Cells[LeftCell] do
        RowLeft := Max(RowLeft, Words[I].Rect.Right);
      for I in Cells[RightCell] do
        RowRight := Min(RowRight, Words[I].Rect.Left);
      CorridorLeft := Max(CorridorLeft, RowLeft);
      CorridorRight := Min(CorridorRight, RowRight);
      Inc(Supported);
    end;
    if (Supported > 0) and
       (CorridorRight - CorridorLeft < MinColumnGap * 0.5) then
      Exit(False);
  end;
  Result := True;
end;
Trzymanie tabel siatkowych poza przebiegiem po białych znakach
Tabela siatkowa zostałaby znaleziona dwa razy, gdyby przebieg po białych znakach widział każde słowo na stronie, bo czysta tabela siatkowa jest z założenia także doskonale wyrównaną tabelą po białych znakach. Sama w sobie reguła nakładania większego niż połowa przepuściłaby kandydata łączącego dolne wiersze tabeli siatkowej z kilkoma wyrównanymi liniami tekstu pod nią — wypadłby poniżej stosunku i wyszedł jako druga, większa tabela krwawiąca w sąsiada
Gdy oba DetectRuledTables i DetectWhitespaceTables są włączone — co jest domyślne — ExtractTables puszcza najpierw przebieg siatkowy i usuwa każde słowo, którego punkt środkowy leży wewnątrz granic tabeli siatkowej, zanim ruszy przebieg po białych znakach. Używany jest środek zamiast pełnego zawierania, więc słowo wystające poza obramowanie o ułamek punktu idzie za tabelą, do której wizualnie należy. Strategia białych znaków pracuje potem wyłącznie na wolnych słowach, a mała tabela bez obramowań leżąca bezpośrednio pod siatką jest sądzona po własnych wierszach
Czemu „Purpose of Request:” może wyjść jako „of Purpose Request:”?
Słowa w komórce wychodzą w złej kolejności, gdy kod rozstrzygający „ten sam wiersz” porównuje pionowe środki, bo ramki słów zbudowane z ramek glifów nie dzielą środka, nawet gdy dzielą linię bazową. FPDFText_GetCharBox zwraca ciasny prostokąt tuszu glifu w przestrzeni strony, a nie prostokąt dopełniony do wyniesienia i wydłużenia czcionki, a ramka słowa to suma prostokątów jego znaków. W etykiecie formularza typu „Purpose of Request:” słowa „Purpose” i „Request:” niosą wydłużenia dolne, a „of” nie, więc prostokąt „of” jest krótszy, a jego środek siedzi o parę punktów wyżej. Rutyna sortująca po środku Y z 1-punktową tolerancją tego samego wiersza, a potem po lewej krawędzi, stawia „of” na własnym wierszu nad pozostałymi i emituje je pierwsze
PDF nie daje skrótu. ISO 32000-1 §9.4.4 umieszcza glify przesunięciem wzdłuż linii bazowej, a jedyne metryki pionowe w pliku są przypisane do czcionki: Ascent, Descent i FontBBox w deskryptorze czcionki (§9.8.1). Nic nie mówi, że dwa glify dzielą wiersz. Ciasne prostokąty, dzięki którym zaznaczanie podświetleń wygląda dobrze — jak opisuje artykuł o zaznaczaniu wierszy tekstu ramkami znaków w PDFium — to złe wejście dla porównywania odległości środków
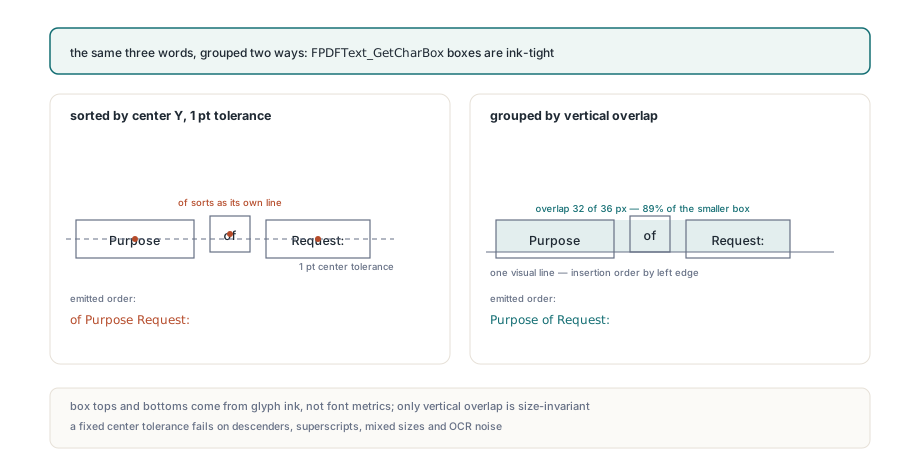
PDFium Component składa tekst komórek po nakładaniu. Słowo dołącza do wiersza wizualnego, gdy jego pionowe nakładanie z bieżącymi granicami wiersza wynosi co najmniej 25 procent mniejszej z dwóch wysokości albo gdy oba środki mieszczą się w obrębie punktu od siebie; każdy wiersz jest potem sortowany po lewej krawędzi, a wiersze łączy para CR LF. „Purpose” i „of” nakładają się na całej wysokości x — znacznie więcej niż ćwiartki krótszego prostokąta — więc lądują w jednym wierszu i czytają się w kolejności
Grupuj wiersze tekstu po nakładaniu we własnym kodzie
Ta sama pułapka czeka w każdym kodzie layoutu PDF, który rozstrzyga „ten sam wiersz”, porównując środki ze stałą tolerancją. Wydłużenia dolne to najłagodniejszy wyzwalacz. Pogrubione etykiety obok mniejszych wartości, znaczniki przypisów w indeksie górnym i zaszumione ramki OCR przesuwają środki bardziej niż jakakolwiek tolerancja, która wciąż rozdziela sąsiednie wiersze tekstu o stopniu 10 przy interlinii 12. Stosunek nakładania nie zależy od rozmiaru: dwa prostokąty na jednej linii bazowej nakładają się na wspólnej wysokości x, a dwa prostokąty w sąsiednich wierszach nie nakładają się wcale
TPdf.PageWordBoxes zwraca każde słowo na aktywnej stronie razem z jego prostokątem w przestrzeni strony w Rect, więc zgrupowanie strony w wiersze wizualne to jeden predykat i krótka pętla
uses
  Math, PDFium;

function SameVisualLine(const A, B: TPdfRectangle): Boolean;
var
  Overlap, MinHeight: Double;
begin
  Overlap := Min(A.Top, B.Top) - Max(A.Bottom, B.Bottom);
  MinHeight := Min(A.Top - A.Bottom, B.Top - B.Bottom);
  Result := (MinHeight > 0) and (Overlap >= MinHeight * 0.25);
end;

procedure GroupPageIntoLines(Pdf: TPdf; out Lines: TArray<TPdfWordBoxes>);
var
  Words: TPdfWordBoxes;
  Bounds: TArray<TPdfRectangle>;   // suma bieżąca na wiersz
  I, J, Found: Integer;
begin
  Words := Pdf.PageWordBoxes;            // wymaga aktywnej strony (Pdf.PageNumber)
  Lines := nil;
  Bounds := nil;
  for I := 0 to High(Words) do
  begin
    Found := -1;
    for J := High(Lines) downto 0 do
      if SameVisualLine(Bounds[J], Words[I].Rect) then
      begin
        Found := J;
        Break;
      end;
    if Found < 0 then
    begin
      SetLength(Lines, Length(Lines) + 1);
      SetLength(Bounds, Length(Bounds) + 1);
      Found := High(Lines);
      Bounds[Found] := Words[I].Rect;
    end;
    SetLength(Lines[Found], Length(Lines[Found]) + 1);
    Lines[Found][High(Lines[Found])] := Words[I];
    Bounds[Found].Left := Min(Bounds[Found].Left, Words[I].Rect.Left);
    Bounds[Found].Right := Max(Bounds[Found].Right, Words[I].Rect.Right);
    Bounds[Found].Top := Max(Bounds[Found].Top, Words[I].Rect.Top);
    Bounds[Found].Bottom := Min(Bounds[Found].Bottom, Words[I].Rect.Bottom);
  end;
  // posortuj każdy wiersz po Rect.Left przed czytaniem; PageWordBoxes zwraca
  // słowa w kolejności strumienia treści, która nie musi być wizualna
end;
Warto skopiować predykat. Do czegokolwiek poza szybkim zrzutem zacznij od modelu tekstu strukturalnego, który niesie już bloki, wiersze i źródło kolejności czytania — opisuje go artykuł o strukturalnym wyciąganiu tekstu PDF z kolejnością czytania
Co wołający tabel wciąż kontrolują
Wołający tabel dostają test korytarza, filtr słów z priorytetem siatek i tekst komórek po nakładaniu bez dotykania swoich opcji. Próg korytarza jest ustalony na połowę MinColumnGap, więc jedna wartość, którą stroisz szerokość marginesu, rządzi oboma. Strategia białych znaków trzyma podłogę dwóch wierszy nawet przy MinRows ustawionym na 1; tylko strategia siatkowa przyjmuje siatki jednowierszowe, których ExtractDocumentTables używa dla fragmentów tabel kontynuowanych na górze strony. Ten sam rekord opcji wędruje do TPdfReflowOptions.TableOptions, więc wyjście reflow dziedziczy te same decyzje, gdy DetectTables jest włączone
Test korytarza rozstrzyga na wierszach z treścią po obu stronach granicy, więc dwuwierszowy kandydat jest sądzony na zaledwie dwóch takich wierszach. Dla archiwów w większości prozowych, w których prawdziwe dwuwierszowe tabele zdarzają się rzadko — umów, korespondencji, esejów — ustaw MinRows na 3 i zaakceptuj stracone dwuwierszowe tabele. Dla dokumentów finansowych i formularzowych trzymaj domyślne 2, bo krótkie prawdziwe tabele są tam częste. Tekst wyrównany do lewej z poszarpanym prawym brzegiem trzyma zwykłe pojedyncze spacje i rzadko produkuje odstęp choćby zbliżony do 12 punktów
PDF nie ma ogólnego obiektu tabeli. ISO 32000-1 §14.8.4.3.4 definiuje element struktury Table, ale niesie go wyłącznie Tagged PDF, więc dla całej reszty siatka jest wnioskiem z geometrii, a Confidence tabeli po białych znakach nigdy nie przekracza 0,88
Opcje wykrywania, serializacja TPdfTable.ToCsv i ToJson oraz demo TableExtractionLab dla Delphi, C++Buildera i Lazarusa są opisane na stronie PDFium Component dla Delphi