Szukanie "two-x" w świeżo wygenerowanym PDF może zwrócić zero trafień, choć strona wprost pokazuje te pięć znaków. Zrzuć wyekstrahowany string jako punkty kodowe, a przyczyna jest tam: łącznik wrócił jako U+00AD SOFT HYPHEN, a spacja za nim jako U+00A0 NO-BREAK SPACE. Na ekranie oba wyglądają identycznie. Różnica mieszka w ToUnicode CMap, tabeli, którą czytnik konsultuje, by zamienić kody znaków z powrotem na Unicode, i bierze się z tego, że jeden glif czcionki jest współdzielony przez dwa punkty kodowe
Gołe narzędzia tekstowe pogłębiają niezgodność. Eksport CSV łamie linię inaczej, narzędzie diff oznacza dwie linie, które w każdym podglądzie czytają się tak samo, a sprawdzacz pisowni traktuje "two-x" z miękkim łącznikiem jako nieznane słowo. Normalizacja Unicode ratuje tylko w połowie: NFKC zwija U+00A0 do zwykłej spacji, bo NBSP niesie dekompozycję kompatybilnościową, ale U+00AD nie ma żadnej dekompozycji, więc miękki łącznik przeżywa każdą postać normalizacji
Dlaczego ekstrahowane spacje wracają jako U+00A0?
Ekstrahowane spacje zamieniają się w U+00A0, gdy ToUnicode CMap jest kluczowana glifami i do jednego glifu prowadzą dwa punkty kodowe. W Arialu glif 3 obsługuje i U+0020, i U+00A0, a glif łącznika — i U+002D, i U+00AD. CMap zbudowany od strony glifów musi coś powiedzieć o CID 0003, a generator PDFium w FPDFText_LoadFont kończy z dwoma oświadczeniami: wpis bfchar mapujący go do U+0020 i bfrange w postaci tablicy mapujący ten sam CID do U+00A0
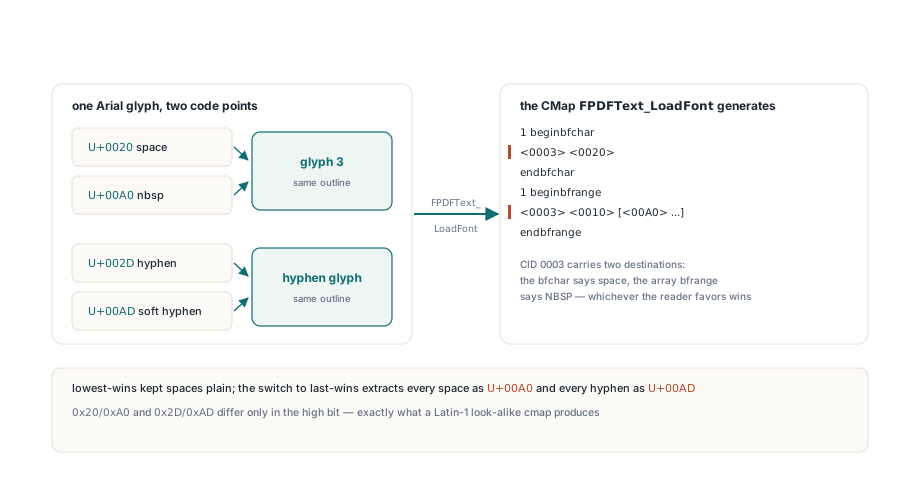
1 beginbfchar
<0003> <0020>
endbfchar
1 beginbfrange
<0003> <0010> [<00A0> ...]
endbfrange
ISO 32000-1 §9.10.3 opisuje, jak bfchar i bfrange mapują kody na Unicode, ale nie mówi, który wpis wygrywa, gdy dwa z nich roszczą sobie prawo do tego samego CID. Czytniki obierają regułę pierwszeństwa według własnego uznania. Czytnik trzymający mapowanie najniższe albo pierwsze ekstrahuje zwykłą spację; czytnik PDFium trzyma ostatnie, a ponieważ zakres tablicowy idzie za blokiem bfchar, każda spacja zapisana przez CMap kluczowaną glifami ekstrahuje się jako NBSP, a każdy łącznik jako miękki łącznik. Ten sam tekst może więc ekstrahować się różnie w dwóch podglądach tego samego pliku
Pary układają się we wzorzec. 0x20/0xA0 i 0x2D/0xAD różnią się tylko najwyższym bitem, co daje czcionka, której cmap wysyła sobowtóry Latin-1 do konturu już używanego dla znaku ASCII. Grecka wielka Omega (U+03A9) i znak Ohma (U+2126) też współdzielą glif w Arialu. Jeśli kod ekstrakcji, który kiedyś przechodził, teraz wykłada się na znakach, których nie widzisz, wypisz punkty kodowe zamiast ufać tekstowemu widokowi debugera; podstawy wyciągania tekstu ze strony opisuje ekstrakcja tekstu z dokumentów PDF z PDFium w Delphi
Jak PDFium Component kluczuje czcionki systemowe po punkcie kodowym
PDFium Component nigdy nie prosi silnika o wygenerowanie tamtej CMap dla czcionek systemowych niosących cmap Unicode. Gdy TPdf.AddText potrzebuje czcionki, komponent czyta własną tabelę sfnt cmap czcionki, przedkładając podtabelę formatu 12 i cofając się do formatu 4. Punkty kodowe wracają posortowane i od duplikatów oczyszczone, a CID k+1 dostaje k-ty punkt kodowy, przy CID 0 zostawionym jako .notdef. Jawne CIDToGIDMap prowadzi każdy CID do jego glifu. U+0020 i U+00A0 dostają więc dwa różne CID-y rysujące ten sam kontur, a ToUnicode CMap, którą zapisuje komponent, mapuje każdy CID na dokładnie jeden punkt kodowy
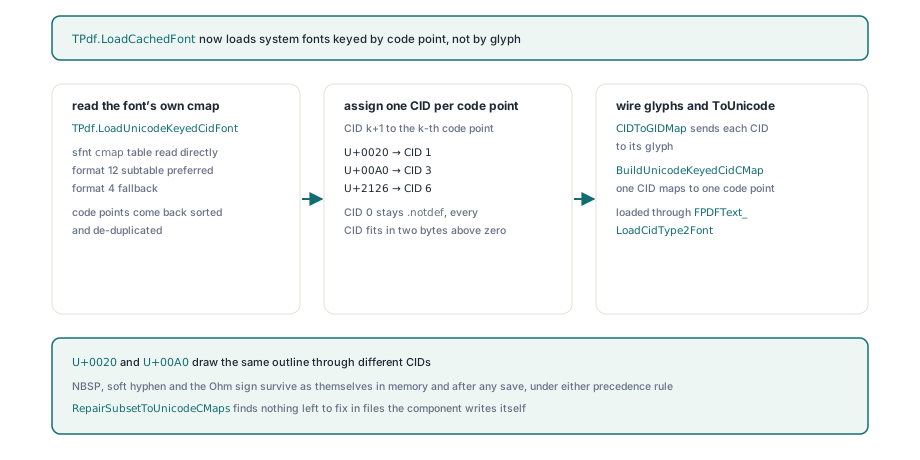
Czcionka jest ładowana przez FPDFText_LoadCidType2Font, ten sam punkt wejścia, co przy zapisie na poziomie glifów w osadzaniu czcionek CID Type 2 z jawnymi mapami CID-do-GID. Gdy FPDFText_SetText zapisuje potem string, odwrotne wyszukiwanie ląduje na jednym CID na znak. Nic z tego nie zależy od reguły pierwszeństwa czytnika, bo nie ma drugiego mapowania, między którym reguła mogłaby wybierać. Zapisany plik niesie też własny strumień ToUnicode komponentu, więc ekstrakcja po ponownym wczytaniu widzi tę samą tabelę jeden-do-jednego, z której korzystał żywy dokument
Koszt to większe CIDToGIDMap: dwa bajty na każdy punkt kodowy pokryty przez czcionkę. Załóżmy czcionkę mapującą około 3000 punktów kodowych. Mapa wychodzi wtedy na jakieś 6 KB, oddawane silnikowi z każdą czcionką. Ten handel jest wart zawarcia za każdym razem. Kilka kilobajtów kupuje ekstrakcję czytającą się tak samo w PDFium, w podglądach trzymających pierwsze mapowanie i w tym indeksatorze, który twój klient odpali w przyszłym roku
Round-trip poniżej zapisuje string zawierający każdą problematyczną parę, ekstrahuje go z niezapisanego dokumentu, zapisuje, wczytuje ponownie i ekstrahuje jeszcze raz. Oba stringi powinny zgadzać się z wejściem dokładnie; pomocnik CodePoints jest tam tylko po to, by niezgodność dała się przeczytać:
uses
  SysUtils, PDFium;

const
  // Spacja/U+00A0 i łącznik/U+00AD współdzielą jeden glif Ariala,
  // tak jak grecka Omega (U+03A9) i znak Ohma (U+2126)
  Sample: WString = 'two-x'#$00A0'y'#$00AD'z '#$03A9#$2126;

function CodePoints(const S: WString): string;
var
  I: Integer;
begin
  Result := '';
  for I := 1 to Length(S) do
    Result := Result + 'U+' + IntToHex(Ord(S[I]), 4) + ' ';
end;

var
  Pdf: TPdf;
  Live, Reloaded: WString;
begin
  Pdf := TPdf.Create(nil);
  try
    Pdf.CreateDocument;
    Pdf.AddPage(1, 595, 842);
    Pdf.AddText(Sample, 'Arial', 12, 72, 770);
    Live := Pdf.Text;                  // żywy, niezapisany dokument
    Pdf.SaveAs('codepoints.pdf');
  finally
    Pdf.Free;
  end;

  Pdf := TPdf.Create(nil);
  try
    Pdf.FileName := 'codepoints.pdf';
    Pdf.Active := True;
    Pdf.PageNumber := 1;
    Reloaded := Pdf.Text;              // po pełnym zapisie i ponownym wczytaniu
  finally
    Pdf.Free;
  end;

  if (Live <> Sample) or (Reloaded <> Sample) then
    Writeln('Mismatch: ', CodePoints(Live), '/ ', CodePoints(Reloaded));
end.
Zostaw NBSP i miękki łącznik w stringu próbnym, nawet jeśli twoje dokumenty rzadko je zawierają. Test zapisujący wyłącznie ASCII przejdzie też przeciw CMap kluczowanej glifami, bo nic w nim nie prosi czytnika o wybór między dwoma mapowaniami
Dlaczego jeden wpis bfrange może zmazać cały blok?
Pojedynczy bfrange, którego pas CID-ów przekracza granicę xxFF, każe PDFium wyrzucić cały blok, w którym siedzi. ISO 32000-1 §9.10.3 pozwala w ramach zakresu zmiennać tylko ostatni bajt celu, a strona CID-ów ma pasującą pułapkę w parserze PDFium: wysoki CID wylicza jako (low and $FFFFFF00) or (high and $FF). Pas od CID 00FE do 0101 jest czytany jako 00FE do 0001, czyli niski większy niż wysoki, i cały blok zostaje oznaczony jako nieważny. SetText kończy się sukcesem, strona renderuje się poprawnie, a ekstrakcja zwraca U+0000 dla każdego znaku tego bloku
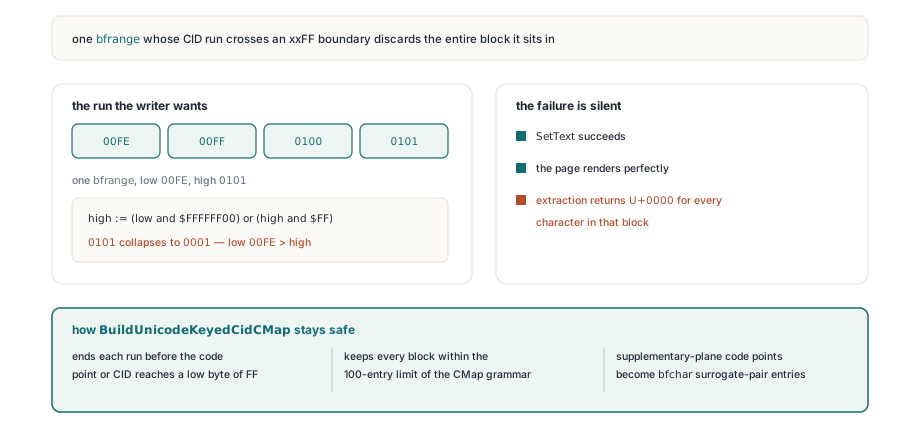
Czcionka kluczowana punktem kodowym to dokładnie tam, gdzie to gryzie. CID-y są gęste i kolejne, więc każda czcionka z więcej niż 255 punktami kodowymi produkuje pasy CID, które przekroczyłyby 00FF, 01FF i tak dalej, gdyby pisarz po prostu sklejał kolejne wpisy. CMap, którą zapisuje PDFium Component, kończy pas, zanim punkt kodowy albo CID dosięgnie niskiego bajtu FF, i dzieli wpisy na bloki po najwyżej 100 — limit, który gramatyka CMap stawia każdej sekcji beginbfrange i beginbfchar
Punkty kodowe powyżej U+FFFF dostają pojedyncze wpisy bfchar o celach będących parami surrogatów UTF-16, bo inkrementowanie pary surrogatów wewnątrz zakresu nie ma zdefiniowanego znaczenia. Stronę surrogatów opisuje obsługa emoji, CJK i par surrogatów w Delphi. CMap wyłącznie na bfchar omijałby problem granic w całości, kosztem kilkukrotnie większego rozmiaru, dlatego zakresy zostają główną formą, a reguły podziału dźwigają ciężar
Naprawa konfliktów ToUnicode w plikach z innych narzędzi
RepairSubsetToUnicodeCMaps w jednostce FPdfCompress naprawia konflikt kluczowany glifami w plikach, których komponent nie pisał. TPdf.SaveAs odpala ją przy każdym pełnym, nieinkrementalnym zapisie, a ty możesz zawołać ją wprost na dowolnym strumieniu. Dla każdego CID niosącego dwa cele wygrywa wpis bfchar. Bez bfchar dla danego CID para różniąca się tylko najwyższym bitem rozstrzyga się na mniejszy, bazowo-łaciński punkt kodowy. Każdy inny konflikt trzyma swoje pierwsze mapowanie
Naprawa edytuje konfliktowe wartości hex w miejscu, zastępowaniami tej samej długości. Układ bloków, pokrycie CID i każdy inny bajt strumienia zostają jak były, więc CMap pozostaje w kształcie, który czytnik PDFium już zaakceptował. Czysto przebudowana CMap wyglądałaby schludniej w zrzucie hex. Zmieniałaby też strukturę strumienia, który surowy czytnik już zaakceptował, i to zakład bez żadnego zysku, gdy zepsutych jest tylko garść wartości celów
uses
  Classes, FPdfCompress;

var
  Source, Dest: TFileStream;
begin
  Source := TFileStream.Create('from-other-tool.pdf',
    fmOpenRead or fmShareDenyWrite);
  try
    Dest := TFileStream.Create('repaired.pdf', fmCreate);
    try
      // Wyłącznie edycje tej samej długości; pliki bez naprawialnego konfliktu
      // oraz pliki ze strumieniami odniesień krzyżowych lub obiektów są kopiowane jak są
      RepairSubsetToUnicodeCMaps(Source, Dest);
    finally
      Dest.Free;
    end;
  finally
    Source.Free;
  end;
end.
Rutyna przebudowuje klasyczną tabelę odniesień krzyżowych, więc dokumenty używające strumieni odniesień krzyżowych, referencji hybrydowych albo strumieni obiektów przechodzą bajt w bajt. Zapisy inkrementalne (saIncremental) pomijają naprawę z założenia, bo rewizja inkrementalna musi pozostać wyłącznie dołączana. Dla tekstu, który komponent sam zapisuje, żadne z obu przypadków nie ma znaczenia: czcionki kluczowane punktem kodowym nigdy nie produkują konfliktu, który naprawa mogłaby znaleźć
Gdzie stosuje się ścieżka kluczowana punktem kodowym
Ścieżka kluczowana punktem kodowym obejmuje każdą czcionkę wystawiającą podtabelę cmap Unicode, a ładowanie kluczowane glifami w PDFium ogarnia resztę. Szczegóły warte znajomości, zanim się na niej oprzesz:
- Czcionki symboli z samym cmap (3,0) i każda czcionka, której ścieżka CID nie potrafi załadować, idą przez
FPDFText_LoadFont, gdzie glif współdzielony przez dwa punkty kodowe podlega regule pierwszeństwa czytnika - Przy samej podtabeli formatu 4 mapa pokrywa Podstawową Płaszczyznę Wielojęzykową; podtabela formatu 12 na platformie (3,10) albo platformie Unicode dodaje punkty kodowe płaszczyzny uzupełniającej
- Glif 0 i punkty kodowe surrogatów są pomijane, a liczba wpisów jest ograniczona do 65535, żeby każdy CID mieścił się w dwóch bajtach powyżej zera
- Kolekcje TrueType wymagają dodatkowej ostrożności: GDI
GetFontDatazwraca cały .ttc, aFPDFText_LoadCidType2Fontnie ma parametru indeksu kroju, więc przepuszczenie kolekcji w całości osadziłoby krój 0, SimSun, choć prosiłeś o NSimSun z simsun.ttc. Komponent zestawia nazwę rodziny z tabelą nazw czcionki (nameID 1 i 16) i podaje żądany krój jako samodzielne sfnt; kolekcja, której nie potrafi sparsować, przechodzi w całości i używa kroju 0 - Jeśli żadnej czcionki systemowej o żądanej nazwie nie da się przeczytać,
AddTextprzekazuje nazwę czcionki doFPDFPageObj_NewTextObj, która szuka jej wśród standardowych czcionek PDFium
Zwijaj niewidzialne znaki w indeksie, trzymaj je w tekście
Gdy ekstrakcja zwraca już prawdziwe punkty kodowe, pojawia się inne pytanie: co indeks wyszukiwania ma zrobić z prawdziwym NBSP albo miękkim łącznikiem, które autor wpisał celowo? Zwijaj je w warstwie indeksowania i zostaw TPdf.Text w spokoju. Wyekstrahowany string to zapis tego, co dokument mówi; indeks to stratny widok zbudowany do dopasowywania i reguły zwijania należą do niego
Pomocnik poniżej to funkcja, którą dopisujesz do własnego kodu. Mapuje NBSP na spację i wyrzuca miękki łącznik, który według Standardu Unicode tylko zaznacza miejsce, gdzie linia może się złamać. Celowo zostawia U+2126 nietknięte. Normalizacja NFC zamieniłaby znak Ohma w Omegę, bo U+2126 ma kanoniczną dekompozycję singletonową do U+03A9, a czy wyszukiwanie w kartach katalogowych powinno łapać te dwa znaki razem, to decyzja produktowa, nie ekstrakcyjna:
uses
  SysUtils, Classes, PDFium;

// Twój własny pomocnik dla indeksu wyszukiwania; nie część PDFium Component
function FoldForIndex(const S: string): string;
begin
  Result := StringReplace(S, #$00A0, ' ', [rfReplaceAll]);
  Result := StringReplace(Result, #$00AD, '', [rfReplaceAll]);
end;

procedure IndexDocument(const FileName: string; Lines: TStrings);
var
  Pdf: TPdf;
  P: Integer;
begin
  Pdf := TPdf.Create(nil);
  try
    Pdf.FileName := FileName;
    Pdf.Active := True;
    for P := 1 to Pdf.PageCount do
    begin
      Pdf.PageNumber := P;
      Lines.Add(FoldForIndex(Pdf.Text));   // dokładny tekst zostaje w Pdf.Text
    end;
  finally
    Pdf.Free;
  end;
end;
Odpal IndexDocument na pliku codepoints.pdf z pierwszego przykładu, a indeksowana linia powinna czytać się "two-x yz ΩΩ", jedenaście znaków ze znakiem Ohma na końcu, podczas gdy Pdf.Text nadal zwraca wszystkie dwanaście oryginalnych znaków, w tym NBSP i miękki łącznik
Czcionki kluczowane punktem kodowym, naprawa CMap i ekstrakcja tekstu siedzą na tym samym modelu strony w Delphi, C++Builder i Lazarus; API czcionek i tekstu jest opisane w całości na stronie produktu PDFium Component for Delphi