PDFium Component zapisuje tekst na stronie PDF na poziomie glifów za pomocą AddCidType2Text, osadzając dostarczone przez ciebie dane TrueType jako czcionkę CID Type 2. Przypisuje każdemu wystąpieniu glifu kolejny CID, generuje jawną mapę CID-to-GID oraz CMap ToUnicode, i scala glify na tej samej linii bazowej w pojedynczy natywny obiekt tekstowy. Opcjonalne tworzenie podzbioru utrzymuje mały rozmiar pliku, z jawną polityką na wypadek, gdy tworzenie podzbioru zawiedzie
Zapis na poziomie glifów jest tym, czego potrzebujesz, gdy tekst został już ukształtowany (shaped). Arabski, dewanagari i każde pismo z formami kontekstowymi tworzą sekwencję identyfikatorów glifów, która nie mapuje się już jeden do jednego na znaki, więc API przyjmujące łańcuch i nazwę czcionki nie może wyrazić wyniku. Bezpośrednie przekazanie glifów i pozycji to jedyny sposób, by umieścić w PDF poprawnie ukształtowany tekst złożonego pisma
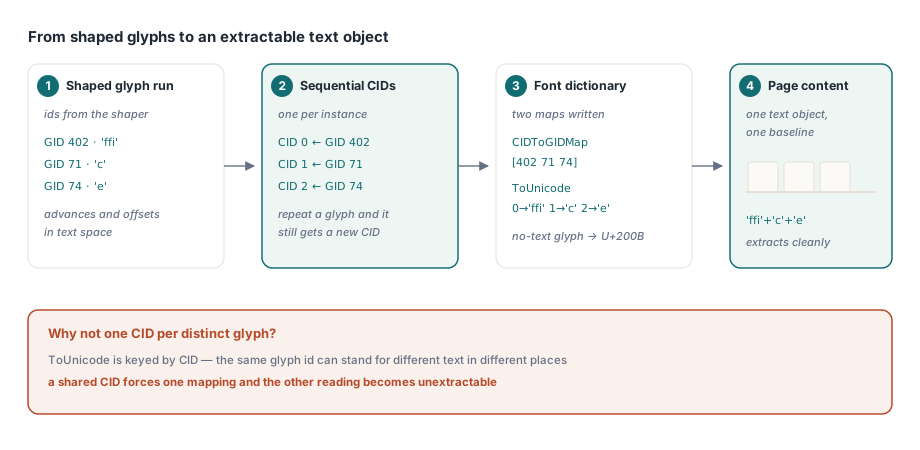
Dlaczego każde wystąpienie glifu dostaje własny CID
Kusząca optymalizacja to deduplikacja: jeden CID na odrębny identyfikator glifu, wielokrotnie używany wszędzie, gdzie ten glif się pojawia. Daje to mniejszą czcionkę i psuje wyodrębnianie tekstu, ponieważ ten sam glif może zasadnie odpowiadać różnej treści Unicode w różnych miejscach
Glif ligatury to wyraźny przykład. Ten sam glif „ffi” może reprezentować trzy znaki w jednym słowie, a po innej decyzji kształtowania — coś innego gdzie indziej. Mapa ToUnicode jest indeksowana po CID, więc współdzielony CID może nieść tylko jedno mapowanie, a tekst, który przegra tę rywalizację, staje się niemożliwy do wyodrębnienia
Dlatego każde wystąpienie glifu otrzymuje własny CID, a każde mapowanie może swobodnie obejmować kilka jednostek kodowych UTF-16. Glif bez znaczącego tekstu — element dekoracyjny, glif wyłącznie pozycjonujący — mapuje się jawnie na U+200B, spację o zerowej szerokości, dzięki czemu każdy CID ma obserwowalny wynik ekstrakcji, a nie lukę
uses
  PDFium;

var
  Pdf: TPdf;
  Glyphs: TPdfCidGlyphs;
  Options: TPdfCidFontOptions;
  Report: TPdfCidFontReport;
begin
  Pdf := TPdf.Create(nil);
  try
    Pdf.FileName := 'label.pdf';
    Pdf.LoadDocument;
    Pdf.PageNumber := 1;

    // Jeden wpis na każdy ukształtowany glif: identyfikator glifu, tekst, który reprezentuje,
    // oraz jego przesunięcie i offsety w przestrzeni tekstu
    SetLength(Glyphs, 3);
    Glyphs[0].GlyphID := 402;  Glyphs[0].UnicodeText := 'ffi';
    Glyphs[0].Advance := 18.4;
    Glyphs[1].GlyphID := 71;  Glyphs[1].UnicodeText := 'c';
    Glyphs[1].Advance := 9.8;
    Glyphs[2].GlyphID := 74;   Glyphs[2].UnicodeText := 'e';
    Glyphs[2].Advance := 9.2;

    Options := TPdfCidFontOptions.Default;   // preferowany podzbiór
    Options.VerifyExtraction := True;

    if Pdf.AddCidType2Text(LoadFileBytes('NotoSans.ttf'), Glyphs,
         11, 72, 700, Options, Report) then
      Writeln(Format('%d glyphs, %d unique, font %d -> %d bytes, match=%s',
        [Report.GlyphCount, Report.UniqueGlyphCount,
         Report.OriginalFontBytes, Report.EmbeddedFontBytes,
         BoolToStr(Report.ExtractionMatches, True)]));
  finally
    Pdf.Free;
  end;
end;
Tworzenie podzbioru i kontrole, których nie daje kod powrotu
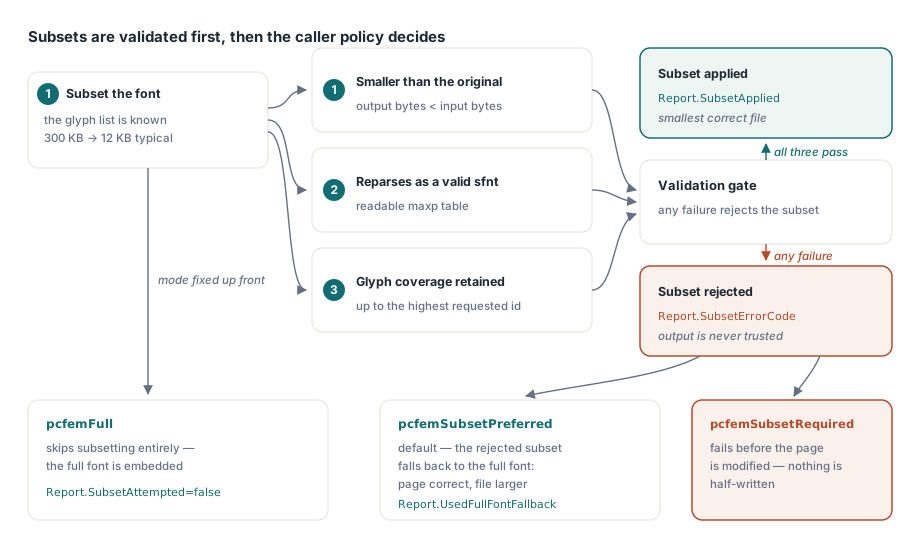
Utworzenie podzbioru czcionki ograniczonego do faktycznie używanych glifów to różnica między osadzeniem 300 KB a osadzeniem 12 KB, a w dokumencie z kilkoma czcionkami to właśnie decyduje, czy plik da się wysłać e-mailem. Platformowa ścieżka tworzenia podzbioru przyjmuje listę glifów bezpośrednio, co idealnie pasuje do tego API, ponieważ wywołujący już zna każdy używany identyfikator glifu
Czego to nie daje, to pewności. Wywołanie tworzenia podzbioru może zgłosić sukces i zwrócić wynik, który jest bezużyteczny, więc komponent waliduje trzy właściwości, zanim zaakceptuje wynik: wynik musi być mniejszy niż oryginał, musi ponownie sparsować się jako prawidłowy sfnt z czytelną tabelą maxp, i musi zachować glify aż do najwyższego żądanego oryginalnego identyfikatora. Każde niepowodzenie oznacza, że podzbiór jest odrzucany
To, co dzieje się dalej, jest polityką wywołującego. Przy pcfemSubsetPreferred, ustawieniu domyślnym, odrzucony podzbiór przechodzi na osadzenie pełnej czcionki, więc strona jest poprawna, po prostu większa. Przy pcfemSubsetRequired operacja zawodzi, zanim strona zostanie zmodyfikowana, czego potrzebuje potok ograniczony rozmiarem. pcfemFull całkowicie pomija tworzenie podzbioru. Raport mówi, którą ścieżkę wybrano, poprzez SubsetAttempted, SubsetApplied, UsedFullFontFallback i SubsetErrorCode
Weryfikacja, która nie może dać fałszywego pozytywu
Przy włączonym VerifyExtraction komponent potwierdza, że to, co zapisał, można odczytać z powrotem. Naiwnym sposobem na to jest wyodrębnienie całej strony i wyszukanie oczekiwanego łańcucha, i jest to błędne: strona, która już zawierała ten tekst, przechodzi kontrolę, nawet gdy nowy tekst został zapisany niepoprawnie
Zamiast tego strona tekstowa jest odbudowywana, a uchwyty obiektów wstawionych przez to wywołanie są odczytywane pojedynczo, w kolejności wstawienia, i łączone. Wynik jest porównywany z oczekiwanym tekstem, a raport ujawnia oba łańcuchy wraz z wartością logiczną, dzięki czemu niezgodność można zdiagnozować, a nie tylko wykryć
Włącz to podczas developmentu i w każdym potoku, w którym możliwość wyodrębnienia jest wymogiem — przeszukiwalne archiwa, zgodność z dostępnością, dalsze eksplorowanie tekstu. Koszt to jedna odbudowa strony tekstowej na wywołanie, dlatego nie jest to domyślnie włączone w ciasnych pętlach
Limity i atomowe niepowodzenie
Bajty czcionki, wystąpienia glifów i jednostki kodowe Unicode są każde ograniczone limitem przed alokacją, a format czcionki, indeks TTC, zakres identyfikatorów glifów i wartości geometrii są walidowane, zanim cokolwiek zostanie zapisane. Geometria musi być skończona, co brzmi oczywiście, dopóki silnik kształtujący nie poda ci przesunięcia NaN ze zniekształconej czcionki
Niepowodzenie jest atomowe na poziomie strony. Jeśli wczytywanie czcionki, zapis obiektu, generowanie treści albo weryfikacja ekstrakcji zawiedzie, każdy obiekt wstawiony przez to wywołanie jest usuwany w odwrotnej kolejności, a treść strony jest regenerowana. Nieudane wywołanie pozostawia stronę taką, jaka była, a nie z połową fragmentu tekstu na niej
Gdzie to pasuje w potoku tekstowym
Warto jasno powiedzieć o podziale pracy. Kształtowanie (shaping) — zamiana znaków na pozycjonowane glify — nie jest zadaniem tego API; należy do silnika kształtującego, a własną obsługę dwukierunkowości i złożonych pism komponentu opisano w obsłudze emoji, CJK i par surogatów. To API wywołujesz potem, z ciągiem glifów wyprodukowanym przez shaper
Dla zwykłego tekstu łacińskiego bez kształtowania kontekstowego prostsze API tekstowe oparte na łańcuchach są właściwym narzędziem i dają mniej kodu. Sięgnij po zapis CID Type 2, gdy masz ukształtowany wynik, gdy potrzebujesz dokładnej kontroli nad identyfikatorami glifów, albo gdy czcionka musi zostać osadzona z bajtów, które posiadasz, a nie rozwiązana po nazwie — alternatywą rozwiązywania czcionek jest mechanizm dostawcy opisany w kontrolowaniu podstawiania czcionek PDF
Jedna uwaga wdrożeniowa: osadzenie czcionki to kwestia licencyjna w takim samym stopniu jak techniczna. Czcionki różnią się tym, czy osadzanie jest w ogóle dozwolone, dozwolone tylko do wyświetlania, czy dozwolone do edycji. Biblioteka osadzi dowolne bajty, które jej podasz, a sprawdzenie licencji to twoja odpowiedzialność, nie odpowiedzialność formatu pliku
Zapis tekstu na poziomie glifów, dostarczanie czcionek i wyodrębnianie tekstu współdzielą ten sam model strony w Delphi, C++Builder i Lazarus; pełne API opisano na stronie PDFium Component dla Delphi