PDFium Component robi subset fontów już wbudowanych w istniejący PDF przez SubsetPdfDocumentFonts z modułu FPdfDocumentFontSubset. Funkcja wymienia wbudowany program TrueType /FontFile2 na mniejszy tylko wtedy, gdy same zasoby fontu dowodzą każdego glifu, jaki dokument może zreferować; font, którego dziedziny glifów nie da się udowodnić, zostaje dokładnie taki, jaki był
Zwykły powód, żeby tego chcieć, to archiwum, którego nie produkowałeś. Faktury, wyciągi i raporty ze starszych generatorów niosą często kompletny Arial albo pełną odmianę CJK w każdym pliku, a kilkaset kilobajtów fontu na dwustronicowy dokument szybko się sumuje w skali kilku milionów dokumentów. Renderowanie od nowa ze źródła to rzadko opcja. Masz PDF i jedyne bezpieczne pytanie brzmi, ile każdego wbudowanego fontu może pójść, żeby żadna strona nie straciła znaku
Dlaczego subsetowanie istniejącego PDF ryzykuje utratę glifów?
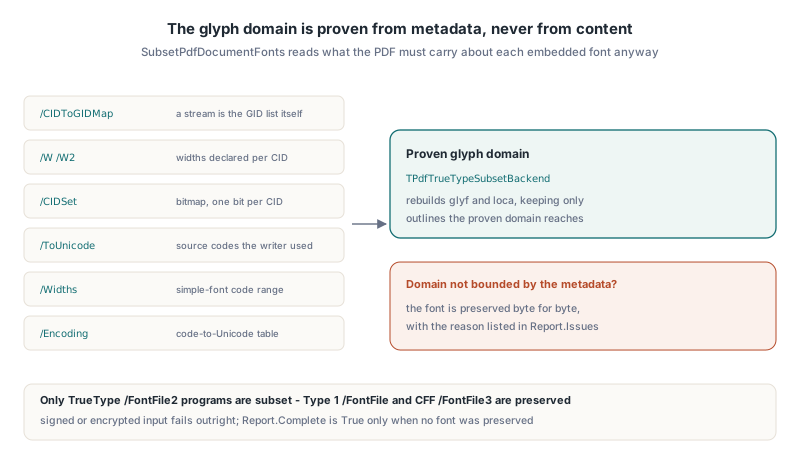
Subsetowanie istniejącego PDF ryzykuje utratę glifów, bo postprocesor nie wie, których glifów użył pierwotny writer. Producent, który wbudował font, znał własny tekst; narzędzie puszczane potem musi tę wiedzę zrekonstruować, a każdy glif, który przegapi, zamienia się w puste pudełko albo kształt .notdef na stronie, na którą nikt nie patrzy, dopóki nie spojrzy klient
Oczywiste podejście to parsowanie każdego strumienia treści, każdego Form XObject, każdego wyglądu adnotacji i każdego domyślnego wyglądu pola, zebranie kodów pokazywanych z każdym fontem i trzymanie tych glifów. Działa, dopóki nie spotka zasobu fontu współdzielonego między stronami i formami, pola formularza, którego wygląd przeglądarka regeneruje z /DA, albo strumienia treści z sekwencją operatorów, której skaner nie modeluje. SubsetPdfDocumentFonts celowo nie skanuje strumieni treści. Wyprowadza dziedzinę glifów z metadanych, które PDF i tak musi nieść o każdym foncie: /CIDToGIDMap, tablice szerokości /W i /W2, bitmapę /CIDSet, CMap /ToUnicode, tablicę /Widths prostego fontu i /Encoding. Gdy te metadane nie ograniczają dziedziny, font zostaje nietknięty
Trzymanie pierwotnych identyfikatorów glifów, żeby strumienie treści zostały nietknięte
Backend subsetu za SubsetPdfDocumentFonts, TPdfTrueTypeSubsetBackend, trzyma każdy pierwotny slot identyfikatora glifu, więc żaden strumień treści, CID ani /CIDToGIDMap nigdy nie musi być przepisany. Przebudowuje tabele glyf i loca, daje każdemu nieużytemu glifowi zakres loca zerowej długości i zostawia maxp.numGlyphs bez zmian. Glif 4711 jest po subsetowaniu dalej glifem 4711; ma po prostu kontury tylko, jeśli dokument umie do niego dosięgnąć
Ten wybór usuwa najbardziej ryzykowną część subsetowania gotowego dokumentu. Przenumerowanie glifów znaczyłoby przepisanie każdego napisu w każdym strumieniu treści używającym fontu, plus strumienia mapowania, plus wszystkiego, co cache'uje identyfikatory glifów. Zachowane identyfikatory kosztują trochę rozmiaru, bo loca trzyma jeden wpis na pierwotny glif, ale główną masę programu TrueType to dane konturów i to idzie. Glify złożone są śledzone do swoich składowych, więc litera z akcentem trzyma literę bazową i akcent, z którego jest zbudowana; cykliczne albo zbyt głębokie referencje złożone odrzucają font, zamiast produkować rozbite domknięcie
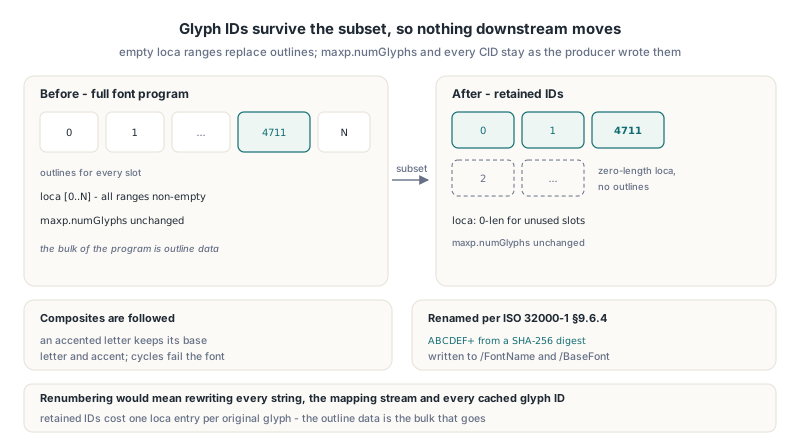
Przemianowany font trzyma się też ISO 32000-1 §9.6.4, które wymaga, by nazwa fontu subsetu zaczynała się od sześciu wielkich liter i plusa. Komponent wyprowadza sześć liter ze skrótu SHA-256 nowego programu fontu, zdejmuje najpierw istniejący prefiks ABCDEF+, rozstrzyga kolizje między fontami w tym samym dokumencie i zapisuje nową nazwę i do /FontName deskryptora, i do /BaseFont słownika fontu, łącznie z rodzicem Type0 CIDFonta
uses
  System.SysUtils, System.Classes, FPdfDocumentFontSubset;

procedure SubsetEmbeddedFonts(const SourceName, TargetName: string);
var
  Source, Target: TFileStream;
  Options: TPdfDocumentFontSubsetOptions;
  Report: TPdfDocumentFontSubsetReport;
  Output: TBytes;
begin
  Options := TPdfDocumentFontSubsetOptions.Default;
  Source := TFileStream.Create(SourceName, fmOpenRead or fmShareDenyWrite);
  try
    if not SubsetPdfDocumentFonts(Source, Options, Output, Report) then
      raise Exception.Create('Font subsetting failed: ' + Report.ErrorMessage);
  finally
    Source.Free;
  end;
  // Wyjście to zawsze kompletny PDF: przebudowany plik, gdy Report.Applied
  // jest True, inaczej kopia źródła bajt w bajt
  Target := TFileStream.Create(TargetName, fmCreate);
  try
    if Length(Output) > 0 then
      Target.WriteBuffer(Output[0], Length(Output));
  finally
    Target.Free;
  end;
end;
Jak SubsetPdfDocumentFonts dowodzi dziedziny glifów CIDFonta?
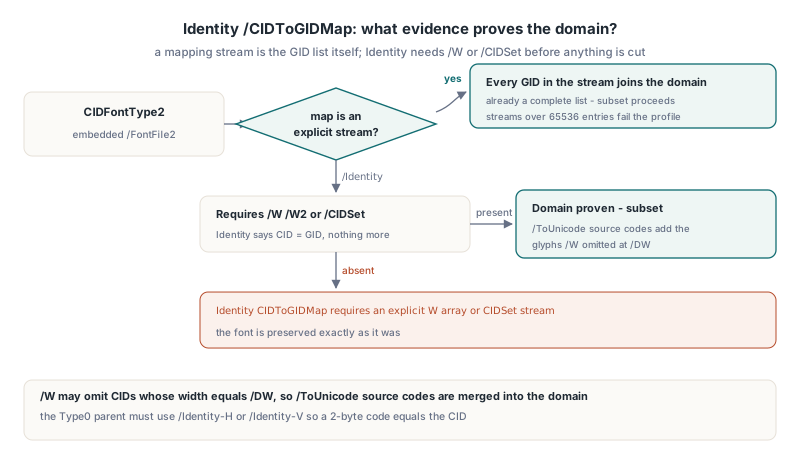
SubsetPdfDocumentFonts dowodzi dziedziny glifów fontu CIDFontType2 z jego mapowania CID-na-glif, a mapowanie rozstrzyga, ile dodatkowych dowodów trzeba. Jawny strumień /CIDToGIDMap (ISO 32000-1 §9.7.4.2) to już lista każdego glifu, jaki font może zaadresować, więc każdy GID w strumieniu wchodzi do dziedziny. Strumień mapowania większy niż 65536 wpisów albo o nieparzystej liczbie bajtów odrzuca ograniczony profil i font jest zachowywany
/CIDToGIDMap /Identity to trudny przypadek i zarazem najczęstszy w nowoczesnych plikach. Identity mówi, że CID równa się GID, co nie mówi ci nic o tym, jakich CID używa dokument. Komponent żąda więc dowodu pierwotnego: jawnej tablicy szerokości /W albo /W2 (§9.7.4.3), której wpisy CID znaczą glify, dla których producent zadeklarował metryki, albo strumienia /CIDSet w deskryptorze fontu (§9.8.3), bitmapy z jednym bitem na CID, najbardziej znaczącym bit pierwszym. Goły font Identity bez niczego z tego jest zachowywany z powodem Identity CIDToGIDMap requires an explicit W array or CIDSet stream
Pułapka w używaniu /W jako dowodu to /DW. Producent może pominąć każdy CID, którego szerokość równa się szerokości domyślnej, i dobrze zoptymalizowany writer robi dokładnie to dla najczęstszych szerokości glifów. Gdyby dziedzina przyszła z samego /W, te glify po cichu zniknęłyby z subsetu. Żeby zamknąć tę dziurę, komponent przechodzi przez każdy font Type0, którego /DescendantFonts wskazuje CIDFont, wymaga, by jego /Encoding było /Identity-H albo /Identity-V, żeby kod 2-bajtowy był CID, i wtapia kody źródłowe każdego wpisu beginbfchar i beginbfrange z jego CMap /ToUnicode (§9.10.3) do dziedziny. Jakiekolwiek inne kodowanie albo strumień /ToUnicode, którego nie da się zdekodować w budżecie, zachowuje font
Proste fonty TrueType: od Widths do identyfikatorów glifów
Jednobajtowe fonty /Subtype /TrueType są dowodzone przez swój zakres kodów i swoje kodowanie, a potem rozwiązywane do identyfikatorów glifów przez własny cmap programu fontu. Komponent wymaga 0 <= FirstChar <= LastChar <= 255 i tablicy /Widths o długości dokładnie LastChar - FirstChar + 1; krótka, długa albo nieliczbowa tablica znaczy, że dziedzina kodów nie jest udowodniona i font zostaje taki, jaki jest
Każdy kod w tym zakresie, plus każdy kod nazwany w /Differences albo pokryty przez /ToUnicode, jest potem mapowany tak, jak opisuje ISO 32000-1 §9.6.6. Kody pod /WinAnsiEncoding, /MacRomanEncoding albo /StandardEncoding idą przez pasującą tabelę do Unikodu. Nazwy glifów z /Differences są rozwiązywane przez Adobe Glyph List, nazwy uniXXXX i uXXXX, 258 standardowych nazw glifów Macintosh i własną tabelę nazw post formatu 2.0 fontu. Powstałe wartości są wyszukiwane w podtabelach cmap formatów 0, 4, 6 i 12, łącznie z Unicode (3,1), (3,10) i (0,*), Mac Roman (1,0) i Windows Symbol (3,0) pod F000 plus kod
Gdy font nie ma w ogóle kodowania bazowego, komponent znaczy unię każdej wiarygodnej interpretacji, zamiast zgadywać jedną. To trzyma kilka glifów, które pewnie są nieużyte, czyli błądzi we właściwą stronę. Przypadek przeciwny jest surowy: nazwa z /Differences, która nie mapuje się na żaden udowodniony identyfikator glifu, odrzuca cały font, bo jedna nierozwiązana nazwa znaczy, że dziedzina jest niekompletna
procedure ReportFontSubset(Source: TStream; Log: TStrings);
var
  Options: TPdfDocumentFontSubsetOptions;
  Report: TPdfDocumentFontSubsetReport;
  Output: TBytes;
  I: Integer;
begin
  Options := TPdfDocumentFontSubsetOptions.Default;
  Options.SubsetOptions.MinimumSavingPercent := 10;  // na font
  Options.MinimumDocumentSavingPercent := 5;         // cały plik
  if not SubsetPdfDocumentFonts(Source, Options, Output, Report) then
  begin
    Log.Add('Rejected: ' + Report.ErrorMessage);
    Exit;
  end;
  Log.Add(Format('Fonts %d, subset %d, preserved %d, glyphs %d',
    [Report.FontCount, Report.SubsetFontCount, Report.PreservedFontCount,
     Report.GlyphCount]));
  Log.Add(Format('Font bytes %d -> %d, file bytes %d -> %d',
    [Report.OriginalFontBytes, Report.SubsetFontBytes,
     Report.SourceByteCount, Report.OutputByteCount]));
  for I := 0 to High(Report.Issues) do
    Log.Add(Format('  object %d kept: %s',
      [Report.Issues[I].ObjectNumber, Report.Issues[I].Reason]));
end;
Czego SubsetPdfDocumentFonts nie rusza?
SubsetPdfDocumentFonts nie rusza każdego fontu, którego nie umie udowodnić, i zgłasza każdy z nich w Report.Issues z numerem obiektu i powodem, zamiast odrzucać dokument. Report.Complete jest True tylko, gdy żaden font nie został zachowany. Przypadki zachowane warto znać, zanim obiecasz redukcję rozmiaru:
- Programy Type 1
/FontFileoraz CFF albo OpenType/FontFile3, zgłaszane jakoOnly TrueType FontFile2 programs are supported - CIDFonty Identity bez
/W,/W2ani/CIDSetoraz CIDFonty bez strumienia mapowania i bez/Identity - Programy fontów referowane skądinąd niż z ich deskryptorów fontu i deskryptory współdzielone z konsumentem, który nie jest
CIDFontType2ani prostymTrueType - Fonty, których subset nie osiąga
SubsetOptions.MinimumSavingPercent, i każdy font, gdy przebudowany plik nie osiągaMinimumDocumentSavingPercent; w tym przypadkuReport.AppliedjestFalse, a wyjściem są pierwotne bajty
Dwa wejścia zawodzą kategorycznie, zamiast być zachowane. Podpisane dokumenty i dokumenty z polami podpisów są odrzucane, bo wymiana obiektów fontów unieważniłaby zakres bajtów każdego podpisu, a zaszyfrowane pliki potrzebują najpierw odszyfrowanego źródła. Udany przebieg zapisuje obiekty zamiennika jako rzadką aktualizację, a potem przebudowuje plik przez ten sam przebieg osiągalności, opisany w przewodniku po wycinaniu obiektów sierotach i deduplikacji zasobów, więc stare programy fontów nie przeżywają jako obiekty nieosiągalne, a wynikiem jest jedna czysta rewizja
Subsetowanie nowego tekstu w czasie zapisu przez saSubsetNewFonts
Fonty, które PDFium Component wbudowuje w bieżącej sesji, to osobny przypadek, obsługiwany przez opcję zapisu saSubsetNewFonts, a nie przez SubsetPdfDocumentFonts. saSubsetNewFonts mapuje się na flagę PDFium FPDF_SUBSET_NEW_FONTS, która puszcza natywny subseter HarfBuzz po fontach wczytanych z systemu przez natywne wywołania, jak TPdf.AddText, łącznie z odmianami OpenType CFF. Nadrzędny PDFium dalej znaczy tę flagę jako eksperymentalną. Nie dotyka fontów, które już były w pliku
var
  Pdf: TPdf;
begin
  Pdf := TPdf.Create(nil);
  try
    Pdf.CreateDocument;
    Pdf.AddPage(0, 595, 842);
    Pdf.AddText('Quarterly statement', 'Arial', 14, 72, 770, clBlack, $FF, 0.0);
    if not Pdf.SaveAs('statement.pdf', saSubsetNewFonts) then
      raise Exception.Create('Save failed');
  finally
    Pdf.Free;
  end;
end;
W sondzie komponentu dokument z tekstem Arial spadł z 590 KB do 22 KB pod saSubsetNewFonts, a ekstrakcja tekstu z zapisanego pliku wciąż zgadzała się dokładnie. Kolorowy font COLR v0, Segoe UI Emoji o 7,0 MB, przeszedł tą samą drogą do 10,5 KB, renderowany jako swoje kontury bazowe, bo PDF nie zna pojęcia warstw COLR. Fonty zmienne są wyjątkiem i blok siedzi przed subseterem: GDI GetFontData zwrócił 18,3 MB strumień zastępczy dla 1,85 MB pliku Segoe UI Variable i tworzenie obiektu tekstu zawiodło, zanim subsetowanie się zaczęło. przewodnik po wbudowywaniu fontów CID Type 2 z Delphi opisze ścieżkę wbudowania, którą te fonty przechodzą najpierw
Gdzie dowód się kończy
Dowód wewnątrz SubsetPdfDocumentFonts jest dokładnie tak mocny, jak metadane fontu, które zapisał producent. Identity CIDFont, którego dowodem jest samo /W, ma wciąż jedną ślepy plamę: glif, którego szerokość równa się /DW, który nie ma wpisu /ToUnicode i którego deskryptor nie wypisuje w /CIDSet. Takiego glifu nie da się udowodnić z zasobów, a komponent nie może wiedzieć, że istnieje, bez skanu strumieni treści, którego unika celowo. Producenci pomijający i /ToUnicode, i /CIDSet, przy kompresowaniu /W, są rzadcy, ale istnieją, więc dla archiwum od nieznanego generatora zrenderuj próbkę przed i po i porównaj piksele i wyciągnięty tekst
Przed puszczeniem partii pomaga też wiedzieć, z czym masz do czynienia. Podejście z czytania właściwości fontów PDF z PDFium Component mówi ci, które fonty w ogóle są wbudowane, a Report.Issues z suchego przebiegu mówi ci, które z nich będą zachowane i dlaczego. Domyślne opcje ograniczają też pracę: 1024 fonty, około milion glifów łącznie, 128 MB źródła i stały budżet pracy, z opcjonalnym CancellationToken dla długich zadań wsadowych
FAQ
Czy SubsetPdfDocumentFonts zmienia tekst albo układ PDF?
Nie. Pierwotne identyfikatory glifów, CID, szerokości i strumienie treści są trzymane, więc ekstrakcja tekstu i renderowanie używają tych samych glifów co wcześniej; usuwane są tylko nieosiągalne kontury, a nazwy fontów dostają nowy prefiks subsetu
Dlaczego wbudowany font nie został subsetowany?
Czytaj Report.Issues. Każdy zachowany font niesie powód, jak brakujące /W albo /CIDSet na Identity CIDFont, program nie-TrueType, zniekształconą tablicę /Widths albo oszczędność poniżej progu
Czy saSubsetNewFonts to to samo co SubsetPdfDocumentFonts?
Nie. saSubsetNewFonts robi subset fontów wbudowanych w bieżącej sesji przy zapisie, podczas gdy SubsetPdfDocumentFonts pracuje na istniejącym strumieniu PDF i wymienia fonty, które już wbudował inny producent
Subsetowanie fontów dokumentu, subsetowanie fontów w czasie zapisu i przebieg wycinania sierot stojący za nimi wszystkie są z PDFium Component for Delphi and C++Builder, które opakowuje PDFium dla projektów Delphi, C++Builder i Lazarus