Niepusty uchwyt dokumentu z liczbą stron równą zero to to, co FPDFAvail_GetDocument może oddać, gdy zawołano go na PDF-ie, który nigdy nie był zlinearyzowany — nawet po tym, jak FPDFAvail_IsDocAvail raportował PDF_DATA_AVAIL. Uchwyt wygląda na otwarty, nic nie narzeka, a przeglądarka pokazuje pusty dokument. API dostępności PDFium czyta zlinearyzowany układ Aneksu F ISO 32000-1; każdy inny plik musi być kompletny i otwierany zwykłą ścieżką własnego dokumentu. Ta decyzja o rozdzielaniu ruchu to połowa tego, w co wpisuje się otwieranie PDF-a w trakcie pobierania. Druga połowa to użytkownik, który zamyka kartę na ćwiartce pliku i chwilę później otwiera ten sam link ponownie
Pętla dostępności stojąca za TPdfProgressiveDocument
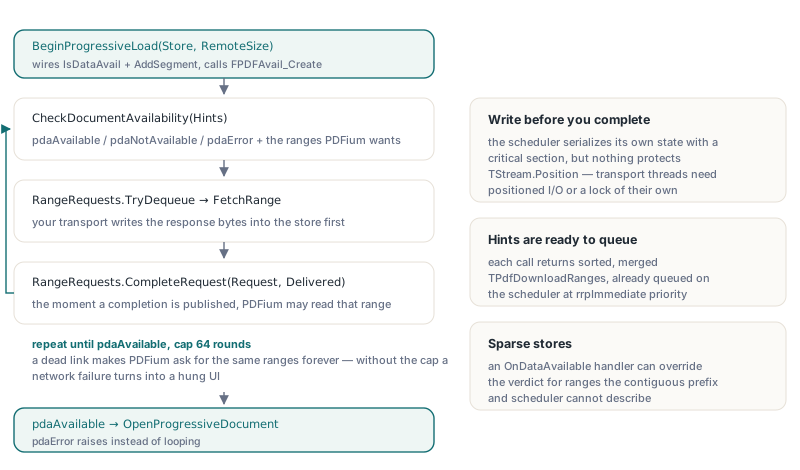
W PDFium Component cała sesja mieszka w TPdfProgressiveDocument, podklasie TPdf, która trzyma dostawcę dostępności PDFium przy życiu, dopóki strumień o dostępie swobodnym się zapełnia. BeginProgressiveLoad(AStream, AFileSize, AOwnsStream, AInitialAvailableByteCount) bierze strumień nośny i logiczny rozmiar zdalnego pliku (Content-Length, nie bieżącą długość twojego lokalnego magazynu), wpina callback IsDataAvail i callback AddSegment, i woła FPDFAvail_Create. Gdy OpenProgressiveDocument się uda, obiekt zachowuje się jak każdy inny aktywny TPdf: strony, tekst, renderowanie i zapis działają przez zwykłe człony
Każdy krok parsowania to pytanie do twojego kodu. Gdy PDFium chce zakresu, komponent odpowiada tak, jeśli zakres leży w ciągłym prefiksie opisanym przez AvailableByteCount albo w zakresie już dokończonym przez scheduler RangeRequests. Handler OnDataAvailable dostaje potem ostatnie słowo — tak odpowiada rozproszony cache za zakresy, których żadno z tamtych nie opisze. CheckDocumentAvailability zwraca jedną z trzech wartości TPdfDataAvailability (pdaAvailable, pdaNotAvailable, pdaError) i oddaje zakresy bajtów, o które pytał PDFium, jako posortowaną, scaloną tablicę TPdfDownloadRanges. Te zakresy są już wkolejkowane na schedulerze z priorytetem rrpImmediate, zanim je zobaczysz, więc tablica podpowiedzi służy do logowania i wyświetlania postępu; kolejka robocza to RangeRequests
// FetchRange to twój transport (HTTP Range GET, gniazdo, czytnik blobów):
// zapisuje Size bajtów w Offset do Store i zwraca, ile dotarło
function FetchRange(Store: TStream; Offset, Size: UInt64): UInt64; forward;

procedure OpenWhileDownloading(Pdf: TPdfProgressiveDocument; Store: TStream;
  RemoteSize: UInt64);
const
  MaxRounds = 64;
var
  Hints: TPdfDownloadRanges;
  State: TPdfDataAvailability;
  Request: TPdfRangeRequest;
  Round: Integer;
begin
  Pdf.BeginProgressiveLoad(Store, RemoteSize, False);
  State := pdaNotAvailable;
  for Round := 1 to MaxRounds do
  begin
    State := Pdf.CheckDocumentAvailability(Hints);
    if State <> pdaNotAvailable then
      Break;
    // Podpowiedzi są już wkolejkowane; najpierw zapisz bajty, potem dokończ
    while Pdf.RangeRequests.TryDequeue(Request) do
      Pdf.RangeRequests.CompleteRequest(Request,
        FetchRange(Store, Request.Offset, Request.Size));
  end;
  if State <> pdaAvailable then
    raise EPdfError.Create('The document could not be discovered');
  Pdf.OpenProgressiveDocument;
end;
Dwa detale w tej pętli dźwigają całość. Limit rund ma znaczenie, bo martwy link każe CheckDocumentAvailability pytać o te same zakresy w nieskończoność, a nieograniczona pętla zamienia awarię sieci w zawieszony UI. Kolejność ma znaczenie, bo scheduler serializuje swój stan sekcją krytyczną, ale nic nie robi dla TStream.Position na magazynie nośnym: wątek transportowy musi zapisać bajty odpowiedzi do strumienia przed wołaniem CompleteRequest, bo w chwili opublikowania dokończenia PDFium może ten zakres przeczytać, a współbieżni pisarze potrzebują I/O pozycjonowanego albo własnej blokady
Dlaczego AvailableByteCount odmawia ruchu do tyłu?
AvailableByteCount tylko rośnie. Przypisanie mniejszej wartości podnosi EPdfError z komunikatem „Available byte count cannot move backwards", bo skoro callback dostępności powiedział już PDFium, że zakres istnieje, parser mógł już z niego przeczytać i zcache'ować obiekty. Zabranie tych bajtów później zostawiłoby PDFium z obiektami, których źródła odpowiedzi dostępności teraz zaprzeczają. Ten sam setter odrzuca wartości większe niż LogicalFileSize i podnosi „No progressive load is active" poza sesją
Ten ostatni sprawdzian rozstrzyga, gdzie należą bajty, które już masz. Jeśli poprzednia wizyta zostawiła pierwsze 300 KB pliku w cache, podaj tę liczbę jako AInitialAvailableByteCount; komponent odnotowuje ją, zanim ruszy FPDFAvail_Create, więc pierwszy rzut oka PDFium na nagłówek już ją widzi. Przy początkowej liczbie zero Linearization czyta plnUnknown, aż PDFium zobaczy nagłówek; to normalny stan startowy
Podniesienie prefiksu anuluje też pracę. Każde lecące żądanie nachodzące na świeżo ogłoszone bajty jest teraz redundantne, więc scheduler je zrzuca i odpala dla niego OnCancelRequest; spóźnione CompleteRequest dla tego żądania zwraca False. Magazyn zapełniający się nie po kolei nie powinien w ogóle próbować wyrażać się przez prefiks. Dokańczaj zakresy przez scheduler albo odpowiadaj per zakres w OnDataAvailable. Wyjątek podniesiony wewnątrz tego handlera nie przetnie granicy callbacka C, więc komponent go łapie i raportuje zakres jako brakujący, a PDFium po prostu pyta ponownie przy następnym sprawdzianie
Kiedy częściowo pobrany PDF faktycznie się otworzy?
Tylko zlinearyzowany PDF otwiera się, zanim przybędzie cały plik. OpenProgressiveDocument sprawdza właściwość Linearization (plnUnknown, plnNotLinearized, plnLinearized) i wybiera loadera. Zlinearyzowany plik otwiera przez FPDFAvail_GetDocument, jak tylko sekcja pierwszej strony i tabele podpowiedzi są obecne. Niezlinearyzowany plik idzie przez FPDF_LoadCustomDocument na tym samym rekordzie dostępu do pliku, i dla takiego pliku PDFium raportuje dokument jako dostępny dopiero, gdy jest tam każdy bajt. To rozdzielanie ruchu trzyma niepusty uchwyt z zerem stron z akapitu otwierającego z dala od twojej przeglądarki
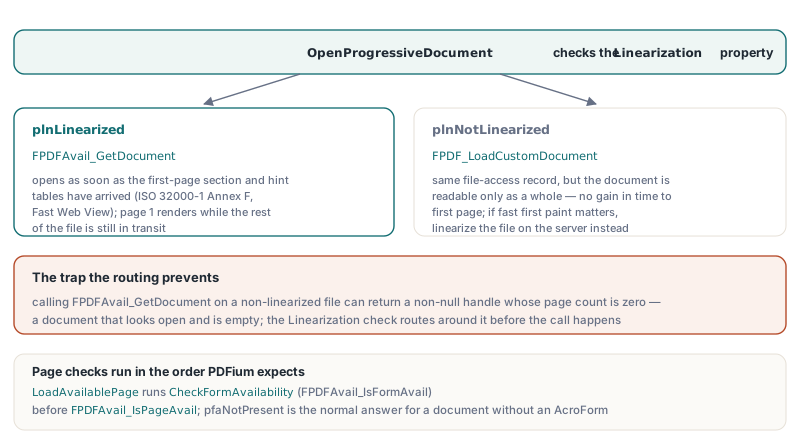
Plik na serwerze rozstrzyga więc, jak szybko pojawi się pierwsza strona. Jeśli czas do pierwszego kadru się liczy, a kontrolujesz stronę publikującą, linearyzuj pliki tam. TPdf.SaveAsLinearized zapisuje układ Aneksu F prosto z komponentu, a przewodnik po Fast Web View i tabelach podpowiedzi omawia, co ten układ zawiera. Dla plików, których nie kontrolujesz, niezlinearyzowany PDF nadal ładuje się przez tę samą pętlę; dochodzi po prostu do pdaAvailable przy 100 procentach zamiast wcześnie
LoadAvailablePage bierze numer strony liczony od 1 i trzyma kolejność, jakiej oczekuje PDFium. Przed pierwszą kontrolą strony biegnie CheckFormAvailability, które owija FPDFAvail_IsFormAvail, i dopiero potem woła FPDFAvail_IsPageAvail. Wynik pfaNotPresent to normalna odpowiedź dla dokumentu bez AcroForm i niczego nie blokuje. Gdy strona jest gotowa, LoadAvailablePage czyni ją aktywną stroną, więc przeglądarka może renderować stronę 1 zlinearyzowanej broszury, podczas gdy późniejsze strony są jeszcze w drodze. Czekanie na stronę ma ten sam kształt co pierwszy listing: wołaj LoadAvailablePage, opróżniaj RangeRequests przy pdaNotAvailable, zatrzymuj się na pdaAvailable albo pdaError i trzymaj limit rund. FirstAvailablePageNumber raportuje stronę, którą słownik linearyzacji desygnuje jako pierwszą, już przeliczone z indeksu PDFium liczonego od zera. Dla niezlinearyzowanego pliku każda strona raportuje od razu pdaAvailable, bo dokument mógł się otworzyć tylko, gdy plik był kompletny
Ponowienia, krótkie odczyty i priorytety w schedulerze zakresów
API FPDFAvail_* samo nie wie nic o sieciach. Mówi, jakich bajtów parser potrzebuje akurat, i pyta ponownie później; nie ma pojęcia żądania, ponowienia ani cancelu. TPdfRangeRequestScheduler dostarcza tych pojęć, a cztery z jego reguł kształtują to, jak piszesz transport
- Krótka odpowiedź jest traktowana jako postęp.
CompleteRequest(Request, BytesReceived)z mniejszą liczbą bajtów niż żądano publikuje prefiks i kolejkuje resztę. Krótka odpowiedź liczy się też jako nieudana próba, więc reszta jest nadal związanaMaxRetryCounti zostaje porzucona, gdy ten się wyczerpie; zero bajtów to zwykła nieudana próba MaxRetryCountdomyślnie wynosi 2, więc jeden zakres dostaje trzy próby łącznie.FailRequestzwracaTrue, gdy wkolejkuje zakres ponownie, iFalse, gdy zakres został porzucony;Statistics.AbandonedRequestCountśledzi, ile ich się poddałoMaxRequestSizerozdziela duże zakresy na kawałki w czasie zdejmowania z kolejki, aMergeGappozwala dwom oczekującym zakresom scalić się przez małą nieznaną lukę, ale nigdy przez bajty już dokończone albo lecące- Podpowiedzi z
CheckDocumentAvailabilityiLoadAvailablePageprzychodzą zrrpImmediate. Podpowiedzi formularza z bezpośredniego wywołaniaCheckFormAvailabilityprzychodzą zrrpNormal; gdyLoadAvailablePagerobi ten sprawdzian sama, a dane formularza są nieobecne, podpowiedzi są kolejkowane zrrpImmediate.TryDequeueobsługuje zawsze najpierw najwyższy priorytet i najniższy offset w obrębie priorytetu
Reguła priorytetów opłaca się przy prefetchu. Kolejkuj cały plik z rrpBackground tuż po otwarciu dokumentu, a scheduler odejmie wszystko już dokończone albo lecące, więc na łącze idą tylko brakujące bajty. Gdy użytkownik skoczy potem na stronę 40, a podpowiedź tej strony nachodzi na lecący już backgroundowy kawałek, scheduler wyciąga żądanie backgroundowe, odpala dla niego OnCancelRequest, niezachodzące ogony wrzuca z powrotem z priorytetem backgroundowym bez liczenia im ponowienia, a pokrycie kolejkuje jako świeżą pracę immediate. Skok wygrywa połączenie. Bez tego żądanie strony czekałoby za kawałkiem 256 KB, którego nie obchodzi
procedure TDownloadForm.QueueRestOfFile;
var
  Whole: TPdfDownloadRanges;
begin
  FPdf.RangeRequests.MaxRequestSize := 256 * 1024;  // rozmiar kawałka to twoja decyzja
  SetLength(Whole, 1);
  Whole[0].Offset := 0;
  Whole[0].Size := FPdf.LogicalFileSize;
  FPdf.RangeRequests.EnqueueHints(Whole, rrpBackground);
end;

// Wołane na wątku roboczym, gdy kończy się jedna odpowiedź HTTP Range.
// WriteAt to twój własny pozycjonowany zapis do magazynu nośnego
procedure TDownloadForm.RangeFinished(const Request: TPdfRangeRequest;
  const Body: TBytes; Succeeded: Boolean);
begin
  if Succeeded and (Length(Body) > 0) then
  begin
    WriteAt(FStore, Request.Offset, Body);              // najpierw bajty
    FPdf.RangeRequests.CompleteRequest(Request, Length(Body));
  end
  else if not FPdf.RangeRequests.FailRequest(Request) then
    TThread.Queue(nil, ShowRangeGaveUp);  // porzucone, albo z anulowanej sesji
end;
Zarówno CompleteRequest, jak i FailRequest wolno wołać z wątku roboczego; scheduler bierze własną blokadę. Żądanie zastąpione albo należące do anulowanej sesji wraca jako False bez dotykania czegokolwiek, więc worker nie musi wiedzieć, dlaczego jego zakres stał się nieaktualny
Co zwalnia CancelProgressiveLoad i w jakiej kolejności?
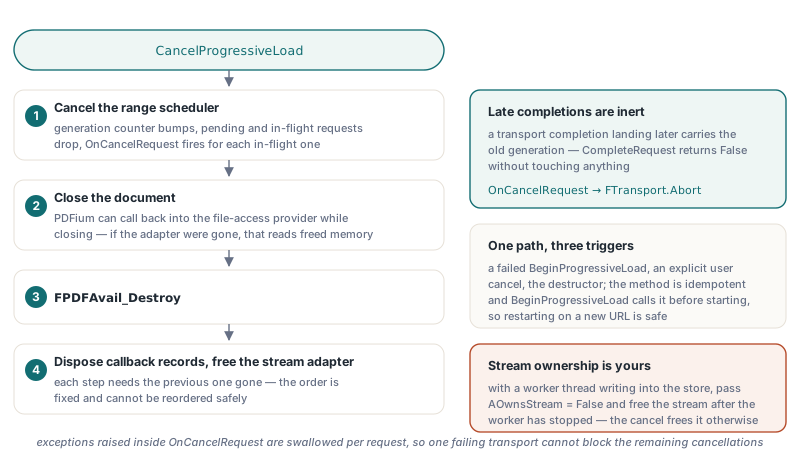
CancelProgressiveLoad rozbiera sesję w czterech krokach, zawsze w tej samej kolejności: anuluj scheduler zakresów, zamknij dokument, zniszcz uchwyt dostępności przez FPDFAvail_Destroy, potem zwolnij rekordy callbacków i adapter strumienia. Anulowanie schedulera najpierw podbija jego licznik generacji, zrzuca każde oczekujące i lecące żądanie i odpala OnCancelRequest dla każdego lecącego. Dokończenie transportowe, które wyląduje potem, niesie starą generację, a CompleteRequest zwraca False. Dokument zamyka się, zanim odejdą uchwyt dostępności i adapter strumienia, bo PDFium może w trakcie zamykania dokumentu wciąż czytać przez dostawcę dostępu do pliku
procedure TDownloadForm.FormCreate(Sender: TObject);
begin
  FPdf := TPdfProgressiveDocument.Create(nil);
  // Scheduler żyje tak długo jak FPdf, więc wpnij go raz
  FPdf.RangeRequests.OnCancelRequest := RangeCancelled;
end;

procedure TDownloadForm.RangeCancelled(Sender: TObject; RequestId: UInt64;
  Attempt: Cardinal);
begin
  FTransport.Abort(RequestId);   // twój kod: zamknij to gniazdo albo żądanie
end;

procedure TDownloadForm.CancelButtonClick(Sender: TObject);
begin
  FPdf.CancelProgressiveLoad;
  // ProgressiveLoading = False, Active = False, AvailableByteCount = 0
end;
Metoda jest idempotentna i służy jako jedyna ścieżka sprzątania dla trzech sytuacji: BeginProgressiveLoad, które pada w połowie konstrukcji, jawnego cancelu użytkownika i destruktora. BeginProgressiveLoad woła ją też, więc ponowny start tego samego obiektu na nowym URL-u jest w porządku, póki wcześniejsza sesja nie doszła do otwarcia. Gdy OpenProgressiveDocument już się udało, obiekt jest aktywny, a BeginProgressiveLoad podnosi zwykły błąd „Cannot perform this operation on an active"; zawołaj najpierw CancelProgressiveLoad. OnCancelRequest to też jedyne miejsce, gdzie twoje gniazda się zamykają, skoro scheduler nie ma pojęcia, czym jest gniazdo. Wyjątki podniesione wewnątrz niego są połykane per żądanie, więc jedno padające przerwanie nie może zablokować reszty
Kto pisze do magazynu, rozstrzyga, kto go posiada. Przy wątku roboczym piszącym do strumienia nośnego podaj AOwnsStream = False i zwolnij strumień sam, po zatrzymaniu workera. Przekazanie własności znaczy, że cancel zwalnia strumień, podczas gdy zapis już w toku może wciąż być w drodze. Trzymaj własność zawsze, gdy magazyn dotyka wątek inny niż wołający; AOwnsStream = True pasuje tylko do w pełni synchronicznego transportu jak w pierwszym listingu
Funkcje, które czekają na cały plik
Niektóre funkcje potrzebują oryginalnych bajtów pliku, nie sparsowanego dokumentu, i odmawiają niekompletnego źródła przyrostowego z marszu. ReadXmpPacket podnosi „PDF/A metadata is unavailable until progressive loading completes". ValidatePades zwraca wynik, którego SourceStatus to pvssIncomplete, a ValidatePdfMac raportuje niewspierane z komunikatem proszącym o kompletny plik źródłowy. BeginIncrementalSave też zawodzi, bo aktualizacja przyrostowa musi dokleić się do dokładnych bajtów, które zostały wczytane
Sprawdzianem kompletności za nimi wszystkimi jest AvailableByteCount dochodzące do LogicalFileSize. Transport dostarczający wszystko przez scheduler może więc trzymać każdy bajt i nadal zostać poinformowany, że źródło jest niekompletne, bo ciągły prefiks nigdy się nie ruszył. Opublikuj prefiks, gdy scheduler potwierdzi pełne pokrycie:
procedure TDownloadForm.CheckSignaturesWhenComplete;
var
  Report: TPadesValidationResult;
begin
  if FPdf.RangeRequests.IsRangeAvailable(0, FPdf.LogicalFileSize) then
    FPdf.AvailableByteCount := FPdf.LogicalFileSize;
  Report := FPdf.ValidatePades;
  if Report.SourceStatus = pvssIncomplete then
    LabelStatus.Caption := 'Signatures are checked when the download finishes'
  else
    ShowSignatureReport(Report);   // twoje UI
end;
Jeden limit rozmiaru obowiązuje, zanim cokolwiek z tego ruszy. Na Windows FPDF_FILEACCESS trzyma długość pliku w polu 32-bitowym, więc BeginProgressiveLoad odrzuca logiczny rozmiar powyżej 4 GiB przez EPdfError, zamiast pozwolić PDFium parsować uciętą długość
Ładowanie kompletnego lokalnego pliku na żądanie przez adapter strumienia opisuje strumieniowanie dużych PDF-ów na żądanie z PDFium; dla PDF-a siedzącego w większym buforze patrz ładowanie zakresów bajtów dla osadzonych PDF-ów. Zatrzymanie powolnego renderu strony, która już przybyła, to osobny mechanizm — omawia go anulowalne przyrostowe renderowanie stron. TPdfProgressiveDocument, jego scheduler zakresów i SaveAsLinearized są częścią PDFium Component dla Delphi i C++Buildera