Przy wyłączonym sprawdzaniu przepełnienia 2000000000 + 2000000000 daje -294 967 296, gdy oba operandy to wartości Integer Delphi. Ta liczba przestaje być ciekawostką w chwili, gdy parser kontenera czyta z nagłówka rekordu offset i długość i dodaje je, żeby sprawdzić, czy osadzony PDF mieści się w buforze. Suma zawija na ujemną, porównanie z Length(Data) przechodzi, a następna linia bierze adres bajtu mniej więcej dwa gigabajty za końcem tablicy. Wczytywanie PDF ze środka większego buforu potrzebuje sprawdzenia zakresu, które nigdy nie dodaje, i jasnej odpowiedzi, kto jest właścicielem bajtów, gdy dokument jest już otwarty
Ten artykuł dotyczy dokumentów już obecnych w RAM, siedzących pod znanym offsetem wewnątrz czegoś innego. Dokumenty za duże, by trzymać je w pamięci, to inny problem, obsłużony przez dociąganie bloków z dysku na żądanie, jak opisuje strumieniowanie dużych PDF-ów na żądanie z PDFium VCL. Ostatnia sekcja rysuje granicę
Osadzony PDF pod znanym offsetem
Magazyn poczty trzyma treści wiadomości i załączniki w jednym rekordzie. Kontener archiwum skleja manifest, kilka obrazów i PDF. Własny protokół komunikacyjny ramkuje dokument za nagłówkiem z prefiksem długości. Przyjmij, że rekord ma 40 MB, PDF zaczyna się na bajcie 1 182 336 i biegnie przez 312 KB. Odruchowy kod woła Copy(Data, Index, Count), żeby wyciąć wycinek, a potem oddaje ten wycinek loaderowi, który kopiuje go jeszcze raz do własnego bufora. Licząc kontener, te same 312 KB istnieją teraz trzy razy, a skanowanie skrzynki powtarza to dla każdej wiadomości
PDFium Component adresuje okno bezpośrednio. TPdf deklaruje LoadDocument(const Data: TBytes; Index, Count: Integer; Buffered: Boolean = True), gdzie Index to pozycja bajtu liczona od zera, a Count to długość w bajtach. Metoda waliduje obie liczby, wylicza jeden wskaźnik i przekazuje do przeciążenia wskaźnikowego LoadDocument(Data: Pointer; Size: NativeUInt; Buffered: Boolean), które otwiera dokument przez FPDF_LoadMemDocument64. Forma całotablicowa LoadDocument(const Data: TBytes; Buffered: Boolean) to jednoelementowe wywołanie formy zakresu bajtów z 0 i Length(Data), więc każde wczytanie TBytes przechodzi przez tę samą walidację
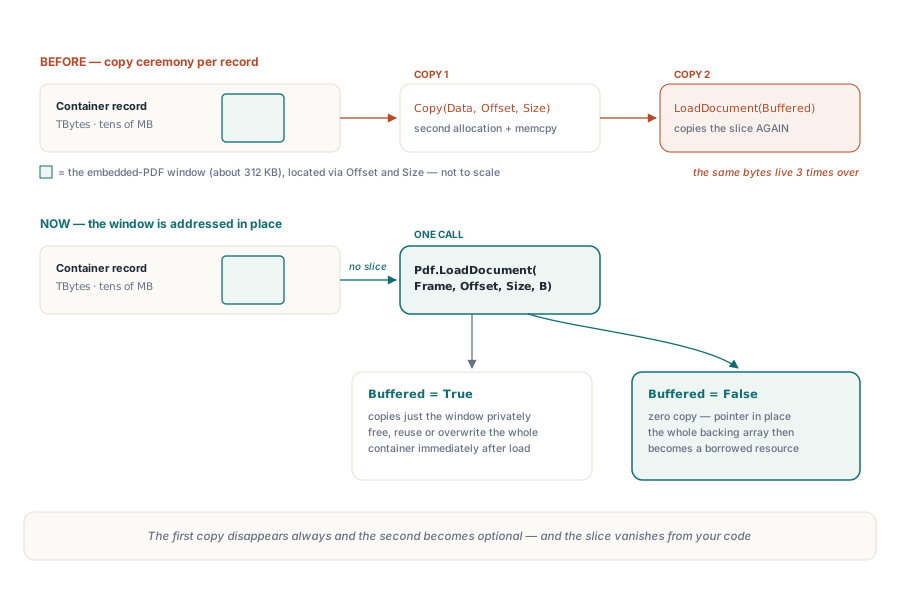
W kodzie wycinek po prostu znika. LocateEmbeddedPdf stoi za twój własny parser kontenera
uses
  System.SysUtils, System.IOUtils, PDFium;

procedure PreviewEmbedded(const RecordFile: string);
var
  Frame: TBytes;           // cały rekord kontenera, dziesiątki megabajtów
  Offset, Size: Integer;
  Pdf: TPdf;
begin
  Frame := TFile.ReadAllBytes(RecordFile);
  LocateEmbeddedPdf(Frame, Offset, Size);   // twój parser, nie część komponentu

  Pdf := TPdf.Create(nil);
  try
    // Bez Copy(Frame, Offset, Size): okno jest adresowane w miejscu
    Pdf.LoadDocument(Frame, Offset, Size);  // Buffered domyślnie ma wartość True
    Frame := nil;  // tu w porządku: skopiowano tylko okno PDF
    Writeln('Pages: ', Pdf.PageCount);
  finally
    Pdf.Free;      // zamyka dokument
  end;
end;
Gdy globalne EnableV8Engine jest wciąż False, a biblioteka PDFium nie została jeszcze wczytana, loadery pamięciowe skanują przychodzące bajty pod kątem znaczników XFA i włączają EnableV8Engine, jeśli coś znajdą, żeby DLL z obsługą V8 został załadowany. Przy wywołaniu zakresu bajtów skan widzi tylko okno. Manifest albo drugi dokument gdzie indziej w tym samym rekordzie nie mogą go wyzwolić
Dlaczego Index plus Count przepełnia sprawdzenie granic?
Ponieważ Index i Count to obie 32-bitowe znakowane Integer, a dodanie dwóch dużych dodatnich nie zawsze niezawodnie daje duży dodatni wynik. Tam, gdzie offset i długość pochodzą z nagłówka pliku, obiema steruje atakujący albo uszkodzony rekord. Ta sama pułapka czeka w twoim własnym parserze kontenera, który te liczby wylicza najpierw
// Pomocnik dla twojego własnego parsera kontenera (sugestia, nie część komponentu)
function IsValidWindow(const Data: TBytes; Index, Count: Integer): Boolean;
begin
  // ŹLE: Index + Count jest liczone jako Integer i może zawinąć na ujemną
  //   Result := (Index >= 0) and (Index + Count <= Length(Data));

  // DOBRZE: odrzuć znaki, ogranicz Index osobno, potem porównaj Count
  // z resztą; jedyna arytmetyka to odejmowanie, które nie zawija
  Result := (Index >= 0) and (Count >= 0) and
            (Index <= Length(Data)) and
            (Count <= Length(Data) - Index);
end;
Prześledź przypadek zawodzący. Przy Index = 2000000000 i Count = 2000000000 prawdziwa suma to cztery miliardy, ale arytmetyka 32-bitowa ze znakiem przechowuje ją jako -294 967 296. Ta wartość jest wygodnie poniżej każdego Length(Data), więc błędna kontrola przechodzi i @Data[Index] wskazuje daleko poza tablicę, z dołączoną długością dwóch gigabajtów. Awaria to dobry wynik. Zły to PDFium parsujące cokolwiek pamięci procesu akurat tam siedzi
Prawidłowa kolejność nigdy nie dodaje. Wartości ujemne są odrzucane, zanim cokolwiek zostanie indeksowane. Potem Index jest ograniczany względem samego Length(Data), co gwarantuje, że Length(Data) - Index to nieujemne Integer, i dopiero wtedy Count jest porównywany z tą resztą. Delphi ewaluuje and z logiką zwarcia domyślnie ({$B-}), więc każdy późniejszy człon rusza dopiero, gdy wcześniejsze trzymają. Nie opieraj się na {$Q+} jako siatce bezpieczeństwa: buildy release zwykle wychodzą z wyłączonym sprawdzaniem przepełnienia, a przy włączonym tylko zamieniłeś dziurę w bezpieczeństwie pamięci na EIntOverflow uciekający ze środka procedury walidacji
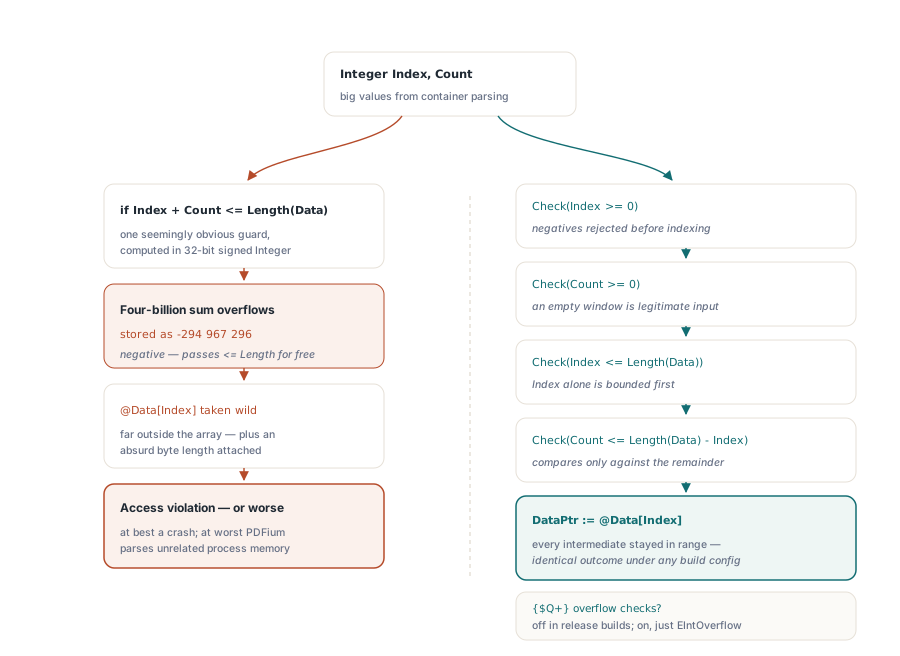
LoadDocument zakresu bajtów wykonuje te same cztery testy w tej samej kolejności i rzuca EPdfError z komunikatem nazywającym złamaną regułę: "PDF byte range index cannot be negative", "PDF byte range count cannot be negative", "PDF byte range index exceeds data length" i "PDF byte range exceeds data length". Każdy z nich możesz odtworzyć na tablicy czterech bajtów. Index = 5, Count = 0 łapie trzeci komunikat, Index = 2, Count = 3 czwarty, a po każdym odrzuceniu Pdf.Active jest wciąż False. Takie samo traktowanie niezaufanych długości przez granicę natywną omawia szerzej utwardzanie ABI i bezpieczeństwa pamięci PDFium VCL w Delphi
Okno o zerowej długości to nadal legalne wywołanie
Puste okno przekazuje wskaźnik nil, bo @Data[Index] nie jest wyrażeniem prawnym dla każdego Index, który akceptuje walidacja. Index = Length(Data) przy Count = 0 to dobrze uformowane puste okno na końcu bufora, a puste TBytes daje Index = 0 na tablicy, która nie ma elementu zero. Wzięcie adresu w każdym z tych przypadków czyta za końcem albo wyłuskuje nil z dynamicznej tablicy, a przy włączonym sprawdzaniu zakresów Delphi rzuca ERangeError, zanim loader w ogóle ruszy
Dlatego przeciążenie zakresu bajtów rozgałęzia się: Count = 0 daje nil, każda inna liczba daje @Data[Index]. Przeciążenie wskaźnikowe akceptuje nil tylko razem z rozmiarem zero, PDFium odmawia wtedy otwarcia pustego bufora, a wywołanie kończy się zwykłym EPdfError z ostatnim komunikatem błędu PDFium, albo "Cannot load PDF document", gdy PDFium nic nie zgłasza. Nagłówek twierdzący o załączniku o zeru bajtów dostaje ten sam łapalny wyjątek co każde inne złe wejście. Odrzucenie go w twoim parserze, z numerem rekordu w komunikacie, nadal lepiej wygląda w logu wsparcia
Buffered decyduje, kto jest właścicielem bajtów
Buffered to jedyny parametr tutaj, którego konsekwencje przeżywają wywołanie. Przy Buffered = True komponent kopiuje wybrane okno, i tylko okno, do własnego bufora przed wczytaniem. W przykładzie 40 MB kopiowane jest 312 KB, a kontener zostaje nietknięty. Gdy LoadDocument wróci, możesz zwolnić, wykorzystać ponownie albo nadpisać kontener od razu
Przy Buffered = False @Data[Index] idzie prosto do FPDF_LoadMemDocument64, a PDFium czyta dalej przez ten wskaźnik, dopóki dokument jest otwarty. Cała tablica TBytes stojąca za nim staje się pożyczona. Musi pozostać żywa i niemodyfikowana, dopóki nie ustawisz Active := False albo nie zwolnisz TPdf. Liczy się cała tablica, nie tylko okno: dynamiczna tablica Delphi jest zliczana referencyjnie jako jeden blok, więc upuszczenie ostatniej referencji gdziekolwiek w twoim kodzie zwalnia pamięć, którą PDFium właśnie czyta. SetLength jest równie zabójcze. Realokacja może przesunąć blok
Dwa szczegóły Delphi czynią to łatwiejszym do zepsucia, niż wygląda. Dynamiczne tablice nie mają copy-on-write, w przeciwieństwie do stringów, więc Other := FFrame; Other[0] := 0; pisze do tych samych bajtów, które PDFium parsuje. A bufor odbiorczy, który twój kod sieciowy ponownie używa do następnej ramki, zostaje nadpisany pod otwartym dokumentem. Przekazanie wyniku funkcji prosto w wywołaniu, jak w Pdf.LoadDocument(ReadRecord(Id), Offset, Size, False), zostawia tablicę trzymaną tylko przez ukrytą zmienną tymczasową, która umiera z wywołującą procedurą, podczas gdy dokument żyje dalej
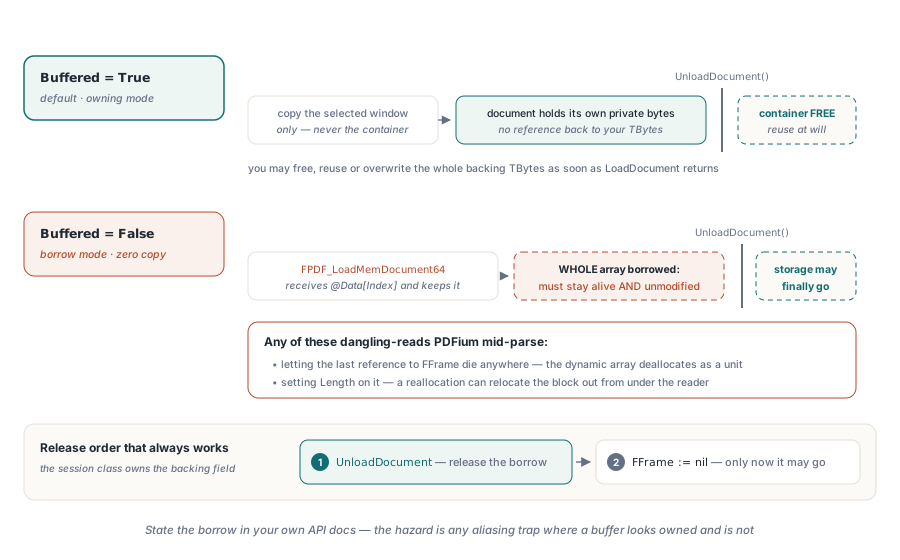
Zostaw Buffered = True dla wszystkiego, co przekracza wątek, siedzi za buforem wielokrotnego użytku albo przeżywa procedurę, która go wczytała. Dodatkowy koszt to jedna kopia własnego rozmiaru PDF-a, a kupuje wolność wyrzucenia rekordu 40 MB w chwili, gdy wywołanie wróci. Pożyczanie zdobywa swoje miejsce tylko wtedy, gdy kontener jest już długowiecznym polem, które trzymasz i tak przez całą sesję, na przykład przeglądarka trzymająca otwarty rekord archiwum, podczas gdy użytkownik kartkuje załącznik. W takim przypadku wyraź własność w jednej klasie
type
  TFrameSession = class
  private
    FFrame: TBytes;   // jest właścicielem magazynu, dopóki FPdf ma otwarty dokument
    FPdf: TPdf;
  public
    constructor Create(const AFrame: TBytes);
    destructor Destroy; override;
    procedure OpenEmbedded(Offset, Size: Integer);
  end;

constructor TFrameSession.Create(const AFrame: TBytes);
begin
  inherited Create;
  FFrame := AFrame;   // współdzieli tablicę; nikt inny nie może już w nią pisać
  FPdf := TPdf.Create(nil);
end;

procedure TFrameSession.OpenEmbedded(Offset, Size: Integer);
begin
  FPdf.Active := False;                            // najpierw zamknij ewentualne wcześniejsze okno
  FPdf.LoadDocument(FFrame, Offset, Size, False);  // FFrame musi przeżyć ten dokument
end;

destructor TFrameSession.Destroy;
begin
  FPdf.Active := False;  // 1. oddaj pożyczkę
  FPdf.Free;
  FFrame := nil;         // 2. dopiero teraz magazyn może odejść
  inherited;
end;
Konstruktor współdzieli tablicę wywołującego zamiast ją kopiować, więc wywołujący musi przestać do niej pisać. Jeśli nie możesz tego obiecać, przekaż konstruktorowi Copy(AFrame) i wracasz do jednej kopii, robionej raz na sesję zamiast raz na wczytanie
Sprawdzanie, że okno zaczyna się od %PDF-
Okno o kilkabajtach za duże to subtelne zawodzenie, bo dokument może się nadal otworzyć. ISO 32000-1 §7.5.4 definiuje każdy wpis tablicy odsyłaczy jako offset bajtu od początku pliku, a §7.5.2 każe nagłówkowi %PDF- siedzieć na starcie. Gdy twój parser błędnie policzy prefiks i okno zaczyna się osiem bajtów za wcześnie, te offsety są o osiem bajtów złe. PDFium szuka nagłówka w pierwszych 1024 bajtach i kompensuje śmieci wiodące; okno, które zaczyna się za późno albo kończy za wcześnie, może pchnąć go do przebudowy tablicy odsyłaczy ze znalezionych markerów obiektów. W obu przypadkach liczba stron wygląda dobrze. Offset w twoim parserze jest nadal zły, a następny czytelnik tego rekordu może być mniej wyrozumiały
Przeciążenie LoadDocument(const Data: TBytes; Index, Count: Integer; const Options: TPdfLoadOptions; out Report: TPdfLoadReport; Buffered: Boolean = True) robi to widocznym. Report.HeaderOffset to miejsce, gdzie znaleziono %PDF- w pierwszych 1024 bajtach okna, albo -1, gdy nie znaleziono. Report.UsedRecovery jest True, gdy PDFium nie przyjął tablicy odsyłaczy jako ważnej. Wszystkie offsety w raporcie liczą się od pierwszego bajtu okna, nie od kontenera. Zbyt krótkie Count odcina końcowe %%EOF, a TPdfLoadOptions.Default(plmStrict) włącza RequireFinalEndOfFileMarker, więc tryb ścisły odrzuca takie okno wprost
var
  Options: TPdfLoadOptions;
  Report: TPdfLoadReport;
begin
  Options := TPdfLoadOptions.Default;   // plmCompatible
  Pdf.LoadDocument(Frame, Offset, Size, Options, Report, True);

  // LogWarning to twoja własna procedura logowania
  if Report.HeaderOffset > 0 then
    LogWarning(Format('Window starts %d bytes before %%PDF-, check Offset',
      [Report.HeaderOffset]))
  else if Report.HeaderOffset < 0 then
    LogWarning('No %PDF- header in the first 1024 bytes of the window');

  if Report.UsedRecovery then
    LogWarning('Cross-reference table was rebuilt, check Offset and Size');
end;
Audyt za tymi polami ma koszt, który ma znaczenie dla wczytań pożyczonych. Gdy okno mieści się w Options.AuditByteLimit (domyślnie 256 MB), audyt czyta tymczasową kopię okna, więc Buffered = False w połączeniu z raportem przestaje być wolne od kopiowania na czas wczytania. Ustawienie AuditByteLimit na 0 pomija audyt i kopię i zostawia HeaderOffset na -1. Uruchamiaj formę z audytem, gdy rozwijasz parser kontenera i wobec nowych źródeł rekordów; przełącz na zwykłe przeciążenie, gdy offsety są już zaufane. Resztę raportu omawia łapanie niepowodzeń wczytania PDF raportem PDFium
Kiedy zakres bajtów to złe narzędzie
Przeciążenie zakresu bajtów zakłada, że cały kontener jest już w pamięci, a ponieważ Count to Integer, jedno okno nie może przekroczyć MaxInt bajtów. Archiwum 6 GB na dysku albo gniazdo, którego nie da się przewinąć, nie pasuje do tego kształtu, a wczytanie wszystkiego do TBytes tylko po to, by adresować w tym okno, bije po celu. Dla tych przypadków LoadCustomDocument(AStream: TStream; AOwnsStream: Boolean) pozwala PDFium ciągnąć bloki z przewijalnego strumienia na żądanie. Mały potomek TStream twojego autorstwa, który dokłada startowy offset PDF-a do każdego Seek, przedstawia osadzony dokument tak, jakby zaczynał się od pozycji zero, jak pokazuje artykuł o strumieniowaniu na żądanie
Druga niedopasowana treść to zawartość, która jeszcze nie jest zwykłym PDF. Jeśli osadzone bajty są skompresowane, zaszyfrowane przez kontener albo owinięte w inne kodowanie, przekształcona kopia jest nieunikniona, a wczytanie tej nowej tablicy z domyślnym Buffered = True to proste rozwiązanie. Zakres bajtów się opłaca w jednym kształcie: ciągłe, niemodyfikowane bajty PDF, już obecne w pamięci, pod offsetem, który twój parser walidował bez dodawania
Wywołanie zakresu bajtów siedzi obok wczytywania z pliku, strumienia, surowego wskaźnika i na żądanie w tym samym komponencie TPdf. Strona produktu PDFium Component wymienia obsługiwane wersje Delphi i C++Builder, opcje licencjonowania i resztę API wczytywania