veraPDF obala otagowany kwartalny raport na ISO 14289-1 §7.21.8, bo pojedynczy operator Tj pokazuje bajty <0000>, co pod Identity-H znaczy CID 0, glif .notdef. Ta klauzula i jej sąsiadka §7.21.6, która ogranicza nazwy glifów, jakich może używać tablica TrueType /Differences, wychodzą w Delphi jako osobne flagi w wyniku TPdf.ValidatePdfUa PDFium Component
Które operatory tekstu odwołują się do glifu .notdef?
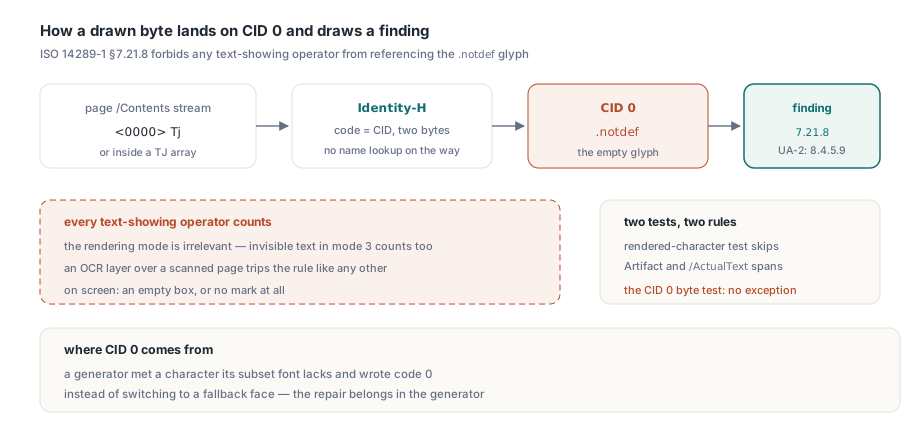
Każdy operator pokazujący tekst, którego operand mapuje na glif 0. W foncie prostym .notdef to nazwa glifu. W foncie kluczowanym CID tę samą rolę pełni CID 0, a ISO 32000-2 §9.7.4.2 wymaga, żeby każdy CIDFont zawierał opis glifu dla CID 0 „analogicznie do nazwy znaku .notdef w fontach prostych”. Przy zwyczajnym kodowaniu Identity-H kod znaku i CID to te same dwa bajty, więc strumień treści pokazujący <0000> przez Tj albo wewnątrz tablicy TJ rysuje CID 0. ISO 14289-1 §7.21.8 zabrania tego każdemu operatorowi pokazującemu tekst, a PDF/UA-2 formułuje to samo wymaganie w §8.4.5.9. Tryb renderowania tekstu jest bez znaczenia. Niewidoczny tekst w trybie 3, jak warstwa OCR nad zeskanowaną stroną, też się liczy. Na ekranie wynikiem jest zwykle pusty prostokąt szeroki na kilka punktów albo brak śladu w ogóle, i żadne z nich nie mówi korektorowi ze sprawnym wzrokiem, że znak przepadł
Zwykłym źródłem jest generator, który spotkał znak nieobecny w swoim foncie podzbioru i wpisał kod 0 tam, gdzie powinien był przełączyć się na font zapasowy. To czyni kontrolę na poziomie bajtów przyjemnie precyzyjną. Zdekoduj tylko strumienie, na które odwołuje się /Contents każdej strony, szukaj <0000> podawanego Tj albo TJ w dokumencie używającym fontów Type 0, i zostaw obrazy, profile ICC i CMapy skompresowane. Jeden szczegół parsowania rozstrzyga, czy w ogóle znajdziesz strony. ISO 32000-1 §7.3.5 kończy token nazwy na następnym separatorze, więc /Type/Page bez spacji to poprawny słownik strony, a szukanie oddzielonej spacjami formy /Type /Page go przeskoczy. Nazwanie /.notdef wewnątrz tablicy Differences samo w sobie nie uruchamia tej reguły; pokazanie kodu, który ląduje na tym slocie, już tak
Które nazwy glifów /Differences liczą się jako zgodne z Unicode?
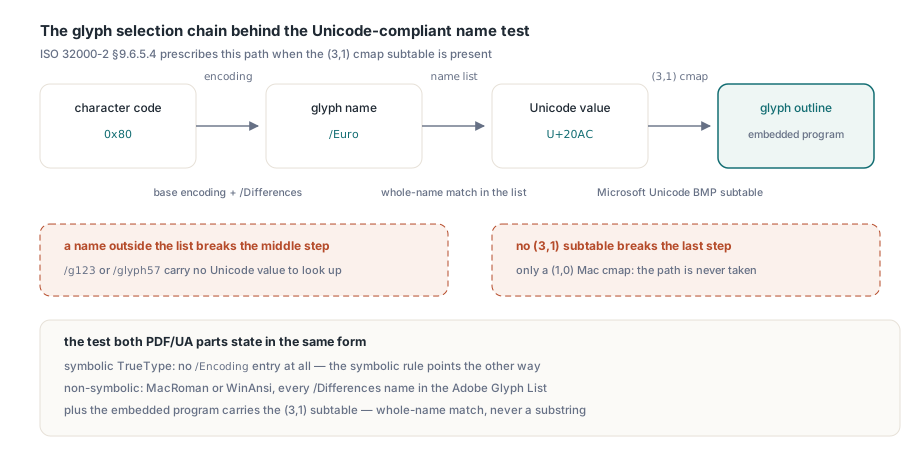
Takie, które figurują na Adobe Glyph List, o ile osadzony program fontu zawiera też podtabelę cmap (3,1). Tło to ISO 32000-2 §9.6.5.4, która zaleca, żeby font TrueType niesymboliczny używał MacRomanEncoding albo WinAnsiEncoding bez tablicy Differences; PDF/UA zamienia tę poradę na wymaganie z jedną furtką. Obie części PDF/UA formułują test w tej samej postaci, jaką stosuje veraPDF: font jest symboliczny, albo jego kodowanie to MacRoman albo WinAnsi i nie ma tablicy /Differences albo każda nazwa w tej tablicy jest zgodna z Unicode. Warunek (3,1) wynika z kolejności doboru glifów, którą §9.6.5.4 przepisuje, gdy ta podtabela (platforma Microsoft, Unicode BMP) jest obecna. Kod znaku przechodzi na nazwę glifu przez kodowanie, nazwa glifu na Unicode przez Adobe Glyph List, a Unicode na glif przez podtabelę (3,1). Nazwa spoza listy łamie środkowy krok, a font bez podtabeli nigdy tej ścieżki nie bierze. Reguła fontu symbolicznego wskazuje w drugą stronę: symboliczny font TrueType nie może w ogóle nieść wpisu /Encoding
| Słownik fontu | Wynik |
|---|---|
Niesymboliczny, /Encoding /WinAnsiEncoding, bez Differences | Przechodzi |
Niesymboliczny, podstawa WinAnsi, Differences z /Euro /bullet /.notdef, font ma cmap (3,1) | Przechodzi |
Niesymboliczny, Differences zawierające /g123 albo /glyph57 | Obala: nazwy nie na liście glifów |
| Niesymboliczny, poprawne Differences, osadzony font ma tylko cmap (1,0) Mac | Obala: brak podtabeli (3,1) |
Niesymboliczny, podstawa WinAnsi z Differences, bez osadzonego FontFile2 | Nie rozstrzygane tą regułą; obala je reguła osadzania (§7.21.4) |
Niesymboliczny, bez wpisu /Encoding | Obala |
Symboliczny, jakikolwiek wpis /Encoding | Obala reguła symboliczna |
Drugi wiersz to miejsce, w którym samodzielnie zbudowane listy glifów się psują. Lista, którą veraPDF dołącza do swojego kodu fontów, font/AdobeGlyphList.txt, ma 4 282 wpisy, a jej pierwszy wiersz brzmi .notdef 0000. Tabele składane ręcznie albo brane z innych źródeł często nie mają tego wpisu, bo .notdef nie oznacza żadnego realnego znaku. Kontroler zbudowany na takiej tabeli raportuje każdy font, którego tablica Differences wspomina /.notdef, nazwę regularnie pojawiającą się w fontach podzbioru, które wypełniają nią nieużywane sloty. Dopasowanie idzie po całej nazwie. Szukanie podciągu przyjęłoby /grav tylko dlatego, że /grave jest na liście. Nieużywane sloty Differences wypełniaj .notdef do woli; kontroler podążający za veraPDF to przyjmie
Reguły fontów są sądzone po bajtach, które zapisał producent
Naturalny skrót to zapis znormalizowanej kopii dokumentu i skanowanie jej, bo przepisany plik łatwiej sparsować. Dla reguł fontów to zawodzi. Każde narzędzie przepisujące PDF na nowo może przebudować słowniki fontów: zwinąć tablicę Differences w świeże kodowanie, przemianować glify, przenumerować obiekty. Regułę kodowania trzeba więc sprawdzać wobec bajtów, które zapisał producent. TPdf.ValidatePdfUa robi testy fontów na pliku albo buforze pamięci, który wczytał, i dekoduje strumienie FontFile2 wprost, żeby dosięgnąć katalogu tabel TrueType. Test na poziomie znaku (czy narysowany znak mapuje na Unicode 0?) używa tekstu, który renderuje strona, i przeskakuje treść oznaczoną jako Artifact albo przykrytą /ActualText; test bajtowy CID 0 nie robi takiego wyjątku. Uwagi przychodzą jako osobne wartości w zbiorze issue, więc raport może powiedzieć, która reguła strzeliła:
uses
  SysUtils, PDFium, FPdfPdfua;

procedure ReportFontFindings(const FileName: string);
const
  FontIssues: TPdfUaValidationIssues = [pvuaiPdfiumNotDefGlyph,
    pvuaiTrueTypeEncodingInvalid, pvuaiSymbolicTrueTypeEncoding,
    pvuaiFontNotEmbedded, pvuaiFontMissingToUnicode];
var
  Pdf: TPdf;
  Report: TPdfUaValidationResult;
  Found: TPdfUaValidationIssues;
  Coverage: TPdfUaUnicodeCoverageReport;
  I: Integer;
begin
  Pdf := TPdf.Create(nil);
  try
    Pdf.FileName := FileName;
    Pdf.Active := True;
    if not Pdf.Active then
      raise Exception.CreateFmt('Cannot open %s', [FileName]);
    Report := Pdf.ValidatePdfUa;
    Found := Report.Issues * FontIssues;
    if pvuaiPdfiumNotDefGlyph in Found then
    begin
      Writeln('Text references .notdef / CID 0 (7.21.8, 8.4.5.9)');
      // Zlokalizuj narysowane znaki, które nie mapują na żadną wartość Unicode
      Coverage := Pdf.InspectPdfUaUnicodeCoverage;
      for I := 0 to High(Coverage.Objects) do
        if Coverage.Objects[I].MissingUnicodeCharacterCount > 0 then
          Writeln(Format('  page %d, object %d: %d character(s)',
            [Coverage.Objects[I].PageNumber,
             Coverage.Objects[I].PageObjectIndex,
             Coverage.Objects[I].MissingUnicodeCharacterCount]));
    end;
    if pvuaiTrueTypeEncodingInvalid in Found then
      Writeln('Non-symbolic TrueType encoding or Differences (7.21.6, 8.4.5.7)');
    if pvuaiSymbolicTrueTypeEncoding in Found then
      Writeln('Symbolic TrueType font carries an /Encoding entry');
    if pvuaiFontNotEmbedded in Found then
      Writeln('A font program is not embedded (7.21.4)');
    if pvuaiFontMissingToUnicode in Found then
      Writeln('A font has no usable Unicode mapping (7.21.7)');
    if Found = [] then
      Writeln('No font findings');
    // Oczekiwane dla pliku, którego jedyną winą jest /g123 w tablicy Differences:
    // pojedynczy wiersz 7.21.6
  finally
    Pdf.Free;
  end;
end;
Naprawy należą do programu, który zapisał plik
Żadnej z tych uwag nie naprawi się bezpiecznie po fakcie przez edycję słownika. Odwołanie do CID 0 znaczy, że znak nie miał glifu w użytym foncie, więc generator potrzebuje fontu zapasowego dla tego znaku. Przepisanie <0000> na inny kod narysowałoby przypadkowy glif i przykleiło do niego złą wartość Unicode. Tablica Differences z nazwami typu /g123 pochodzi zwykle z subsetowania fontu, którego glify nie niosą standardowych nazw. Czysta naprawa to osadzenie tej kroju jako fontu TrueType kluczowanego CID, konfiguracji używanej przy osadzaniu fontów CID Type 2, z Identity-H i CMapą /ToUnicode. To wyłącza z gry regułę kodowania fontu prostego
Ustawianie flagi Symbolic, żeby §7.21.6 zniknęła, to ruch w złą stronę. Symboliczny font TrueType nie może nieść /Encoding wcale. Nazwy Differences, które mówiły czytnikowi ekranu, jaki znak stoi za każdym kodem, znikają razem z nim, a każdy podglądacz dobiera wtedy glify po surowym kodzie przez podtabelę (3,0) albo (1,0). Flaga znika. Znaczenie tekstu odchodzi razem z nią
Czy osadzony program fontu ma cmap (3,1)?
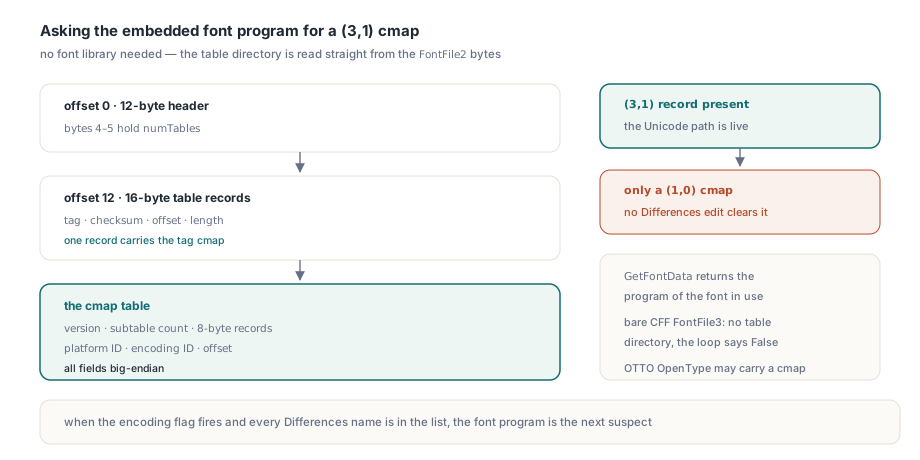
Zapytaj wprost program fontu, bo flaga kodowania przykrywa obie połowy testu i nie umie powiedzieć, która zawiodła. Kiedy się zapala, a każda nazwa Differences jest na liście, program jest następnym podejrzanym. Plik TrueType zaczyna się od 12-bajtowego nagłówka, którego bajty 4–5 trzymają liczbę tabel, po czym idą 16-bajtowe rekordy tabel (tag, suma kontrolna, offset, długość). Tabela cmap zaczyna się od wersji i liczby podtabel, po których idą 8-bajtowe rekordy ID platformy, ID kodowania i offsetu, wszystkie big-endian. Biblioteka fontów niepotrzebna. TPdf.GetFontData zwraca osadzony program fontu używanego przez obiekt strony, więc pomocnik może przebiec po każdym obiekcie tekstu na stronie:
function BE16(const B: TBytes; P: Integer): Integer;
begin
  Result := (B[P] shl 8) or B[P + 1];
end;

function BE32(const B: TBytes; P: Integer): Cardinal;
begin
  Result := (Cardinal(B[P]) shl 24) or (Cardinal(B[P + 1]) shl 16) or
    (Cardinal(B[P + 2]) shl 8) or B[P + 3];
end;

// True, gdy program TrueType ma podtabelę cmap dla (Platform, Encoding)
function HasCmapSubtable(const Font: TBytes; Platform, Encoding: Integer): Boolean;
var
  Tables, I, Rec, CmapOfs, Count: Integer;
begin
  Result := False;
  if Length(Font) < 12 then
    Exit;
  Tables := BE16(Font, 4);
  CmapOfs := -1;
  for I := 0 to Tables - 1 do
  begin
    Rec := 12 + I * 16;
    if Rec + 16 > Length(Font) then
      Exit;
    if (Font[Rec] = Ord('c')) and (Font[Rec + 1] = Ord('m')) and
       (Font[Rec + 2] = Ord('a')) and (Font[Rec + 3] = Ord('p')) then
      CmapOfs := Integer(BE32(Font, Rec + 8));
  end;
  if (CmapOfs < 0) or (CmapOfs + 4 > Length(Font)) then
    Exit;
  Count := BE16(Font, CmapOfs + 2);
  for I := 0 to Count - 1 do
  begin
    Rec := CmapOfs + 4 + I * 8;
    if Rec + 8 > Length(Font) then
      Exit;
    if (BE16(Font, Rec) = Platform) and (BE16(Font, Rec + 2) = Encoding) then
      Exit(True);
  end;
end;

// Krój z samą cmap Mac Roman (1,0) drukuje cmap(3,1)=False
procedure ListTextFonts(Pdf: TPdf; PageNo: Integer);
var
  I: Integer;
begin
  Pdf.PageNumber := PageNo;
  for I := 0 to Pdf.ObjectCount - 1 do
    if Pdf.ObjectType[I] = otText then
      Writeln(Format('%-32s embedded=%-5s cmap(3,1)=%s', [
        string(Pdf.GetFontBaseName(I)),
        BoolToStr(Pdf.GetFontIsEmbedded(I), True),
        BoolToStr(HasCmapSubtable(Pdf.GetFontData(I), 3, 1), True)]));
end;
Obiekty tekstu dzielące font drukują ten sam wiersz wielokrotnie. Tu to nieszkodliwe. Goły program CFF (FontFile3 z /Type1C albo /CIDFontType0C) nie ma katalogu tabel, więc pomocnik odpowiada dla niego False, a skoro reguła dotyczy fontów TrueType, ta odpowiedź nigdy tu niczego nie rozstrzyga. Fonty OpenType z konturami CFF różnią się: niosą katalog sfnt pod tagiem OTTO i mogą zawierać cmap, który ta sama pętla znajdzie. Dopóki program jest w pamięci, warto też porównać jego szerokości przyrostu hmtx z /Widths słownika fontu, bo PDF/UA ma osobną regułę spójności szerokości, a audyt szerokości glifów, CharSet i CIDSet stosuje ją od strony PDFlibPas
Jeśli HasCmapSubtable zwraca False dla kroju za flagą §7.21.6, żadna edycja jego tablicy Differences nie zmaże uwagi, a generator musi osadzić ten krój jako font Type 0 z CMapą ToUnicode. Odpal walidację PDFium Component dla Delphi jeszcze raz na przegenerowanym pliku i spodziewaj się braku pvuaiTrueTypeEncodingInvalid w Report.Issues