Zaimportuj FDF do formularza, a wartości pól wracają subtelnie zepsute: pocisk przychodzi jako sztylet, wielokropek jako półpauza. PDFium Component wyśledził całą tę rodzinę symptomów do jednego wiersza w swojej tabeli PDFDocEncoding — blok znaków specjalnych w Dodatku D.2 standardu ISO 32000-1 zaczyna się na $80, nie na $7F
Czemu import FDF zwraca sąsiedni znak?
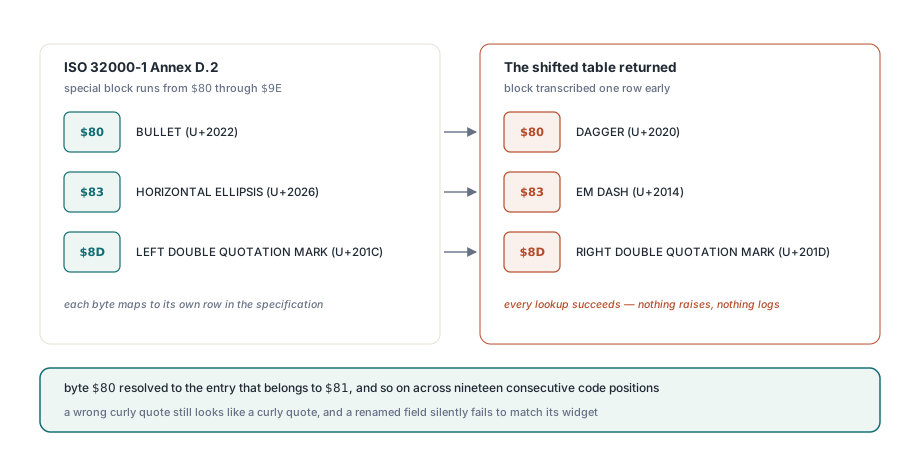
Bo tabela kodowania przesunięta o jedną pozycję wciąż wygląda jak całkowicie poprawna tabela, a każde wyszukiwanie w niej działa. Blok, który Dodatek D.2 przypisuje do zakresu $80–$9E, został przepisany o jeden wiersz za wcześnie, więc bajt $80 rozwiązywał się do wpisu należącego do $81, bajt $81 do wpisu dla $82 i tak dalej przez dziewiętnaście kolejnych pozycji kodowych. Nic nie rzuciło wyjątku, nic się nie zalogowało i żadne pole nigdy nie było odrzucone — TPdf.ImportFDF raportował tę samą liczbę pól co zawsze
Szkoda była jednostajna i cicha. Bajt niosący $80, który Dodatek D.2 definiuje jako BULLET (U+2022), wracał jako DAGGER (U+2020). Bajt $83, HORIZONTAL ELLIPSIS (U+2026), wracał jako EM DASH (U+2014). Bajt $8D, LEFT DOUBLE QUOTATION MARK (U+201C), wracał jako RIGHT DOUBLE QUOTATION MARK (U+201D) — przypadek, którego nikt nie zauważa, bo zły łukowy cudzysłów wciąż wygląda jak łukowy cudzysłów w polu formularza. Nazwy pól podzieliły los wartości pól, co jest gorsze: nazwa, która przestaje pasować do widgetu w dokumencie, po cichu się nie aplikuje
Ciągi tekstowe PDF niosą dwa różne kodowania
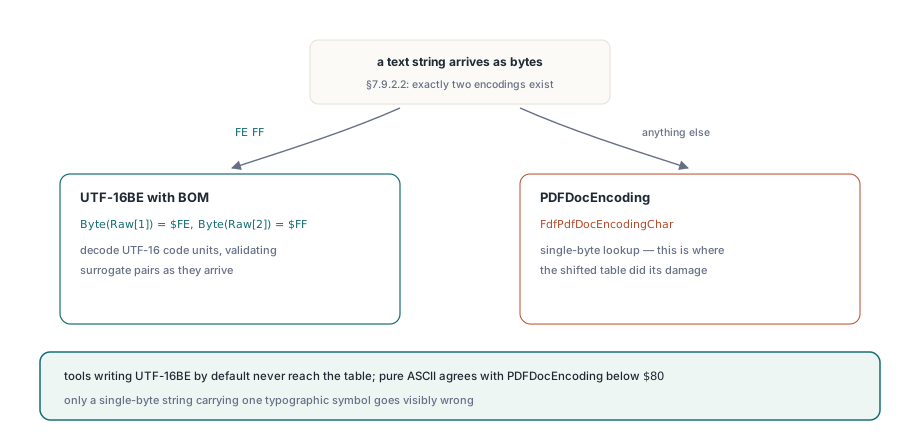
ISO 32000-1 §7.9.2.2 definiuje typ ciągu tekstowego jako dokładnie jedno z dwóch kodowań, wybierane przez zbadanie pierwszych dwóch bajtów, a nie przez jakikolwiek wpis słownika. Ciąg otwierający się znacznikiem kolejności bajtów FE FF to UTF-16BE; wszystko inne to PDFDocEncoding. Ta jedna gałąź decyduje, który z dwóch zupełnie różnych dekoderów działa, a PDFium Component stosuje ją wewnątrz parsera FDF, zanim dotknie choćby jednego znaku
// Ciąg tekstowy FDF: UTF-16, gdy jest BOM, w przeciwnym razie PDFDocEncoding
if (Length(Raw) >= 2) and
   (((Byte(Raw[1]) = $FE) and (Byte(Raw[2]) = $FF)) or
    ((Byte(Raw[1]) = $FF) and (Byte(Raw[2]) = $FE))) then
begin
  BigEndian := Byte(Raw[1]) = $FE;
  // ... dekoduj jednostki kodowe UTF-16, walidując pary zastępcze
end
else
begin
  SetLength(Result, Length(Raw));
  for I := 1 to Length(Raw) do
    Result[I] := FdfPdfDocEncodingChar(Byte(Raw[I]));
end;
I dlatego ten bug tak długo chował się w zwykłych testach. Jakikolwiek FDF wyprodukowany przez narzędzie, które domyślnie pisze UTF-16BE, w ogóle nie dociera do FdfPdfDocEncodingChar, więc przesunięta tabela zostaje uśpiona. Dopiero jednobajtowe ciągi — a to, co wiele generatorów FDF emituje dla zwykłych łacińskich nazw pól, bo są krótsze — idą gałęzią, w której tabela ma znaczenie. Czysto ASCII-owe nazwy pól dekodują się wtedy i tak poprawnie, bo poniżej $80 PDFDocEncoding i ASCII się zgadzają. Potrzebujesz jednobajtowego ciągu z jednym typograficznym symbolem, zanim cokolwiek zacznie widocznie szwankować
Poprawiona tabela i dwie kotwice, które ją spinają
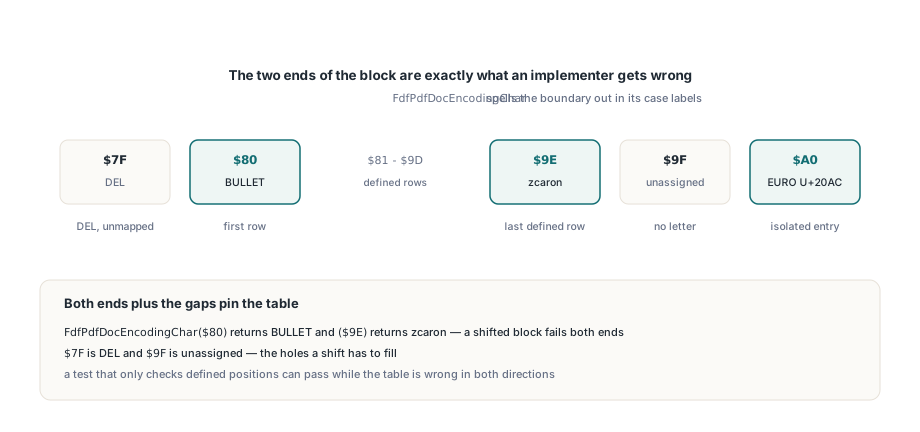
PDFium Component zapisuje teraz granicę wprost w FdfPdfDocEncodingChar, bo to właśnie dwa końce bloku są tym, co implementator potrafi popsuć. $7F to DEL i nie ma żadnego znaczenia w PDFDocEncoding; blok otwiera się na $80 bulletem i biegnie do $9E ze zcaron; $9F jest nieprzypisane; a znak euro siedzi samotnie na $A0
function FdfPdfDocEncodingChar(Value: Byte): WideChar;
begin
  case Value of
    // ISO 32000-1 Dodatek D.2. Blok biegnie od $80, nie od $7F: $7F to DEL i
    // nie ma znaczenia w PDFDocEncoding, a euro siedzi na $A0, które
    // domyślna gałąź inaczej oddałaby jako no-break space
    $7F: Result := WideChar($FFFD);
    $80: Result := WideChar($2022);   // BULLET, pierwszy wiersz bloku
    $81: Result := WideChar($2020);   // DAGGER
    // ... $82 do $9D
    $9E: Result := WideChar($017E);   // zcaron, ostatni zdefiniowany wiersz
    $9F: Result := WideChar($FFFD);   // nieprzypisane w Dodatku D.2
    $A0: Result := WideChar($20AC);   // EURO SIGN
  else
    Result := WideChar(Value);
  end;
end;
Popatrz, co przesunięcie zrobiło z tymi dwoma końcami, bo tu off-by-one przestaje być kosmetyczny. zcaron siedział na $9E w specyfikacji, ale na $9D w przesuniętej tabeli, więc bajt $9E z dokumentu spadał za ostatni przepisany wiersz i leciał wprost do fallbacku tożsamościowego, zwracając znak kontrolny C1 zamiast litery. A $A0, euro, w ogóle nigdy nie trafiło do tabeli — gałąź tożsamościowa oddawała go jako U+00A0 NO-BREAK SPACE, znak, który przeżywa każdą późniejszą walidację, drukuje się jako nic i nigdy nie pasuje do nazwy pola, której szukasz
Jak testować przepisaną tabelę kodowania?
Testuj pierwszy wiersz, ostatni wiersz i dziury — nie próbkę ze środka. To ta część naprawy, którą warto przenieść na każdą inną tabelę kopiowaną ze specyfikacji, bo punktowa kontrola ze środka bloku to dokładnie test, który przesunięcie całego bloku przeżywa. Zweryfikowanie, że $8D daje lewy łukowy cudzysłów, nie dowodzi niczego, gdy $8C też daje coś prawdopodobnego; zweryfikowanie, że $80 daje BULLET, a $9E daje zcaron, spina oba końce, a przesunięty blok nie może zadowolić obu naraz
procedure CheckPdfDocEncodingAnchors;
begin
  // Oba końce bloku specjalnego z Dodatku D.2: przesunięcie całego bloku je łamie
  Assert(FdfPdfDocEncodingChar($80) = WideChar($2022), 'first row: BULLET');
  Assert(FdfPdfDocEncodingChar($9E) = WideChar($017E), 'last row: zcaron');
  // Pozycje kodowe, które specyfikacja zostawia niezdefiniowane, nie mogą dekodować się do litery
  Assert(FdfPdfDocEncodingChar($7F) = WideChar($FFFD), '$7F is DEL, unmapped');
  Assert(FdfPdfDocEncodingChar($9F) = WideChar($FFFD), '$9F is unassigned');
  // Odosobniony wpis nad blokiem, łatwy do całkowitego pominięcia
  Assert(FdfPdfDocEncodingChar($A0) = WideChar($20AC), 'EURO SIGN');
end;
Niezdefiniowane pozycje zasługują na własne asercje, a nie na pominięcie jako nieciekawe. Off-by-one musi coś gdzieś wstawić, a miejsce, w które to wstawia, to prawie zawsze pozycja kodowa, którą specyfikacja zostawiła pustą — $7F z przodu, $9F z tyłu. Test sprawdzający tylko zdefiniowane pozycje może przejść, podczas gdy tabela jest zła w obie strony; test spinający dziury łapie przesunięcie przy pierwszym uruchomieniu
Ile to kosztuje w workflow formularzy z round-tripem
Import FDF, który po cichu przepisuje jeden znak na symbol, jest gorszy niż taki, który pada, bo awaria wypływa na końcu potoku i wygląda jak coś innego. Nazwy pól są tu ostrą krawędzią. TPdf.ImportFDF dopasowuje przychodzące nazwy do widgetów w otwartym dokumencie, a nazwa, która zdekodowała jeden znak źle, po prostu nie pasuje — pole zostaje puste, wartość zwracana wciąż liczy pole jako sparsowane, a raport wychodzący z potoku jest o jedną wartość krótszy i nic w logu nie wyjaśnia dlaczego. Każdy, kto buduje pętlę eksport-i-reimport w rodzaju opisanej w eksporcie i imporcie danych formularzy XFDF oraz adnotacji z komponentem PDFium, powinien round-tripować nazwę pola z typograficznym symbolem, nie tylko czyste ASCII, zanim zaufają pętli
Warto też uczciwie powiedzieć o granicach naprawy. Tabela zgadza się teraz z Dodatkiem D.2 dla wszystkich 256 wartości bajtów, przez co jednobajtowe ciągi FDF dekodują się poprawnie, ale samo PDFDocEncoding pokrywa łaciński repertuar i nic więcej — wszystko poza nim musi przyjść jako UTF-16BE z BOM, i dokładnie tego chce §7.9.2.2. A ciąg UTF-16 ma wciąż swoje osobne zagrożenia po stronie Delphi, bo punkt kodowy powyżej U+FFFF potrzebuje pary zastępczej, a nie jednego WideChar, co jest problemem omówionym w dlaczego emoji i znaki CJK psują WideChar w Delphi. Szerszy punkt generalizuje się poza tabele kodowania: parser PDF może odrzucić coś, co powinien przyjąć, co znajdujesz natychmiast, albo przyjąć coś i po cichu to zepsuć, co znajdujesz w produkcji. Pułapki z tokenami nazw opisane w bezpiecznym parsowaniu słowników PDF siedzą w tej drugiej kategorii, podobnie jak tabela przesunięta o jeden wiersz — ścieżka kodu działa, wartość zwracana wygląda rozsądnie, a tylko test napisany przeciw specyfikacji, a nie przeciw implementacji, mówi inaczej
ImportFDF, ExportFDF i ImportXFDF na TPdf, razem z parserami FDF i XFDF za nimi, są częścią standardowego komponentu PDFium dla Delphi i C++Buildera