Wyszukiwanie podciągów w rodzaju Pos('/Length', Dict) to niewłaściwe narzędzie do czytania słownika PDF, bo klucze nazw PDF dzielą przedrostki: /Length jest przedrostkiem /Length1, a /Encrypt jest przedrostkiem /EncryptMetadata. ISO 32000-1 §7.3.5 definiuje nazwę jako token, który kończy się wyłącznie na ograniczniku albo białym znaku, więc klucz liczy się jako znaleziony tylko wtedy, gdy bajt po nim jest jednym z tych znaków. Czytnik słowników, który pominie tę jedną kontrolę, prędzej czy później odczyta niewłaściwą wartość z całkowicie poprawnego pliku
Błąd, który nas tego nauczył, wcale nie wyglądał na problem leksera. Skan zgodności zaczął raportować strumień FontFile jako uszkodzony: zdekompresowany program czcionki był fragmentem, uciętym w środku tablicy. Plik otwierał się bez zarzutu w każdej przeglądarce. Dane strumienia na dysku były nienaruszone. Przyczyna źródłowa siedziała w jednej linii naszego wspólnego czytnika słowników: Pos('/Length', ...) dopasowało się do /Length1, standardowego klucza, który słowniki strumieni FontFile niosą zgodnie z tabelą 127 ISO 32000-1, a czytnik wziął liczbę całkowitą po /Length1 za długość strumienia. Zapisujący ten konkretny plik akurat serializował /Length1 przed /Length, co wolno mu robić w pełni, bo wpisy słownika są nieuporządkowane wedle §7.3.7. Strumień został ucięty do śmieciowej liczby bajtów, a każda kontrola niżej w potoku, która go konsumowała, po cichu oślepła
Dlaczego dopasowanie po podciągu psuje parsowanie słowników PDF?
Dopasowanie po podciągu psuje się, bo przestrzeń nazw PDF jest pełna celowych rodzin przedrostkowych, a kolejność wpisów słownika jest nieokreślona. Tabela 127 w ISO 32000-1 definiuje /Length1, /Length2 i /Length3 dla strumieni osadzonych czcionek, wszystkie siedzące obok /Length w tym samym słowniku. Słownik szyfrowania łączy /Encrypt w zwiastunie z /EncryptMetadata w środku. Krótkie klucze są gorsze: wyszukiwanie zbudowane jako Pos('/' + Key, ...) z Key = 'N' radośnie ląduje na /Name albo /Nums. Żadna z tych kolizji nie wymaga zniekształconego pliku. Zapisujący, który układa /Length1 przed /Length, jest w pełni zgodny, co oznacza, że błąd z podciągiem nie jest luką odporności wobec zepsutego wejścia — jest luką poprawności wobec wejścia poprawnego
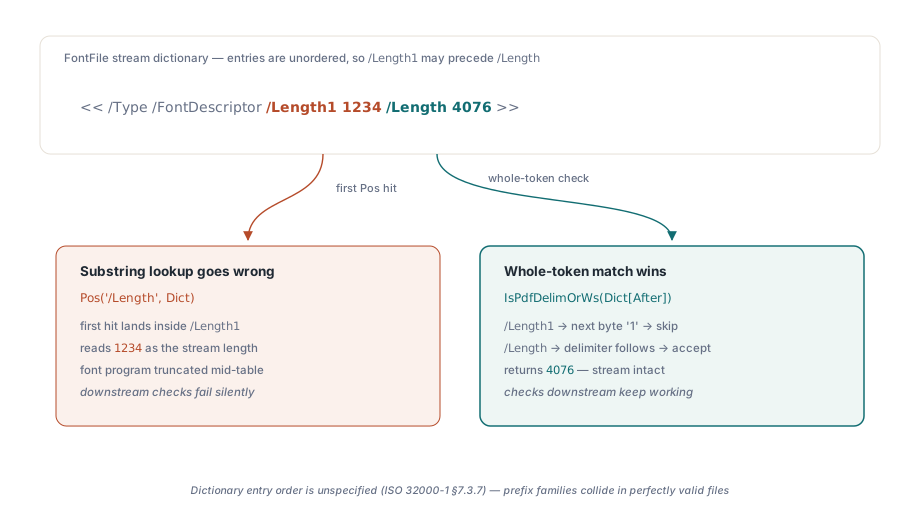
Tryb awarii jest też z tych cichych. Błędne /Length nie zgłasza wyjątku; podaje ci wycinek bajtów krótszy albo dłuższy, niż strumień faktycznie zajmuje. Jeśli ten wycinek zasila kontrolę podzbioru czcionki, parsowanie CMap albo skan metadanych, konsument widzi śmieci i zwykle nie raportuje w ogóle niczego, bo połowa strumienia zlib po prostu nie daje się rozprężyć, a kod jedzie dalej. Wysłaliśmy dokładnie tę klasę defektu i naprawiliśmy ją w v2.14.3 naszego wspólnego czytnika, po audycie klauzula po klauzuli ISO 32000-1 §7.2–§7.3, który oznaczył każde wyszukiwanie klucza w stylu Pos jako podejrzane
Czym ISO 32000-1 §7.3.5 naprawdę definiuje nazwę
Sekcja 7.3.5 jest krótka i precyzyjna: obiekt nazwy to ukośnik, po którym następuje ciąg znaków regularnych, a token kończy się na pierwszym ograniczniku albo białym znaku. Ogranicznikami jest osiem znaków nawiasowych plus ukośnik i znak procentu — ( ) < > [ ] { } / % — a białymi znakami są null, tabulator, wysuw wiersza, wysuw strony, powrót karetki i spacja (§7.2.2–§7.2.3). Ta reguła zakończenia to cała historia. /Length1 nie jest „/Length, po którym stoi 1”; jest pojedynczym, niepodzielnym tokenem, dokładnie tak jak LengthOne i Length są w Pascalu różnymi identyfikatorami. Każdy czytnik, który znajduje klucze przez surowe wyszukiwanie bajtów, reimplementuje lekser z usuniętą regułą zakończenia
Oto kształt defektu sprowadzony do tego, co istotne. Ta wersja kompiluje się, przechodzi testy na plikach, których zapisujący układają /Length jako pierwsze, i psuje strumienie u tych, którzy tego nie robią
// ŹLE: dopasowuje także /Length1, /Length2, /Length3
function ReadStreamLength(const Dict: AnsiString): Integer;
var
  P: Integer;
begin
  Result := -1;
  P := Pos('/Length', Dict);
  if P > 0 then
    Result := ReadIntAt(Dict, P + Length('/Length'));
end;
Dopasowanie całego tokenu: sprawdź bajt po kluczu
Poprawny predykat wynika wprost z §7.3.5: kandydat na dopasowanie jest prawdziwym kluczem tylko wtedy, gdy znak bezpośrednio po nim jest ogranicznikiem, białym znakiem albo końcem bufora. Wszystko inne to dłuższa nazwa, która jedynie dzieli przedrostek, więc wyszukiwanie musi biec dalej za nią, a nie poddawać się. Poprawka w naszym czytniku zastąpiła każde surowe wyszukiwanie Pos jedną wspólną procedurą zbudowaną na tej regule
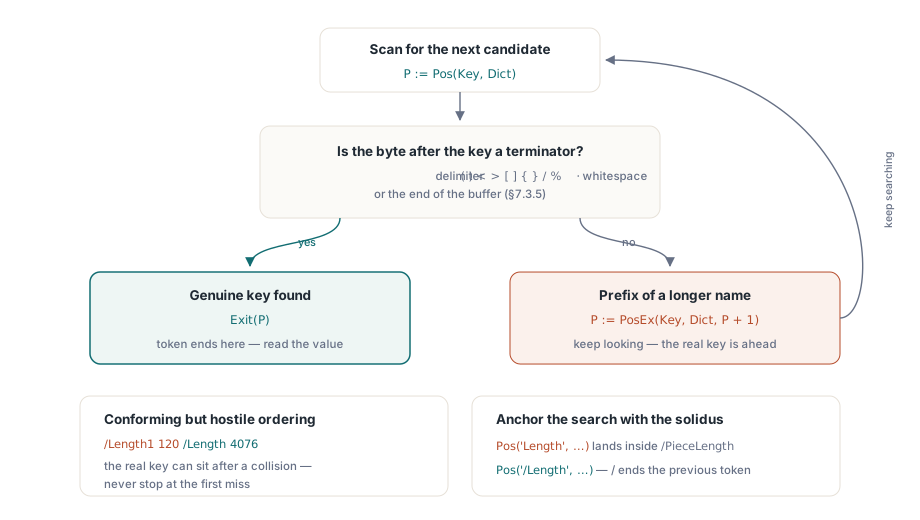
function IsPdfDelimOrWs(C: AnsiChar): Boolean;
begin
  Result := C in [#0, #9, #10, #12, #13, ' ',
    '(', ')', '<', '>', '[', ']', '{', '}', '/', '%'];
end;

// Poprawnie: dopasowanie całego tokenu wg ISO 32000-1 §7.3.5
function FindDictKey(const Dict, Key: AnsiString): Integer;
var
  P, After: Integer;
begin
  Result := 0;
  P := Pos(Key, Dict);
  while P > 0 do
  begin
    After := P + Length(Key);
    if (After > Length(Dict)) or IsPdfDelimOrWs(Dict[After]) then
      Exit(P);                       // token kończy się tutaj: prawdziwy klucz
    P := PosEx(Key, Dict, P + 1);    // przedrostek dłuższej nazwy: szukaj dalej
  end;
end;
Dwa szczegóły w tej pętli mają wagę. Po pierwsze, szuka ona dalej, zamiast zwracać porażkę przy pierwszej kolizji przedrostków, bo /Length1 120 /Length 4076 to legalna kolejność, a prawdziwy klucz wciąż jest przed nami. Po drugie, przypadek końca bufora liczy się jako terminator, bo fragment słownika może legalnie kończyć się tuż po nazwie. Subtelniejsza rzecz warta audytu we własnym kodzie: ta sama reguła stosuje się po lewej stronie dopasowania, jeśli twój ciąg wyszukiwania nie zawiera ukośnika, inaczej Pos('Length', ...) może wylądować wewnątrz /PieceLength. Zakotwiczenie ciągu wyszukiwania wiodącym /, jak wyżej, załatwia lewą krawędź, bo / sam jest ogranicznikiem kończącym poprzedzający token
Jak wrogi PDF zamienia błąd parsera w przydział gigabajta?
Plik zniekształcony albo złośliwy podnosi te leksykalne pomyłki do rangi wyczerpania zasobów, bo liczby całkowite ze słownika często zasilają rozmiary przydziałów. Nasz audyt znalazł łańcuch dokładnie tego kształtu w rozwijaniu strumieni obiektów. Wpis /N w słowniku ObjStm mówi, ile skompresowanych obiektów trzyma strumień, a kod rozwijania wywoływał SetLength na tablicy wymiarowanej według niego. Parser liczb całkowitych zostawiał jednak swój parametr wyjściowy nietknięty przy niepowodzeniu, a mimo to go zwracał — więc nieliczbowe /N podawało SetLength niezainicjowaną wartość ze stosu. Śmieciowa dodatnia liczba całkowita w tym miejscu oznacza żądanie przydziału rzędu gigabajtów, wyzwolone kilkoma bajtami zepsutego wejścia, i to podczas zwykłego skanowania dokumentu, któremu nawet nie zgodziłeś się jeszcze zaufać
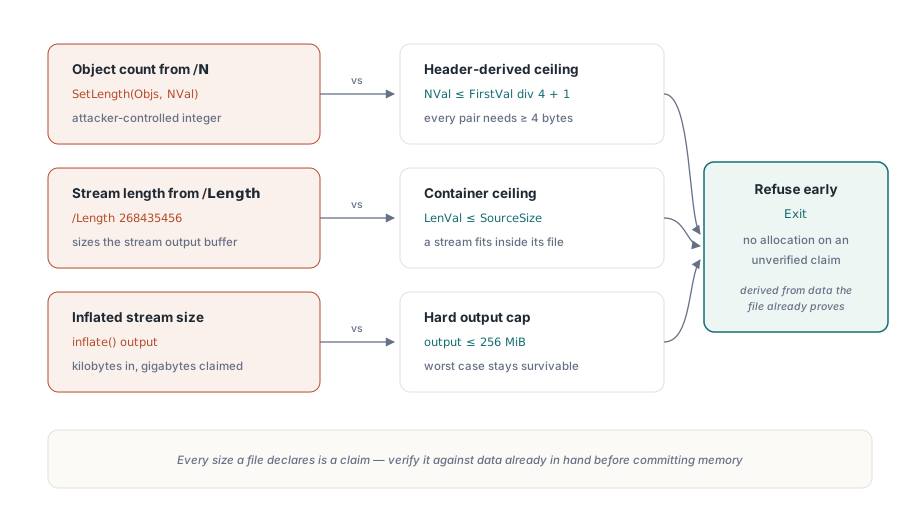
Naprawa miała dwie niezależne części i obie się uogólniają. Parser zwraca teraz jawne 0 przy niepowodzeniu, nigdy niezainicjowanej pamięci. A konsument nie ufa już /N bez arytmetyki: obszar nagłówka ObjStm przed /First przechowuje parę liczb całkowitych — numer obiektu i przesunięcie — dla każdego skompresowanego obiektu, a każda para zajmuje co najmniej cztery bajty razem z separatorami. Każde /N powyżej FirstVal div 4 + 1 jest zatem fizycznie niemożliwe przy zadeklarowanym rozmiarze nagłówka i zostaje odrzucone, zanim dojdzie do jakiegokolwiek przydziału. Ta granica kosztuje jedno porównanie i wywodzi się z danych, które już masz w ręku, a to właśnie wzorzec, którego trzeba szukać: sufit, który plik sam udowadnia, a nie dowolna stała
// /N jest kontrolowane przez atakującego; ogranicz je tym, co pomieści /First
if not TryReadDictInt(Dict, '/N', NVal) then
  NVal := 0;                          // jawne zero, nigdy śmieci ze stosu
if (NVal <= 0) or (NVal > FirstVal div 4 + 1) then
  Exit;                               // nagłówek nie pomieści tylu par

// /Length nigdy nie może przekroczyć pliku, który zawiera strumień
if (LenVal < 0) or (LenVal > SourceSize) then
  Exit;                               // odmów przed przydzieleniem bufora
Dwa kolejne sufity domykają perymetr obronny w naszym czytniku, oba wysłane w v2.12.0. Czytnik strumieni odmawia przyjęcia /Length większego niż cały plik, zanim przydzieli bufor wynikowy — strumień nie może być większy niż kontener, w którym mieszka, więc kontrola jest wolna od fałszywych alarmów. A ścieżka inflate ogranicza zdekompresowane wyjście do 256 MiB, co ubija klasyczną bombę zlib, w której kilka kilobajtów wejścia rozpręża się bez ograniczeń; limit jest hojny dla każdego prawdziwego strumienia PDF, a jednocześnie utrzymuje najgorszy przypadek w granicach przeżywalności. Motyw wszystkich trzech jest ten sam: każdy rozmiar, który deklaruje plik, jest twierdzeniem, a parser weryfikuje każde twierdzenie wobec czegoś, co potrafi zmierzyć, zanim zaangażuje w nie pamięć. Ta sama postawa audytowa stosuje się warstwę niżej, na granicy wiązania, co omawiamy w utwardzaniu ABI PDFium i bezpieczeństwa pamięci w Delphi
Gdzie reguła całego tokenu nie wystarcza
Uczciwe ograniczenia, żebyś nie zaufał powyższej procedurze ponad miarę. Dopasowanie całych tokenów naprawia identyfikację kluczy, ale płaskie wyszukiwanie bajtów po obszarze słownika wciąż nie potrafi stwierdzić, czy dopasowanie siedzi wewnątrz zagnieżdżonego słownika, dosłownego ciągu albo komentarza — FindDictKey na obiekcie strony może wylądować na kluczu wewnątrz jej podsłownika /Resources, jeśli podasz mu zbyt szeroki obszar. Nasz czytnik najpierw zawęża obszar do ciała pojedynczego obiektu, a konteksty ciągów i komentarzy traktuje jako osobną, wciąż otwartą pozycję audytową. Bezpieczeństwo wobec podciągów to jeden szczebel drabiny, a nie cała drabina: spójność odniesień krzyżowych to własna dyscyplina, omówiona w walidacji strumieni obiektów i xref, a szerszy katalog zagrożeń dla dokumentów, których nie napisałeś, jest w audycie zagrożeń bezpieczeństwa PDF
Jeśli utrzymujesz ręcznie pisany czytnik słowników w Delphi albo Lazarusie, lista kontrolna z tego incydentu jest krótka. Wygrepuj każde Pos('/ w bazie kodu i przepuść trafienia przez jeden helper dopasowujący całe tokeny. Wypisz rodziny przedrostkowe, w których uczestniczą twoje klucze — /Length, /Encrypt, /N, /Type wobec /Type1 pojawiają się w prawdziwych plikach. Potem przejdź każdą liczbę całkowitą, która dociera do SetLength, GetMem albo pętli kopiującej, i zapytaj, co ją ogranicza: rozmiar pliku, sufit wywiedziony z nagłówka czy nic. Opisana tutaj warstwa parsowania jest fundamentem pod naszym PDFium Component, gdzie czytnik na poziomie bajtów i silnik renderujący sprawdzają się nawzajem na każdym dotykanym dokumencie