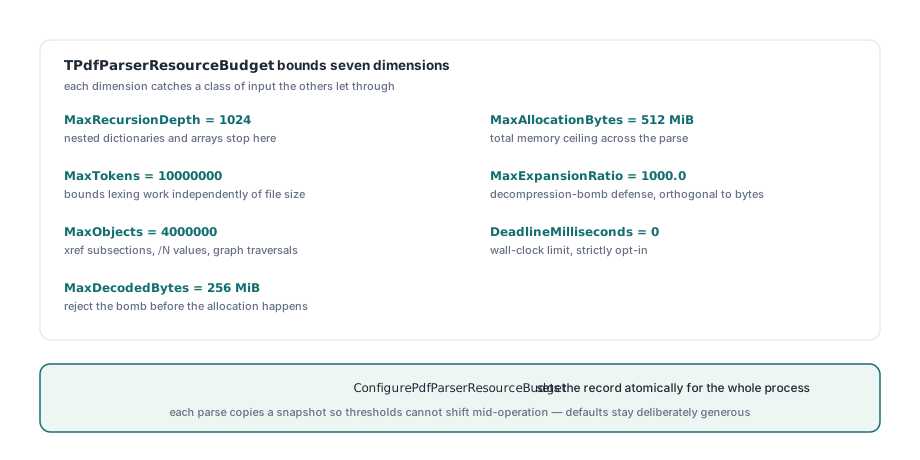
PDFium Component wystawia TPdfParserResourceBudget, pojedynczy rekord, który ogranicza głębokość rekursji, liczbę tokenów, liczbę obiektów, zdekodowane bajty, współczynnik ekspansji, alokacje i termin czasu rzeczywistego dla każdego parsera PDF w bibliotece. ConfigurePdfParserResourceBudget ustawia go atomowo dla procesu, a każde parsowanie kopiuje snapshot, więc jego progi nie mogą się przesunąć w środku operacji
Sześć parserów, sześć prywatnych sufitów
Sytuacja, która to wymusiła, była zwykła i pewnie znajoma. Przebieg sparse xref miał swój własny sufit obiektów. Inspektor strumieni miał swój własny limit zdekodowanych bajtów. XMP miał jeden, XFDF i FDF inny, normalizacja zawartości trzeci, a domyślne preflight czwarty. Każda z tych liczb była sama w sobie do obrony i żadna nie była osiągalna z zewnątrz, więc wywołujący, który chciał powiedzieć „ta ścieżka przyjęć obsługuje anonimowe uploady, nic tutaj nie może zaalokować więcej niż 64 MiB ani działać dłużej niż cztery sekundy", nie miał gdzie tego powiedzieć. Drugi problem był gorszy, bo cichy: tam, gdzie limit mieszkał w mutowalnej globalce, parsowanie zaczęte pod jedną polityką mogło skończyć pod inną. Jeden wątek woła setter, a drugi jest w połowie strumienia obiektów, i pierwsza połowa tego przebiegu jest ograniczona starym sufitem, a druga nowym. Nic się nie wywala, nic się nie loguje, a potem nie potrafisz powiedzieć, pod jakimi limitami operacja faktycznie działała — czyli dokładnie tej właściwości, do której limity były ci potrzebne
Co TPdfParserResourceBudget faktycznie ogranicza?
Siedem wymiarów, dobranych tak, że każdy łapie klasę wejść, które pozostałe przepuszczają. MaxRecursionDepth domyślnie 1024 i zatrzymuje zagnieżdżone słowniki i tablice przed zamianą składni obiektów z ISO 32000-1 §7.3 na przepełnienie stosu. MaxTokens domyślnie 10 000 000 i ogranicza pracę leksera niezależnie od rozmiaru pliku. MaxObjects domyślnie 4 000 000 i pokrywa liczby podsekcji cross-reference, wartości /N strumieni obiektów i przebiegi po grafie. MaxDecodedBytes domyślnie 256 MiB, a MaxAllocationBytes 512 MiB, więc plik może być odrzucony przed alokacją, a nie po niej. MaxExpansionRatio domyślnie 1000.0 i to ten, którego ludzie nie doceniają: filtry strumieni z ISO 32000-1 §7.4 to ogólna kompresja, kilka kilobajtów danych Flate może legalnie rozwinąć się w setki megabajtów, a sufit współczynnika to standardowa obrona przed bombą dekompresyjną. Jest ortogonalny do bezwzględnego limitu bajtów, bo strumień 200 KiB, który chce urosnąć do 200 MiB, mieści się pod sufitem 256 MiB i wciąż jest absurdem. DeadlineMilliseconds domyślnie 0, czyli brak terminu, więc ten wymiar jest ściśle opt-in. Domyślne wartości jako zestaw są celowo hojne, dobrane tak, żeby zwykłe dokumenty biznesowe niczego nie trącały, a nie po to, żeby być utwardzonym profilem; jeśli twoje wejście przychodzi z publicznego formularza uploadu, chcesz czegoś bliższego liczbom poniżej, obok reguł opisanych w utwardzaniu panelu podglądu PDF w Delphi
uses
  FPdfPdfCommon;

procedure ApplyUntrustedIntakeBudget;
var
  Budget: TPdfParserResourceBudget;
begin
  Budget := TPdfParserResourceBudget.Default;
  // Domyślne zachowane: MaxRecursionDepth 1024, MaxTokens 10000000,
  // MaxObjects 4000000
  Budget.MaxDecodedBytes      := Int64(32) * 1024 * 1024;  // domyślnie 256 MiB
  Budget.MaxAllocationBytes   := Int64(64) * 1024 * 1024;  // domyślnie 512 MiB
  Budget.MaxExpansionRatio    := 50.0;                     // domyślnie 1000.0
  Budget.DeadlineMilliseconds := 4000;                     // domyślnie 0 = wyłączone
  ConfigurePdfParserResourceBudget(Budget);
end;
Czemu snapshot zamiast czytania globalki?
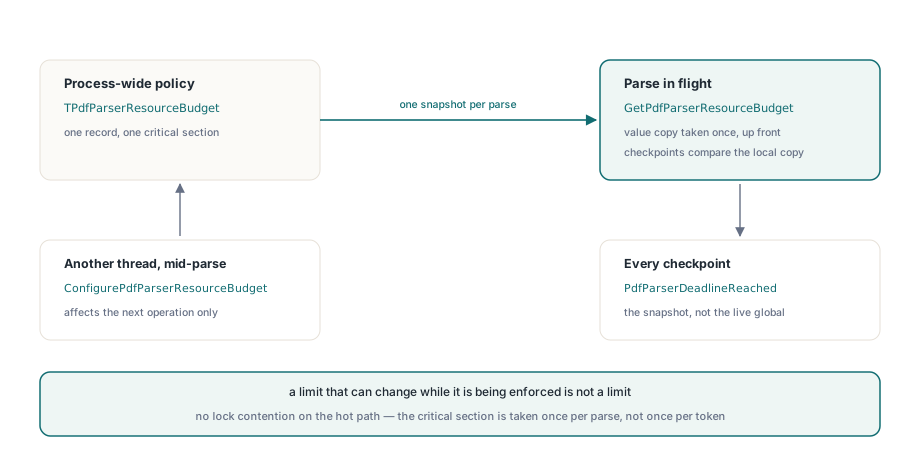
Bo limit, który może się zmienić w trakcie egzekwowania, nie jest limitem. To centralny punkt projektu całej funkcji i to jedna linia dyscypliny przy każdym punkcie wejścia: przeczytaj politykę raz na początku operacji do lokalnego TPdfParserResourceBudget, a potem każdy checkpoint porównuje z tą lokalną kopią. GetPdfParserResourceBudget bierze sekcję krytyczną i oddaje kopię wartości rekordu, a potem parsowanie nigdy więcej nie dotyka mutowalnego stanu globalnego. Efekt jest taki, że wywołanie ConfigurePdfParserResourceBudget z innego wątku wpływa na następną operację, nigdy na tę w locie. Równoległe parsowania działają pod różnymi politykami bez wchodzenia sobie w drogę, operacja, która padła na limicie zasobów, padła przeciw jednemu spójnemu zestawowi progów, a na gorącej ścieżce nie ma rywalizacji o blokadę, bo lock bierze się raz na parsowanie, a nie raz na token
type
  TCustomScanState = record
    Budget: TPdfParserResourceBudget;
    StartTick: Cardinal;
    TokenCount: Int64;
    Depth: Integer;
  end;

procedure BeginScan(var S: TCustomScanState);
begin
  S.Budget := GetPdfParserResourceBudget;  // migawka zrobiona raz, z góry
  S.StartTick := PdfParserStartTick;
  S.TokenCount := 0;
  S.Depth := 0;
end;

function ScanCheckpoint(var S: TCustomScanState): Boolean;
begin
  Result := False;
  if PdfParserDeadlineReached(S.StartTick, S.Budget) then
    Exit;
  Inc(S.TokenCount);
  if S.TokenCount > S.Budget.MaxTokens then
    Exit;
  if S.Depth > S.Budget.MaxRecursionDepth then
    Exit;
  Result := True;
end;
Jeśli piszesz własny parser na bazie biblioteki, skopiuj ten kształt zamiast wołać GetPdfParserResourceBudget w pętli tokenów. Wołanie na token jest poprawne, ale bez sensu: płacisz sekcję krytyczną przy każdej iteracji i sprowadzasz z powrotem dryf w środku operacji, przed którym snapshot miał chronić
Czemu sufit bajtów nie zatrzymuje patologicznego pliku?
Bo rozmiar i koszt są w PDF luźno powiązane. Plik 400 KiB ze strumieniem cross-reference z ISO 32000-1 §7.5.8, którego tablice /Index i /W opisują prawdopodobną, ale wrogą liczbę wpisów, łańcuch strumieni obiektów wracający do tych samych offsetów albo strumień zawartości z operatorami, z których każdy kosztuje więcej, niż wygląda, wygodnie zmieści się pod każdym sufitem bajtów i obiektów, jaki ustawisz, i wciąż zajmie wątek roboczy na minuty. Liczba bajtów ogranicza pamięć; nie ogranicza czasu. Do tego służą PdfParserStartTick i PdfParserDeadlineReached. PdfParserStartTick łapie wartość ticka na starcie operacji, a PdfParserDeadlineReached porównuje czas, który upłynął, z DeadlineMilliseconds, zwracając False zawsze, gdy termin to 0. Odejmowanie działa w arytmetyce bez znaku, więc przewinięcie licznika ticków nie produkuje fałszywego timeoutu. Parsowanie cross-reference, dekodowanie strumieni obiektów, normalizacja tokenów zawartości i czytniki FDF i XFDF sprawdzają to na głowach swoich pętli, więc operacja nad budżetem zatrzymuje się na checkpointcie, a nie jest ubijana z zewnątrz
Dwa uczciwe zastrzeżenia. To czas rzeczywisty, nie czas CPU, więc maszyna, która swapuje, albo build server pod obciążeniem może trafić w termin, którego cicha maszyna by nie trafiła, co przemawia za ustawieniem go wyraźnie powyżej obserwowanego najgorszego przypadku, a nie blisko mediany. I jest domyślnie wyłączony, bo termin, który odpala na legalnie wielkim dokumencie podczas batcha na koniec miesiąca, to gorsza awaria niż ta, której zapobiega. Rób opt-in per ścieżka przyjęć, a nie globalnie, i zestaw to z kontrolami strukturalnymi z walidacji strumieni cross-reference
Budżet to sufit, nie zamiennik limitów formatu
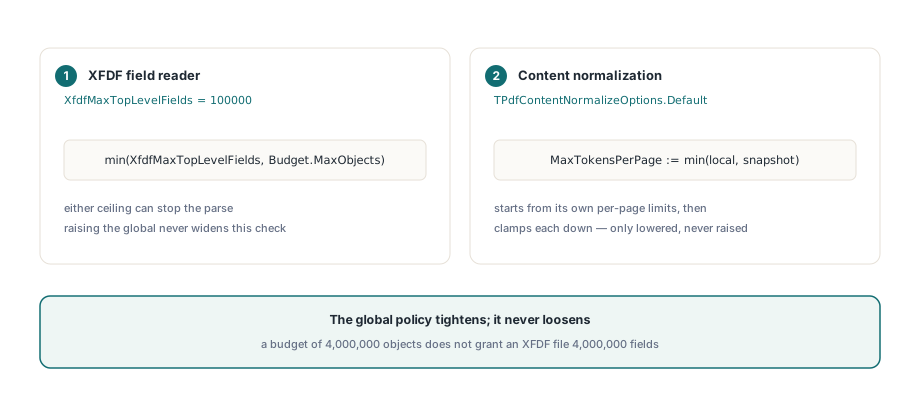
Każdy parser trzyma własne stałe specyficzne dla formatu i stosuje oba. XFDF to najczystszy przykład: czytnik pól egzekwuje XfdfMaxTopLevelFields i stałą MaxFieldNodes równą 100000 obok wartości snapshotu i którekolwiek może zatrzymać parsowanie
const
  XfdfMaxTopLevelFields = 100000;   // lokalny dla formatu, zawsze działa
...
  // Oba sufity są aktywne; wygrywa niższy
  if (FieldCount >= XfdfMaxTopLevelFields) or
     (FieldCount >= Budget.MaxObjects) then
    Exit(False);
To zamierzone i warto to sobie przyswoić, zanim zaczniesz szukać pokrętła, które nie istnieje. Globalny budżet 4 000 000 obiektów nie daje plikowi XFDF 4 000 000 pól, bo 100000 pól to już daleko poza tym, co produkuje jakikolwiek prawdziwy eksport adnotacji, a podniesienie globalnego sufitu nie powinno po cichu poszerzać formatowo specyficznej kontroli poprawności. Normalizacja zawartości działa tak samo z drugiej strony: TPdfContentNormalizeOptions.Default startuje z własnych limitów per strona, a potem zaciska każdy z nich do snapshotu, więc MaxTokensPerPage może być przez budżet tylko obniżony, nigdy podniesiony. Polityka globalna dokręca; nigdy nie luzuje
Zła konfiguracja pada w momencie konfigurowania
ConfigurePdfParserResourceBudget waliduje, zanim przypisze. Niedodatnia wartość w którymkolwiek z sześciu numerycznych wymiarów podnosi wyjątek natychmiast, a MaxDecodedBytes powyżej High(Integer) jest odrzucane jako przekroczenie limitów platformy, zamiast być po cichu ucięte gdzieś głęboko w dekoderze. To ważniejsze, niż brzmi: budżet złożony z pliku konfiguracyjnego z brakującym kluczem daje ci zera, a zerowy sufit obiektów przyjęty przy starcie zamienia się w niezrozumiałą awarię parsowania przy pierwszym dokumencie trzy godziny później, kiedy nikt już nie podejrzewa konfiguracji. Ta sama ostrożność dotyczy każdego kodu, który chwilowo dokręca budżet, włącznie z testami. Polityka jest procesowa, więc zostawienie zainstalowanego 4-sekundowego terminu po skończonym fixturze truje każdy późniejszy; zapisz i przywróć wokół zmiany
var
  Saved: TPdfParserResourceBudget;
begin
  Saved := GetPdfParserResourceBudget;
  try
    ApplyUntrustedIntakeBudget;
    ProcessInboundDocument(FileName);
  finally
    ConfigurePdfParserResourceBudget(Saved);
  end;
end;
ResetPdfParserResourceBudget to prostsza wersja, przywracająca TPdfParserResourceBudget.Default wprost. Używaj jej w teardownie testów, gdzie chcesz znany stan, a zapisz-i-przywróć w kodzie produkcyjnym, gdzie stanem, do którego musisz wrócić, jest to, co aplikacja gospodarza skonfigurowała przy starcie
Gdzie budżet przestaje pomagać
To jedna procesowa polityka i to jej główna ograniczenie. Nie możesz dać jednemu wątkowi roboczemu ścisłego profilu, a drugiemu pobłażliwego, bo jest jeden rekord za jedną sekcją krytyczną; jeśli naprawdę potrzebujesz limitów per dzierżawca, kształtem, który działa, jest zserializowanie każdej klasy polityki na własny proces albo obramowanie pracy zapisz-i-przywróć z akceptacją, że obramowanie jest bezpieczne tylko wtedy, gdy nic innego nie parsuje równolegle. Ogranicza też parsowanie, nie renderowanie: pamięć rasteryzacji, wzrost cache czcionek i dekodowanie obrazów siedzą poza tymi siedmioma wymiarami i potrzebują własnych kontroli. A budżet mówi ci, że operacja była za droga, nigdy dlaczego. Sufit, który odpalił, to symptom, a stojący za nim zepsuty /Index albo szalejący łańcuch filtrów wciąż trzeba zdiagnozować ręcznie, dlatego ścieżka dekodowania opisana w dekodowaniu strumieni obiektów i predyktorów jest warta zrozumienia, zanim zaczniesz ruszać liczby. Traktuj budżet jako rzecz, która trzyma zły dokument przed zabraniem procesu ze sobą, i trzymaj swoje logi na tyle dobre, żeby dowiedzieć się, co ten dokument robił
Pełna powierzchnia API parsera, rekord budżetu i build ze źródła dla Delphi, C++Buildera i Lazarusa są na stronie produktu: PDFium Component