Tabela biegnąca przez trzy strony eksportu z Worda nigdy nie podchodzi bliżej niż na 72 punkty do dołu papieru. Marginesy jednego cala to 72 punkty, a edytor tekstu przestaje układać wiersze na marginesie. Łącznik, który skleja fragmenty tylko, gdy siedzą w obrębie 36 punktów od krawędzi strony, widzi trzy niepowiązane tabele o identycznych kolumnach. Pytanie, które działa, brzmi inaczej: czy cokolwiek poza powtarzanym nagłówkiem albo stopką siedzi między końcem jednego fragmentu a początkiem następnego?
To pytanie przynosi własne dwie pułapki. Formularz może zakończyć jedną tabelę na dole strony 1 i otworzyć inną tabelę o tych samych szerokościach kolumn na górze strony 2. A posiatkowana siatka może przepchnąć pojedynczy wiersz przez złamanie — za krótki dla detektora, który chce dwóch wierszy, zanim uzna coś za tabelę
Dwa testy brzegowe w ExtractDocumentTables
PDFium Component oznacza kontynuacje w TPdf.ExtractDocumentTables — odpowiedniku na poziomie dokumentu per-stronicowego ExtractTables, opisanego w artykule o wykrywaniu i wyciąganiu tabel. Z ustawionym DetectContinuations, jak w TPdfTableExtractionOptions.Default, metoda wyciąga każdą stronę, sortuje tabele po numerze strony, a potem od góry każdej strony w dół, i sprawdza każdą parę sąsiadów na tej liście. Porównywani są wyłącznie sąsiedzi. Kandydatem na kontynuację jest więc zawsze najniższa tabela na stronie N sparowana z najwyższą tabelą na stronie N+1, a mała tabela postawiona pod długą na stronie N zajmuje w tym sparowaniu miejsce długiej. Gdy krótka tabela notatek siedzi pod długą, połącz te fragmenty we własnym kodzie z numerów stron i ColumnCount
Pierwszy test jest czysto geometryczny. Dolna krawędź wcześniejszego fragmentu musi leżeć w granicach ContinuationMargin punktów od dołu strony, a górna krawędź późniejszego w tej samej odległości od góry następnej strony. Domyślne to 36 punktów, pół cala. Raporty z silników składu wypełniających stałe pudełko treści przechodzą to bez trudu. Eksport z Worda z marginesami po calu mija się o co najmniej 36 punktów z każdej strony, a poszerzanie marginesu, aż przejdzie, prowadzi na manowce, bo ta sama liczba ustawia pasy nagłówka i stopki drugiego testu
Drugi test, ten świadomy treści, to właśnie obsługa wyjścia z edytora tekstu. Oba łączą się przez OR: którykolwiek otwiera bramkę
Co liczy się jako tekst między dwoma fragmentami?
Każde słowo na stronie liczy się jako tekst treści, chyba że leże całkowicie wewnątrz pasa powtarzanego nagłówka albo pasa stopki, a oba pasy mają głębokość ContinuationMargin punktów. Per strona ExtractDocumentTables zapisuje najniższą dolną krawędź pośród słów, których góra jest nad pasem stopki, i najwyższą górną krawędź pośród słów, których dół jest pod pasem nagłówka — łącznie z tekstem komórek samej tabeli. Gdy tabela jest ostatnią treścią strony N, jej dolna krawędź siedzi na wysokości najniższego słowa albo niżej, i test przechodzi w granicach AlignmentTolerance, domyślnie 3 punktów. Późniejszy fragment musi spełnić warunek lustrzany na górze strony N+1
Ignorowanie pasów ma oparcie w specyfikacji. ISO 32000-1 §14.8.2.2 traktuje bieżące nagłówki, stopki i numery stron jako artefakty paginacji — treść istniejącą wyłącznie dlatego, że dokument został pocięty na strony. Plik z tagami może je zadeklarować przez /Artifact, jak wyjaśnia artykuł o zawartości oznaczonej, ale eksporty najbardziej potrzebujące sklejania tabel rzadko niosą tagi, więc pozycja zastępuje tag. Przy domyślnym pasie numer strony, którego glify kończą się 30 punktów nad dolną krawędzią, jest ignorowany. Linia zastrzeżenia sięgająca 40 punktów to tekst treści i blokuje łącze
Na stronie bez warstwy tekstowej zapisane ekstremy cofają się do granic strony, test świadomy treści przechodzi trywialnie i o reszcie rozstrzygają pozostałe bramki. Stopki rysowane jako obrazy albo kontury wektorowe są niewidzialne z tego samego powodu i nigdy nie blokują łącza
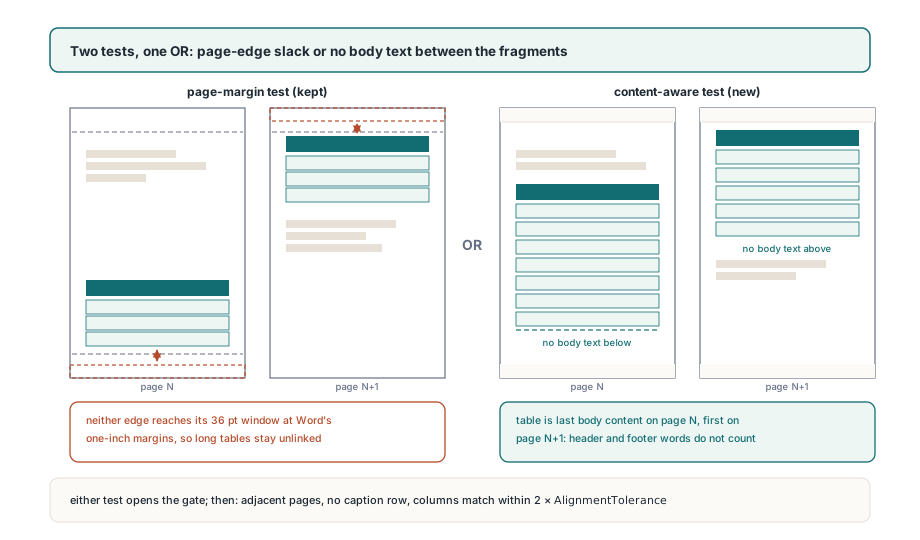
Przejście testu brzegowego tylko otwiera bramkę. Strony muszą być sąsiednie, późniejszy fragment nie może otwierać się wierszem podpisu, a granice kolumn muszą się układać w granicach dwukrotności AlignmentTolerance — 6 punktów przy domyślnych. Gdy to wszystko trzyma się razem, wcześniejszy fragment staje się ptcStart ze świeżym numerem grupy albo przesuwa się z ptcEnd do ptcMiddle, jeśli już zamknął łańcuch, a późniejszy staje się ptcEnd w tej samej grupie. Tabela rozłożona na trzy strony czyta się start, middle, end. Numery grup zaczynają się od 1; grupa 0 z ptcNone znaczy, że tabela stoi sama. ToJson zapisuje te same dane jako "continuationGroup" i "continuation" (none, start, middle albo end), więc serwis odbierający JSON może sklejać sam
Listing poniżej zakłada eksport z Worda z dwuwierszową stopką na około 50 punktów głęboką, więc margines idzie na 54, żeby obie linie zostały w pasie
uses
  System.SysUtils, PDFium;

var
  Pdf: TPdf;
  Options: TPdfTableExtractionOptions;
  Tables: TPdfTables;
  I: Integer;
begin
  Pdf := TPdf.Create(nil);
  try
    Pdf.FileName := 'itinerary-from-word.pdf';
    Pdf.LoadDocument;

    Options := TPdfTableExtractionOptions.Default;  // DetectContinuations = True
    Options.ContinuationMargin := 54;               // stopka zakładana na ~50 pt głębokości

    Tables := Pdf.ExtractDocumentTables(Options);
    for I := 0 to High(Tables) do
      case Tables[I].Continuation of
        ptcStart:
          Writeln(Format('group %d starts on page %d, %d rows',
            [Tables[I].ContinuationGroup, Tables[I].PageNumber,
             Tables[I].RowCount]));
        ptcMiddle, ptcEnd:
          Writeln(Format('group %d continues on page %d, %d rows',
            [Tables[I].ContinuationGroup, Tables[I].PageNumber,
             Tables[I].RowCount]));
      else
        Writeln(Format('standalone table on page %d, %d x %d',
          [Tables[I].PageNumber, Tables[I].RowCount,
           Tables[I].ColumnCount]));
      end;
  finally
    Pdf.Free;
  end;
end.
Jak pełnoszerokościowy pierwszy wiersz trzyma dwie tabele osobno
Późniejszy fragment, którego pierwszy wiersz to pojedyncza komórka obejmująca każdą kolumnę, jest zgłaszany jako nowa tabela, nawet gdy test brzegowy przechodzi, a kolumny się zgadzają. Formularze to miejsce, gdzie test świadomy treści by się przejął: jedna tabela kończy się pod dołem strony 1, następna sekcja otwiera się na stronie 2 z identycznymi szerokościami kolumn i każdy test geometryczny przechodzi. Różnica to wiersz otwierający drugiej tabeli — podpis sekcji taki jak RECIPIENT INFORMATION ułożony jako jedna scalona komórka na pełną szerokość. Prawdziwa kontynuacja tak się nie otwiera, bo podpis tabeli zostaje na stronie, na której tabela się zaczyna
Reguła czyta wyłącznie komórki późniejszego fragmentu. Ten fragment potrzebuje co najmniej dwóch kolumn i komórki z RowIndex = 0, ColumnIndex = 0 i ColumnSpan = ColumnCount. Wcześniejszy fragment nigdy nie jest oglądany, więc tabela, której własny podpis siedzi na górze strony N, łączy się normalnie ze swoją kontynuacją na stronie N+1
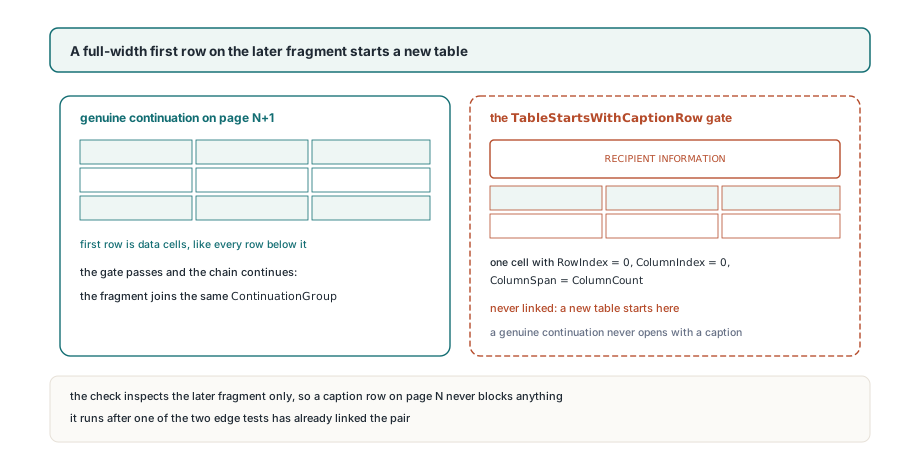
Porównanie kolumn, które idzie potem, jest ostrzejsze niż równe liczby kolumn. Pozycje granic każdego fragmentu są odbudowywane z prostokątów jego komórek; granica schowana pod scaloną komórką jest uzupełniana przez równomierne rozłożenie jej między najbliższe znane granice po obu stronach. Potem każda para granic jest porównywana, a różnica ponad 6 punktów odrzuca łącze. Dwa czterokolumnowe tabele o różnych proporcjach zostają osobno. Także prawdziwa kontynuacja, której generator przesunął kolumnę o 8 punktów między stronami; podniesienie AlignmentTolerance, by ją przyjąć, rozluźnia zarazem klastrowanie używane przy detekcji
Jeden wiersz siatki przez złamanie strony
Siatka z liniami, która przepycha pojedynczy wiersz na następną stronę, zachowuje ten wiersz, gdy wchodzi do łańcucha, i traci go, gdy nie wchodzi. Domyślne MinRows równe 2 powstrzymuje parę zabłąkanych linii od zgłoszenia jako tabela. Wiersz przepchnięty przez złamanie jest inny: to prawdziwe dane, a jego wyrzucenie zostawiłoby sklejoną tabelę o jeden wiersz za krótką, bez fragmentu, który tłumaczyłby lukę
Skan dokumentu obsługuje to w trzech krokach. Gdy DetectContinuations i DetectRuledTables są oba włączone, detektor siatek biegnie na każdej stronie z progiem wierszy obniżonym do 1. Kontynuacje są potem oznaczane na całym wyniku. Na końcu każda tabela o mniej wierszach niż MinRows wołającego, która nie wylądowała w łańcuchu, jest usuwana. Jednowierszowa siatka w środku zwykłej strony przechodzi przez ten filtr i znika — dokładnie po to MinRows jest
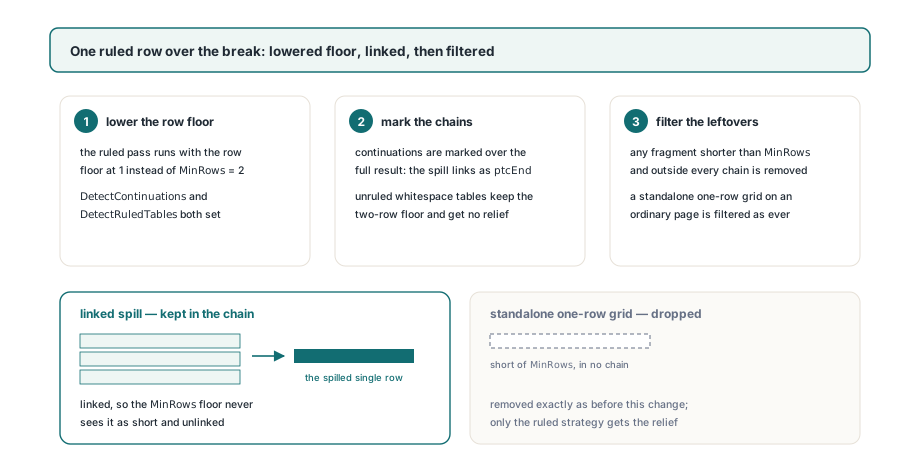
Zostaw MinRows na 2. Ustawienie go samemu na 1 wyłącza filtr końcowy i każda jednowierszowa siatka z liniami na każdej stronie wraca
Wyjątek dotyczy wyłącznie siatek z liniami. Strategia białych znaków potrzebuje co najmniej dwóch wyrównanych wierszy, by rozpoznać tabelę, więc trzyma wewnętrzny próg 2, cokolwiek mówi MinRows; ExtractTables przyjmuje MinRows = 1, ale honoruje go tylko detekcja siatek. Dla tabeli bez linii, która przelewa jeden wiersz, ramki słów strony albo bloki opisane w artykule o blokach tekstu strukturalnego i kolejności czytania dają ci pozycje, żeby odzyskać ten wiersz samemu
Sklejanie łańcucha z powrotem w jedną tabelę
Łańcuchy wracają jako ciągłe. Łącza są robione wyłącznie między sąsiadami w posortowanej tablicy, więc fragment ptcStart jest bezpośrednio śledzony przez swoje fragmenty ptcMiddle i ptcEnd, a pętla, która resetuje na ptcNone albo ptcStart i zapisuje na ptcNone albo ptcEnd, nigdy nie musi niczego wyszukiwać po numerze grupy
Powtarzany wiersz nagłówka to kruczki: Word może powtarzać go na każdej stronie, inne generatory nie. Flaga IsHeader na TPdfTableCell nie rozstrzyga, bo jest przypisywana z pozycji, RowIndex < HeaderRowCount, osobno dla każdego fragmentu. Wiersz 0 kontynuacji jest flagowany jako nagłówek, czy powtarza nagłówek, czy niesie dane, i jednowierszowy przelew z poprzedniej sekcji jest flagowany także. Procedura poniżej porównuje tekst pierwszego wiersza każdej kontynuacji z pierwszym wierszem łańcucha i wyrzuca go wyłącznie przy dokładnym dopasowaniu
Buduje też wiersze z Cells zamiast rozbijać wyjście ToCsv na linie. Komórka, której tekst łamie się wewnątrz komórki, wraca z CR LF między swoimi liniami wizualnymi, ToCsv zachowuje to złamanie wewnątrz pola w cudzysłowie, a skasowanie pierwszej linii tekstu CSV przecięłoby dwulinijkową komórkę nagłówka na pół
// Pomocniki strony czytającej (nie część biblioteki): odbuduj każdy łańcuch
// jako jeden plik rozdzielany tabulatorami, wyrzucając nagłówki powtórzone na dalszych stronach
function RowText(const T: TPdfTable; Row: Integer): string;
var
  Parts: array of string;
  I: Integer;
begin
  SetLength(Parts, T.ColumnCount);
  for I := 0 to High(T.Cells) do
    if (T.Cells[I].RowIndex = Row) and (T.Cells[I].ColumnIndex >= 0) and
       (T.Cells[I].ColumnIndex < T.ColumnCount) then
      Parts[T.Cells[I].ColumnIndex] :=
        StringReplace(string(T.Cells[I].Text), #13#10, ' ', [rfReplaceAll]);
  Result := '';
  for I := 0 to High(Parts) do
  begin
    if I > 0 then
      Result := Result + #9;
    Result := Result + Parts[I];
  end;
end;

procedure ExportChains(const Tables: TPdfTables; const Folder: string);
var
  I, R, FirstRow: Integer;
  Header: string;
  Lines: TStringList;
begin
  Lines := TStringList.Create;
  try
    for I := 0 to High(Tables) do
    begin
      FirstRow := 0;
      if Tables[I].Continuation in [ptcNone, ptcStart] then
      begin
        Lines.Clear;
        Header := RowText(Tables[I], 0);
      end
      else if (Trim(Header) <> '') and (RowText(Tables[I], 0) = Header) then
        FirstRow := 1;                     // nagłówek powtórzony na tej stronie
      for R := FirstRow to Tables[I].RowCount - 1 do
        Lines.Add(RowText(Tables[I], R));
      if Tables[I].Continuation in [ptcNone, ptcEnd] then
        Lines.SaveToFile(Format('%s\table%d-page%d.tsv',
          [Folder, I, Tables[I].PageNumber]));
    end;
  finally
    Lines.Free;
  end;
end;
Dokładne porównanie to właściwy wybór. Nagłówek powtórzony przez edytor tekstu zgadza się znak w znak, podczas gdy dopasowanie rozmyte prędzej czy później połknie wiersz danych przypominający nagłówek. Zabłąkany nadmiarowy nagłówek łatwo wychwycić w wyjściu; brakującego wiersza danych już nie
Zmierzenie pasa stopki zamiast zgadywania
ContinuationMargin robi trzy roboty jedną liczbą: luz krawędzi strony dla pierwszego testu, głębokość pasa stopki i głębokość pasa nagłówka dla drugiego. Stopka głębsza niż pas zostawia swoją górną linię w strefie treści, wcześniejszy fragment wygląda, jakby tekst szedł po nim, i łańcuch pęka na tej stronie. Pas ustawiony za głęboko zaczyna połykać prawdziwą treść: krótka linia kończąca tuż nad dolnym marginesem wpada do środka, a tabela nad tą linią może się wtedy połączyć z czymkolwiek, co otwiera następną stronę
Dokument sam może podać liczbę. TPdf.PageWordBoxes zwraca każde słowo na bieżącej stronie z Rectem w przestrzeni strony, którego Top jest większe od Bottom, więc najwyższe Top pośród słów leżących pod marginesem treści to głębokość stopki. Sonda poniżej bierze wartość tuż pod dolnym marginesem układu — 70 dla strony na cal — i trzyma 36 punktów jako podłogę dla dokumentów bez stopki
// Pomocnik strony czytającej (nie część biblioteki): najwyższa góra słowa
// znaleziona pod BodyMargin na dowolnej stronie, czyli głębokość strefy stopki
function MeasureFooterDepth(Pdf: TPdf; BodyMargin: Double): Double;
var
  P, I: Integer;
  Words: TPdfWordBoxes;
begin
  Result := 0;
  for P := 1 to Pdf.PageCount do
  begin
    Pdf.PageNumber := P;
    Words := Pdf.PageWordBoxes;
    for I := 0 to High(Words) do
      if (Words[I].Rect.Bottom < BodyMargin) and
         (Words[I].Rect.Top > Result) then
        Result := Words[I].Rect.Top;
  end;
end;

// uses System.Math dla Max
Options := TPdfTableExtractionOptions.Default;
Options.ContinuationMargin := Max(36.0, MeasureFooterDepth(Pdf, 70) + 2);
Tables := Pdf.ExtractDocumentTables(Options);
Pas ma tę samą głębokość przy obu krawędziach, więc zmierz głęboki powtarzany nagłówek także względem góry strony i użyj wartości większej. Trzymaj luz na parę punktów; każdy dodatkowy punkt to punkt tekstu treści, którego test świadomy treści przestaje widzieć
Jeden układ obchodzi regułę podpisu z konstrukcji: generator, który zapisuje scalony baner „continued” jako pierwszy wiersz każdego fragmentu kontynuacji. Każdy taki fragment jest zgłaszany jako nowa tabela, więc łącz je we własnym kodzie z kolejnych numerów stron, równych ColumnCount i tekstu banera w wierszu 0
Oznaczanie kontynuacji, reguła podpisu i wyjątek jednego wiersza biegą wszystkie wewnątrz ExtractDocumentTables, która zachowuje się tak samo w buildach Delphi, C++Builder i Lazarus. Pełen zestaw opcji wyciągania tabel jest wypisany na stronie PDFium Component for Delphi