Numer obiektu 1 to nie strona 1. Ta jedna fakt wysypuje więcej kodu przetwarzającego PDF niż jakakolwiek inna część formatu, a powód pokazuje się dopiero wtedy, gdy przestaniesz patrzeć na to, co renderuje przeglądarka, a zaczniesz patrzeć na graf obiektów, który przeglądarka faktycznie czyta
Plik PDF to zbiór numerowanych obiektów pośrednich. Każdy niesie numer obiektu i numer generacji, a inne obiekty wskazują go odwołaniem zapisywanym jako N G R — 3 0 R znaczy bieżącą wersję obiektu 3. Strony są obiektami jak każde inne, ale gdzie siedzą w pliku i jakie numery niosą, nie mówi nic o kolejności wyświetlania. Kolejność pochodzi z drzewa /Pages. Przeskanuj obiekty numerycznie, a dla niemałej części prawdziwych plików złożysz strony w złej sekwencji
Drzewo to też miejsce, gdzie mieszka dużo mniej oczywistych zachowań. Jego kształt rozstrzyga, jak szybko przeglądarka skoczy do strony 8214, jego węzły wewnętrzne po cichu podają rozmiar strony i czcionki w dół liściom pod sobą, a sumy /Count, które czynią całą strukturę szybką, nie są wymuszane przez nic w ogóle. Przejdziemy przez wszystkie trzy, zaczynając od samej kolejności
Drzewo stron rozstrzyga kolejność
Każdy PDF ma katalog dokumentu (ISO 32000-2 §7.7.2), a wpis /Pages katalogu wskazuje węzeł korzeniowy drzewa stron. Ten korzeń to słownik z /Type /Pages, tablicą /Kids odwołań pośrednich i /Count podającym liczbę stron-liści pod nim. Kolejność wyświetlania to przejście po tym drzewie w głąb, od lewej do prawej. To cała reguła
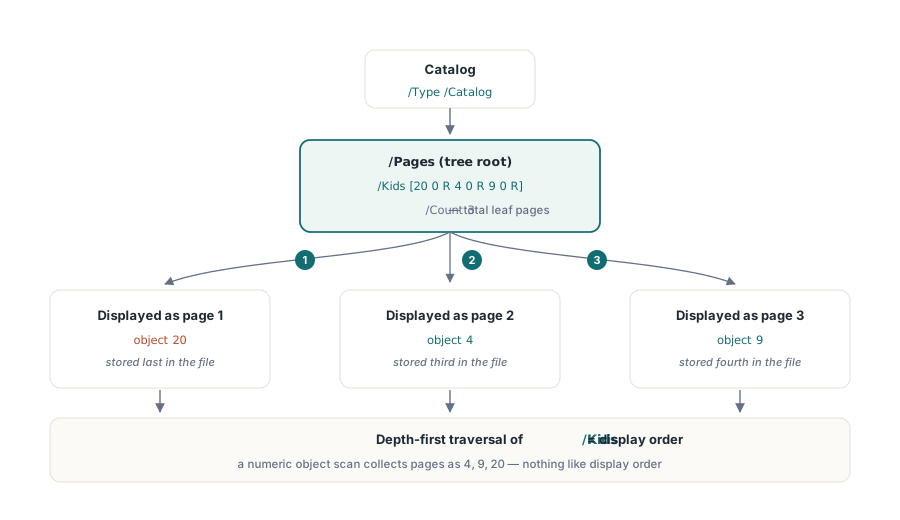
Minimalny plik o trzech stronach czyni to konkretnym:
%PDF-1.7

1 0 obj
<< /Type /Catalog /Pages 2 0 R >>
endobj

2 0 obj
<< /Type /Pages /Kids [20 0 R  4 0 R  9 0 R] /Count 3 >>
endobj

% Obiekt 4 jest zapisany trzeci w pliku, ale jest stroną 2 w kolejności wyświetlania
4 0 obj
<< /Type /Page /Parent 2 0 R /MediaBox [0 0 612 792]
   /Contents 5 0 R /Resources << /Font << /F1 6 0 R >> >> >>
endobj

% Obiekt 9 jest zapisany czwarty, ale jest stroną 3
9 0 obj
<< /Type /Page /Parent 2 0 R /MediaBox [0 0 612 792]
   /Contents 10 0 R /Resources << /Font << /F1 6 0 R >> >> >>
endobj

% Obiekt 20 jest zapisany ostatni, ale jest stroną 1; decyduje Kids[0], nie numer obiektu
20 0 obj
<< /Type /Page /Parent 2 0 R /MediaBox [0 0 612 792]
   /Contents 21 0 R /Resources << /Font << /F1 6 0 R >> >> >>
endobj
Tablica /Kids czyta się [20 0 R 4 0 R 9 0 R], więc obiekt 20 jest stroną 1, obiekt 4 stroną 2, a obiekt 9 stroną 3. Kod, który iteruje obiekty w porządku numerycznym i zbiera wszystko z /Type /Page, robi z tym plikiem błąd. Gorzej, że wyjście nadal wygląda wiarygodnie: właściwa liczba stron, rozpoznawalna treść na każdej stronie, zła sekwencja
Generatory tworzą takie układy z całkiem zwykłych powodów. Biblioteka, która rezerwuje numery obiektów dla wszystkich stron z góry, numeruje je w kolejności tworzenia, a potem zapisuje bajty w dowolnej kolejności, jaka pasuje jej serializatorowi. Narzędzie do łączenia przenumerowuje obiekty z każdego dokumentu źródłowego, by uniknąć kolizji, więc obiekty stron kończą porozrzucane po połączonej tabeli obiektów, podczas gdy nowa korzeniowa tablica /Kids trzyma właściwą sekwencję. A aktualizacje przyrostowe dopisują nowe obiekty na końcu pliku ze świeżymi numerami, więc strona dodana w rewizji mieszka blisko końca strumienia bajtów, nawet gdy należy na pozycję 1
Ten ostatni przypadek to ten, który gryzie. Korpus testowy wytworzony przez jedno narzędzie może przechodzić kompletnie, a potem pliki z przepływu scalania albo dokumenty, które przeszły przez kilka rewizji, wychodzą przetasowane. Poprawki heurystyczne się nie trzymają, bo porażka zależy od generatora i od historii edycji pliku. Prawdziwa poprawka jest krótka: zacznij od katalogu, rozwiąż /Pages, przechodź /Kids rekurencyjnie i wypisuj liście w kolejności, w jakiej je spotykasz. Nasze studium przypadku debugowania kolejności stron podąża za dokładnie tym objawem przez błędną diagnozę aż do przyczyny źródłowej, z rekurencyjnym kodem przejścia i krokami qpdf do sprawdzenia wyniku
Rozgałęzianie to decyzja wydajnościowa
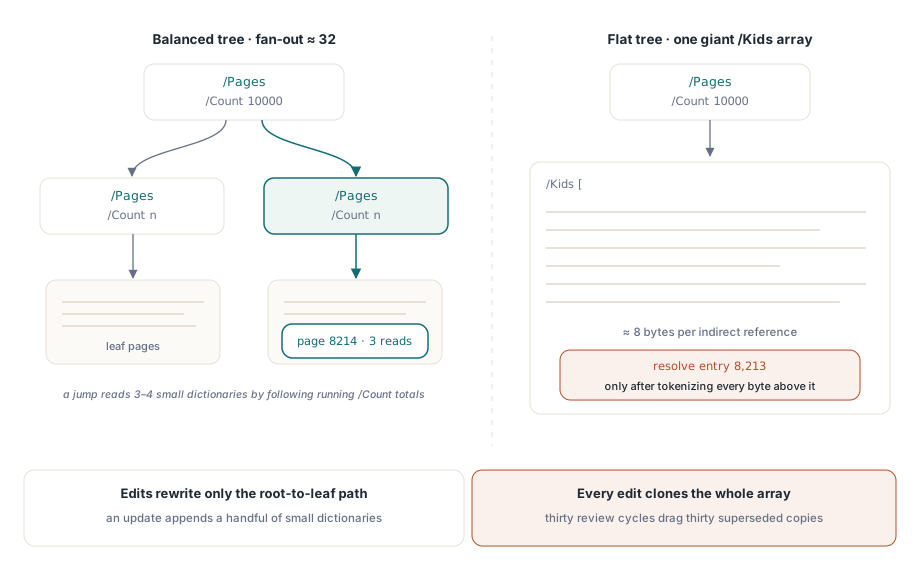
Specyfikacja pozwala na dwa kształty. Proste generatory wypuszczają płaskie drzewo: jeden korzeń /Pages, którego /Kids nie trzyma niczego poza liśćmi /Page. Nic nie zmusza zapisującego do zagnieżdżania, a dokument o 10 000 stron z 10 000 odwołaniami do liści w pojedynczej tablicy jest zgodny. PDF Reference mimo to zaleca zrównoważone drzewo dla dużych dokumentów, a główne generatory stosują się do tej rady z umiarkowanym rozgałęzieniem — zwykle po kilkadziesiąt dzieci na węzeł pośredni, gdzie każdy węzeł pośredni ma swoje /Kids i swoje /Count
Powodem jest to, co przeglądarka musi przeczytać, zanim cokolwiek pokaże. Weź przeskok wprost do strony 8214 tego pliku o 10 000 stron. Przy płaskim drzewie przeglądarka musi najpierw sparsować korzeń, a korzeń to jedna ogromna tablica: przy około ośmiu bajtach na odwołanie pośrednie jest to obiekt o rozmiarze 80 KB, który trzeba stokenizować od początku do końca, zanim wpis 8213 się rozwiąże. Przy zrównoważonym drzewie o rozgałęzieniu 32 ten sam przeskok czyta korzeń, porównuje bieżące sumy /Count, by wybrać właściwe dziecko, i schodzi w dół. Trzy albo cztery małe słowniki, każdy po kilkaset bajtów. Ten swobodny dostęp O(log n) to to, do zapewnienia czego drzewo zostało zaprojektowane, i to jest cały powód, dla którego /Count istnieje na węzłach pośrednich — czytnik może pominąć całe poddrzewo bez otwierania ani jednego obiektu wewnątrz niego
Kształt drzewa wyznacza również koszt edycji. Aktualizacja przyrostowa, która wstawia jedną stronę, musi przepisać każdy węzeł, którego /Kids lub /Count uległy zmianie, co oznacza ścieżkę od rodzica nowego liścia w górę do korzenia. W zrównoważonym drzewie ta ścieżka to garstka małych słowników dołączonych do pliku. W płaskim drzewie „ścieżka” to pojedyncza gigantyczna tablica korzeniowa, powielana w całości przy każdej rewizji. Umowa, która przechodzi przez trzydzieści cykli recenzji i adnotacji, może w efekcie ciągnąć w swoim strumieniu bajtów trzydzieści zastąpionych kopii tej samej tablicy o rozmiarze 80 KB
Dla kodu przetwarzającego zagnieżdżenie ma ostrzejszą konsekwencję. Nie możesz zakładać, że pierwszy poziom /Kids zawiera strony, więc każde dziecko trzeba sprawdzić: /Type /Pages znaczy rekurencja, /Type /Page znaczy liść. Kod, który staje na pierwszym poziomie, działa na każdym płaskim pliku, jaki spotka, a potem po cichu gubi całe poddrzewa, gdy generator pierwszy raz zdecyduje się zagnieździć
Węzły wewnętrzne przenoszą atrybuty dziedziczone
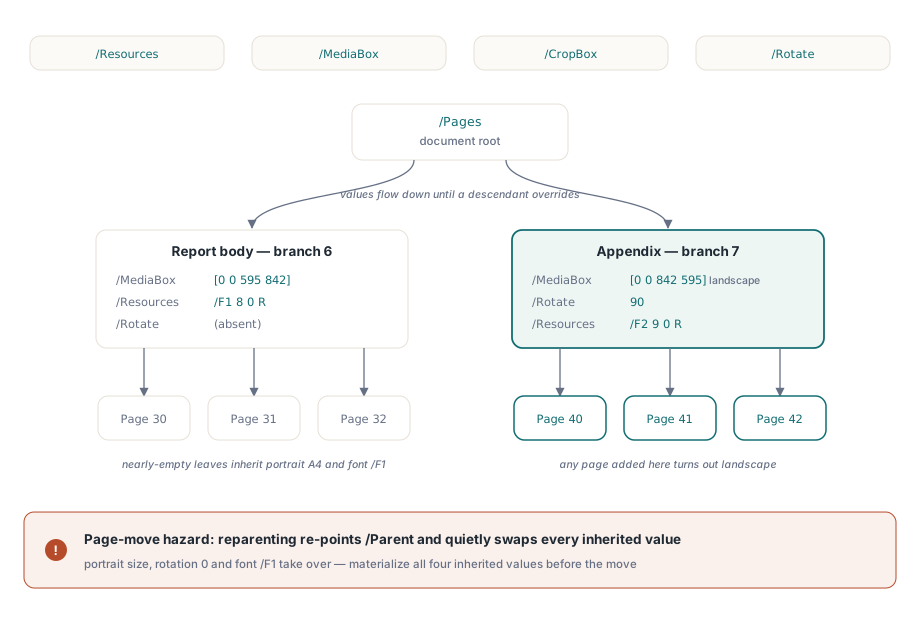
Węzły pośrednie robią więcej niż trasują wyszukiwania. Cztery atrybuty strony są dziedziczne (ISO 32000-2 §7.7.3.4): /Resources, /MediaBox, /CropBox i /Rotate. Każdy z nich może siedzieć na węźle /Pages, gdzie odnosi się do każdego liścia pod nim, chyba że potomek go nadpisze. Zapisujący, który tworzy raport z poziomym dodatkiem, może wyrazić ten układ w samym drzewie:
5 0 obj   % korzeń dokumentu
<< /Type /Pages /Count 6 /Kids [6 0 R  7 0 R] >>
endobj

6 0 obj   % treść raportu: pionowy A4, czcionka treści
<< /Type /Pages /Parent 5 0 R /Count 3
   /Kids [30 0 R  31 0 R  32 0 R]
   /MediaBox [0 0 595 842]
   /Resources << /Font << /F1 8 0 R >> >> >>
endobj

7 0 obj   % dodatek: poziomy A4, obrócony, z własną czcionką
<< /Type /Pages /Parent 5 0 R /Count 3
   /Kids [40 0 R  41 0 R  42 0 R]
   /MediaBox [0 0 842 595] /Rotate 90
   /Resources << /Font << /F2 9 0 R >> >> >>
endobj

40 0 obj  % strona dodatku: dziedziczy rozmiar, obrót, czcionki
<< /Type /Page /Parent 7 0 R /Contents 43 0 R >>
endobj
Obiekty od 40 do 42 są niemal puste. Ich rozmiar strony, obrót i zasoby czcionek docierają w drodze dziedziczenia z węzła 7, co utrzymuje plik zwarty i samoutrzymujący się: dodaj czwartą stronę pod węzłem załącznika, a wyjdzie ona automatycznie w orientacji poziomej
Znaczy to też, że właściwości strony nie wszystkie leżą na stronie. Obiekt 40 nie ma klucza /MediaBox, i to jest całkowicie legalne — czytnik, który traktuje brakujący klucz jako zniekształcone wejście, odrzuci poprawne pliki. Wyszukiwanie musi iść w górę łańcucha /Parent, aż znajdzie wpis albo dosięgnie korzenia. To przejście potrzebuje strażnika przed cyklami. Uszkodzony plik może nieść odwołanie /Parent wskazujące z powrotem na węzeł już odwiedzony, a bez zbioru odwiedzonych obiektów wyszukiwanie kręci się w kółko w nieskończoność
Ten sam mechanizm tworzy klasyczne zagrożenie przy przenoszeniu stron. Załóżmy, że narzędzie przenosi obiekt 40 do treści raportu, edytując dwie tablice /Kids i przekierowując /Parent na węzeł 6. Przeniesienie jest strukturalnie poprawne, a jednak obiekt 40 dziedziczy teraz pionowy /MediaBox, brak obrotu i czcionkę /F1 — podczas gdy jego strumień treści nadal wybiera /F2, która już się nie rozwiązuje. Strona kurczy się, przestaje być obrócona i traci swój tekst w jednej edycji. Solidny kod zmieniający kolejność materializuje więc rozwiązane wartości wszystkich czterech dziedzicznych atrybutów na słowniku strony przed zmianą jej rodzica. Jeśli kiedykolwiek przeciągnąłeś stronę w edytorze i patrzyłeś, jak zmienia rozmiar lub orientację, to właśnie ten mechanizm widziałeś
Spłaszczanie: legalne, powszechne, czasem kosztowne
Mnóstwo narzędzi działa w drugą stronę. Minimalistyczne generatory tworzą drzewo jednopoziomowe, bo to proste, a wiele narzędzi do łączenia i dzielenia przebudowuje dowolne odczytane drzewo w jedną płaską tablicę /Kids, ponieważ generowanie zrównoważonej struktury to dodatkowa praca, a płaskie wyjście jest zawsze zgodne. Poprawna przebudowa musi jednocześnie rozwiązać dziedziczenie: każdy atrybut, który liść dziedziczył, trzeba skopiować na liść albo wynieść do nowego korzenia, jeśli jest jednolity w całym dokumencie — w przeciwnym razie wyjście zmienia geometrię dokładnie tak, jak w przypadku przenoszenia strony
Dla typowych dokumentów spłaszczanie jest nieszkodliwe. Szkodzi przy skali, na dwa już opisane sposoby: tablica korzeniowa staje się jednym dużym obiektem, który każde otwarcie i każdy przeskok strony muszą sparsować w całości, a każda edycja strukturalna przepisuje ją w całości. Czego spłaszczanie nie niszczy, to współdzielenie przez odwołania pośrednie — płaskie drzewo, w którym wszystkie 10 000 stron wskazuje ten sam obiekt słownika /Resources, wciąż jest zdeduplikowane. Traci się jedynie opcję pominięcia wpisu na stronie i pozostawienia go przodkowi do dostarczenia
Gdy /Count kłamie
/Count to czyste księgowanie: musi być równe liczbie stron-liści w poddrzewie węzła, a nic w formacie pliku tego nie wymusza. Dwa wzorce uszkodzeń odpowiadają za większość kłamliwych liczników spotykanych w praktyce
Pierwszy to nieaktualny licznik pozostawiony przez aktualizację przyrostową. Edytor wstawia stronę, przepisuje bezpośredniego rodzica z nowym /Kids i zaktualizowanym /Count, dołącza oba do pliku — i nigdy nie tyka przodków:
% Pierwotna rewizja
12 0 obj
<< /Type /Pages /Count 9 /Kids [13 0 R  14 0 R  15 0 R] >>
endobj

14 0 obj
<< /Type /Pages /Parent 12 0 R /Count 3
   /Kids [50 0 R  51 0 R  52 0 R] >>
endobj

% Dołączona rewizja: jedna strona wstawiona do środkowej gałęzi.
% Obiekt 14 jest zastąpiony; obiekt 12 nigdy nie jest przepisywany
14 0 obj
<< /Type /Pages /Parent 12 0 R /Count 4
   /Kids [50 0 R  51 0 R  90 0 R  52 0 R] >>
endobj
Drzewo trzyma teraz dziesięć liści, ale korzeń nadal mówi dziewięć. Przeglądarka, która ufa korzeniowi, raportuje w swoim liczniku stron dziewięć stron. Ta, która używa liczników wewnętrznych do wyszukiwania binarnego przeskoku strony, oblicza błędny indeks dla każdej strony po punkcie wstawienia. Pełne przejście znajduje dziesięć. Trzy różne odpowiedzi, jeden plik
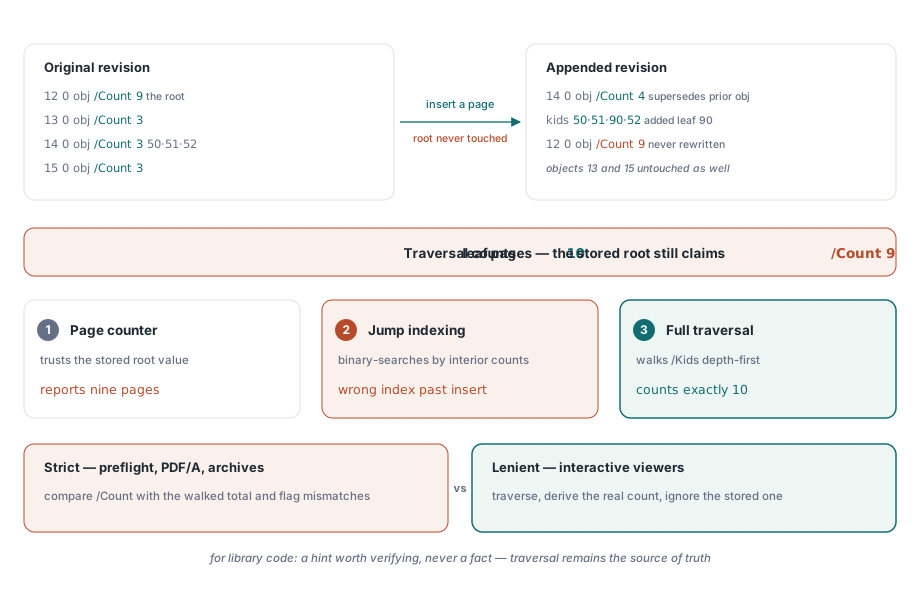
Jest cichszy sposób, by oberwać tym samym plikiem. Kod, który czyta korzeniowy licznik, rusza na przejście drzewa i staje, gdy zebrał tyle stron, nigdy nie zobaczy strony dziesiątej. Żadnego wyjątku, żadnego ostrzeżenia, po prostu dokument o jedną stronę za krótki. Używanie /Count jako granicy pętli albo sprawdzenia granic to błąd; przejście musi biec, dopóki drzewo się nie wyczerpie, cokolwiek mówi zapisana liczba
Drugi wzorzec to licznik, który nigdy nie mógł być poprawny: ujemny, zerowy na zapełnionym węźle albo absurdalnie wielki. Biorą się one z fuzzingu, z uszkodzeń transmisji, a czasem z błędów arytmetycznych w edytorach. Są niebezpieczne szczególnie dla kodu, który ufa /Count przy alokacji — wymiarowanie tablicy na podstawie /Count równego -3 w najlepszym razie zgłasza błąd zakresu, a zrobienie tego przy /Count równym dwa miliardy to alokacja typu odmowa usługi. Ta wartość to niezaufane wejście, jak każda inna liczba w pliku
Parsery dzielą się na dwa obozy w tej całej sprawie. Ścisłe konsumenty — narzędzia preflight, walidatory PDF/A, potoki archiwalne — porównują /Count z wynikiem przejścia i odrzucają lub oznaczają plik. Interaktywne przeglądarki są niemal powszechnie pobłażliwe: przechodzą drzewo, wyprowadzają rzeczywistą liczbę i po cichu ignorują tę zapisaną, co jest dokładnie powodem, dla którego plik z nieaktualnym licznikiem może krążyć latami bez skargi, aż spotka bardziej rygorystyczny parser wewnątrz jakiegoś zautomatyzowanego przepływu pracy. Dla kodu bibliotecznego uważamy, że złoty środek to właściwy domyślny wybór: używaj /Count jako wskazówki do prealokacji i do pomijania poddrzew, gdy został zweryfikowany, i pozostaw przejście drzewa jako źródło prawdy
W produkcji te porażki rzadko ogłaszają się jako problemy drzewa. Pokazują się jako przetasowane strony, brakująca strona na końcu scalenia albo strona, która zmienia rozmiar albo orientację po przestawieniu kolejności. Studium przypadku debugowania śledzi jedno takie zgłoszenie z powrotem przez drzewo. Dla otaczającej anatomii pliku (obiekty, tabele odwołań krzyżowych, trailer) punktem startu jest przegląd struktury pliku PDF
HotPDF Delphi Component radzi sobie z tym wszystkim wewnętrznie: przechodzi zagnieżdżone drzewa o dowolnej głębokości, rozwiązuje dziedziczone atrybuty, gdy strony są kopiowane lub przenoszone, i weryfikuje /Count względem rzeczywistej liczby liści zamiast mu ufać, więc indeksy stron w jego API zawsze oznaczają strony logiczne