Klasyczny objaw wygląda jak błąd o jedną pozycję: procedura kopiująca strony prosi o stronę 1 trzystronicowego dokumentu i za każdym razem dostaje stronę 2. Logika indeksowania wygląda dobrze. Wywołanie używa logicznego indeksu liczonego od zera, arytmetyka jest poprawna, warunki brzegowe w porządku. A mimo to za każdym razem wychodzi zła strona
Przyczyna wcale nie leży w kodzie kopiującym. Leży w sposobie, w jaki loader buduje swoją tablicę stron, i to jedna z najłatwiejszych pułapek parsowania PDF, w które można wpaść
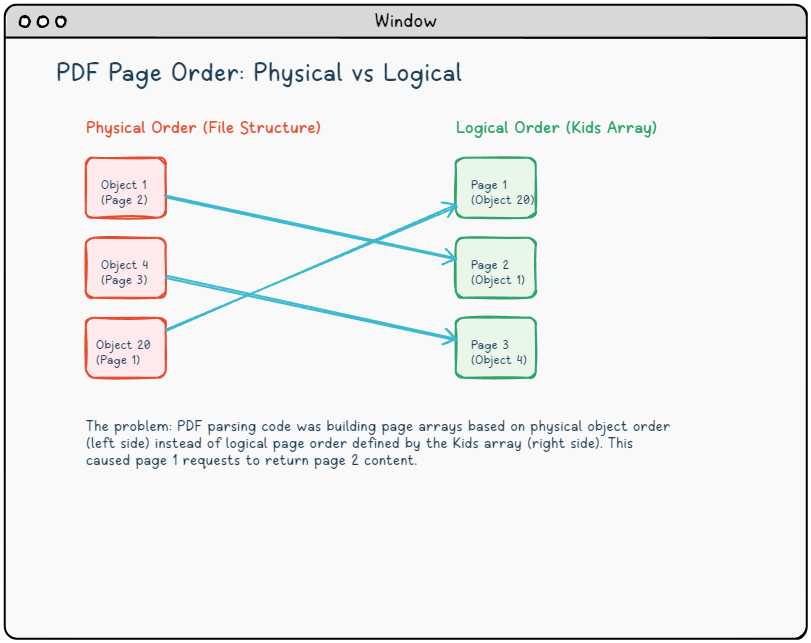
Dwa porządki, jedno źródło nieporozumień
Plik PDF to zbiór obiektów pośrednich, z których każdy jest identyfikowany numerem obiektu. Struktura pliku nie nakłada na te numery żadnego obowiązku odzwierciedlania kolejności czytania. Obiekt 1 może zawierać stronę 2; obiekt 20 może zawierać stronę 1. Tym, co faktycznie definiuje kolejność czytania, jest drzewo stron: hierarchia słowników /Pages, których tablice /Kids wymieniają odwołania do stron w kolejności, w jakiej przeglądarka powinna je wyświetlać (ISO 32000-1 §7.7.3)
Oto drzewo stron, które odsłania tę pułapkę:
{ Korzeń drzewa Pages, obiekt 16 }
16 0 obj
<<
  /Type /Pages
  /Count 3
  /Kids [20 0 R   { strona logiczna 1 }
         1 0 R    { strona logiczna 2 }
         4 0 R]   { strona logiczna 3 }
>>
endobj
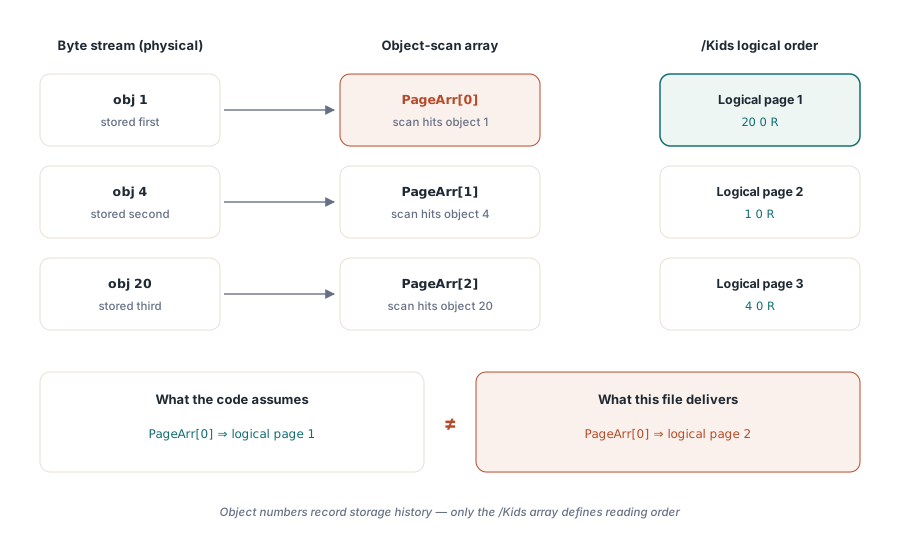
W tym pliku obiekt 1 i obiekt 4 znalazły się w strumieniu bajtów przed obiektem 20. Każdy parser, który przechodzi przez obiekty pośrednie w kolejności pliku i wpisuje je do PageArr w miarę napotykania słowników typu strona, skończy z obiektem 1 na indeksie 0, obiektem 4 na indeksie 1 i obiektem 20 na indeksie 2. Strona logiczna 1 siedzi wtedy pod PageArr[2]. Żądanie indeksu strony 0 pobiera zamiast niej stronę logiczną 2
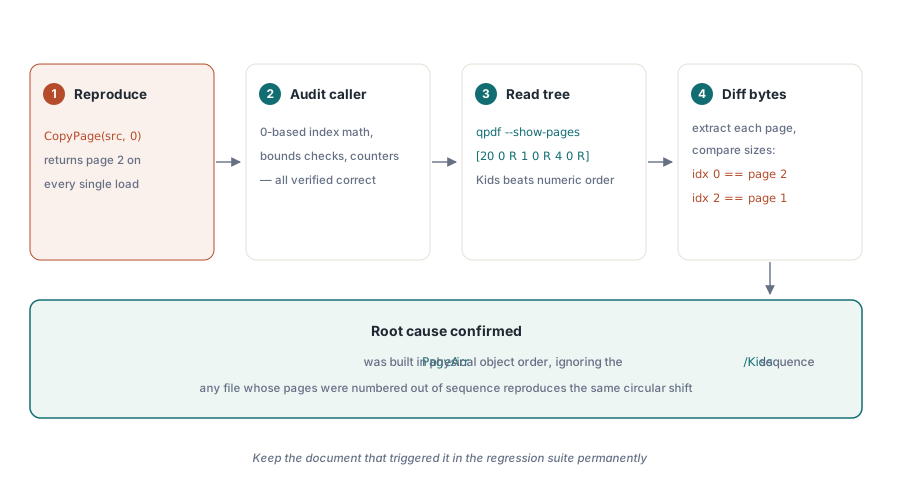
Potwierdzenie hipotezy
Zanim dotkniesz jakiegokolwiek kodu, udowodnij rozbieżność, zamiast ją zakładać. Narzędzie wiersza poleceń qpdf robi to w prosty sposób:
{ powłoka }
qpdf --show-pages input.pdf
{ Wynik ujawnia kolejność Kids: 20 0 R, potem 1 0 R, potem 4 0 R }

qpdf --show-object="16 0 R" input.pdf
{ Pokazuje słownik Pages z /Kids w kolejności czytania }
Wyodrębnienie każdej strony osobno i porównanie rozmiarów plików potwierdza to mapowanie: to, co produkuje skanujący obiekty PageArr[0], jest treścią należącą do logicznej strony 2, a PageArr[2] trzyma logiczną stronę 1. To cykliczne przesunięcie jest dymiącym pistoletem. Wyjaśnia też, dlaczego objaw pojawia się w wielu różnych dokumentach źródłowych: wywołuje go każdy plik PDF, w którym obiekty strony mają akurat niższe numery obiektów niż wcześniejsza strona logiczna
Jest prosty powód, dla którego pliki PDF trafiają w taki stan. Zapis przyrostowy zachowuje numery obiektów, które zmienia, ale wszystko, co dodaje — na przykład stronę tytułową wstawioną na przód — dostaje nowy numer powyżej wszystkiego, co już jest w pliku, a jego odwołanie trafia na początek tablicy Kids. Narzędzia scalające lub reorganizujące dokumenty renumerują obiekty w dowolnej dla siebie wygodnej kolejności. Niektóre generatory po prostu zapisują strony w kolejności wygodnej dla strumieniowania treści, a nie w logicznej sekwencji stron. Format PDF nie wymaga od żadnego z nich niczego innego
Poprawne podejście: podążanie za tablicą Kids
Listę stron buduj przez przejście łańcucha /Kids od korzenia katalogu, a nie przez skanowanie obiektów pośrednich. Przejście musi być rekurencyjne, bo duży dokument zwykle rozdziela strony pośrednimi węzłami /Pages, i powinno zabezpieczać się przed zniekształconym drzewem, które wskazuje z powrotem na własnego przodka. W szkicu poniżej TPdfDict i TPdfArray oznaczają dowolne typy słownika i tablicy, jakich używa twój parser:
type
  TPageList = array of TPdfDict;

procedure CollectPages(Node: TPdfDict; var Pages: TPageList;
  Depth: Integer = 0);
var
  Kids: TPdfArray;
  Child: TPdfDict;
  I: Integer;
begin
  if Depth > 64 then  // cykl albo patologicznie głębokie drzewo
    raise EPdfError.Create('Page tree too deep or cyclic');
  Kids := Node.GetArray('Kids');
  if Kids = nil then
    Exit;
  for I := 0 to Kids.Count - 1 do
  begin
    Child := Kids.ResolveDict(I);  // podążaj za odwołaniem pośrednim
    if Child = nil then
      Continue;
    if Child.GetName('Type') = 'Pages' then
      CollectPages(Child, Pages, Depth + 1)  // węzeł pośredni
    else
    begin
      SetLength(Pages, Length(Pages) + 1);   // liść: następna strona w kolejności wyświetlania
      Pages[High(Pages)] := Child;
    end;
  end;
end;

// Użycie: start od wpisu /Pages katalogu
SetLength(Pages, 0);
CollectPages(Catalog.ResolveDict('Pages'), Pages);
if Length(Pages) <> Catalog.ResolveDict('Pages').GetInteger('Count') then
  LogWarning('Page tree /Count disagrees with the pages actually found');
Dwa szczegóły są celowe. Liść bez wpisu /Type nadal jest traktowany jako strona, bo niektóre pisarki go pomijają, a przeglądarki i tak otwierają takie pliki. A końcowe porównanie /Count nic nie kosztuje, a łapie obcięte lub ręcznie edytowane drzewa, zanim wołający zaindeksuje w nie
Jeśli wczytujesz dokumenty przez HotPDF, ta kolejność jest już rozstrzygnięta w momencie wczytywania dokumentu: indeksy stron podążają za kolejnością wyświetlania drzewa stron, włącznie z zagnieżdżonymi węzłami /Pages, więc indeks 0 to zawsze pierwsza strona, którą pokazuje przeglądarka. Przejście z wcześniejszego szkicu ma znaczenie, gdy własny kod parsuje strukturę PDF bezpośrednio
Kopiowanie po indeksie logicznym z CopyPageFromDocument
Ponieważ HotPDF rozstrzyga kolejność stron w czasie wczytywania, logiczne indeksy stron znaczą to, czego oczekują wołający. Wyższego poziomu CopyPageFromDocument przyjmuje logiczny indeks liczony od zera i kopiuje właściwą stronę do dokumentu docelowego:
var
  Source, Dest: THotPDF;
begin
  Source := THotPDF.Create(nil);
  Dest   := THotPDF.Create(nil);
  try
    Source.LoadFromFile('source.pdf');

    Dest.FileName := 'extracted.pdf';
    Dest.BeginDoc;

    { Kopiuje logiczną stronę 0 (pierwsza strona widziana przez użytkownika) }
    Dest.CopyPageFromDocument(Source, 0, 0);

    Dest.EndDoc;
  finally
    Source.Free;
    Dest.Free;
  end;
end;
Ponieważ indeks jest indeksem kolejności wyświetlania, CopyPageFromDocument zachowuje się poprawnie nawet wobec dokumentów, w których kolejność fizyczna i logiczna się rozjeżdżają. Do operacji wsadowych InsertPagesFromDocument przyjmuje tablicę indeksów logicznych i kopiuje je w jednym przebiegu
Co to mówi o parsowaniu PDF
Specyfikacja PDF jest jednoznaczna: logiczna kolejność stron jest definiowana przez tablicę /Kids drzewa stron, a nie przez numery obiektów czy przesunięcia bajtowe (ISO 32000-1 §7.7.3.2). Każdy parser, który jako skrót używa innego porządkowania, da poprawne wyniki dla większości napotkanych dokumentów, ponieważ większość generatorów zapisuje strony w naturalnej kolejności i przypisuje sekwencyjne numery obiektów. Pomyłka ukrywa się, dopóki ktoś nie wczyta pliku PDF, który był edytowany przyrostowo, przeorganizowany przez inne narzędzie, albo wygenerowany przez oprogramowanie, które wybrało inny układ
Testowanie wyłącznie na plikach PDF wygenerowanych we własnym zakresie całkowicie pomija tę klasę problemów. Obsługa kolejności stron potrzebuje korpusu testowych dokumentów z różnorodnych źródeł: zapisów przyrostowych, zeskanowanych dokumentów ze wstawionymi stronami tytułowymi, plików PDF wyprodukowanych przez narzędzia, które linearyzują lub optymalizują graf obiektów inaczej. Każdy dokument, którego kolejność fizyczna i logiczna się rozjeżdżają, zasługuje na stałe miejsce w tym korpusie
Strona HotPDF Delphi Component obejmuje pełne API dla operacji na stronach, w tym CopyPageFromDocument, InsertPagesFromDocument i MovePage