Atrybut axis="rowAxis" na elemencie pivotField czyta się jak całkiem sensowny XML, a czytnik, który mapuje go na „pole wiersza”, wczyta pivot z każdym polem na właściwej osi. Przepuść tę samą część przez walidator zbudowany ze schematu ECMA-376 Part 1 §18.10, a zawiedzie on na pierwszym atrybucie: ST_Axis ma dokładnie cztery tokeny, axisRow, axisCol, axisPage i axisValues, a rowAxis nie jest żadnym z nich. Pisarz pivotów musi zadowolić schemat, a nie własnego czytnika, bo ludzie otwierający plik używają Excela i własnych parserów
Definicje pól pivot są pełne reguł jak ta. Trzy potrafią się przemyć przez test round-tripu: tokeny enumeracji, wymóg, by element items nigdy nie był pusty, i końcowe wpisy subtotal, które Excel wymienia po itemach danych. Dwie kolejne siedzą po stronie czytającej, w atrybutach, które Excel pomija, bo trzymają domyślną wartość ze schematu. Reszta artykułu przechodzi przez każdą regułę, pokazuje, jak musi wyglądać XML, i pokazuje wywołania Delphi, które go produkują
Dlaczego round-trip nie złapie złego tokenu osi
Round-trip dowodzi, że pisarz i czytnik zgadzają się ze sobą, i nic więcej. Jeśli czytnik akceptuje i axisRow, i rowAxis, pisarz emitujący zły przechodzi każdą kontrolę zapisz-i-wczytaj, jaką da się napisać, bo czytnik naprawia pomyłkę w drodze powrotnej. Wada wychodzi dopiero, gdy ostrzejszy konsument otwiera część: walidator schematu, parser wygenerowany z XSD albo Excel rozstrzygający, że część potrzebuje naprawy
HotXLS rozdziela te dwie strony celowo. Pisarz XLSX emituje tylko cztery tokeny ST_Axis, podczas gdy czytnik pivotów mapuje też anglojęzyczne pisownie rowAxis, colAxis, pageAxis i dataAxis na pasującą oś, więc pliki od producentów, którzy ich używają, nadal wczytują się z nietkniętym układem. Wyjście jest trzymane przy schemacie; wejście musi być tylko rozpoznawalne. Odwrotność — surowy czytnik z brudnym pisarzem — przynajmniej głośno zawiedzie we własnych testach; pobłażliwy czytnik z brudnym pisarzem zawiedzie nigdzie, gdzie widać
<!-- niepoprawne: rowAxis nie jest wartością ST_Axis, a CT_Items nie może być pusty -->
<pivotField axis="rowAxis" defaultSubtotal="1"><items count="0"></items></pivotField>

<!-- poprawne: token ST_Axis, prawdziwe itemy, końcowy subtotal domyślny -->
<pivotField axis="axisRow" defaultSubtotal="1">
  <items count="4"><item x="0"/><item x="1"/><item x="2" h="1"/><item t="default"/></items>
</pivotField>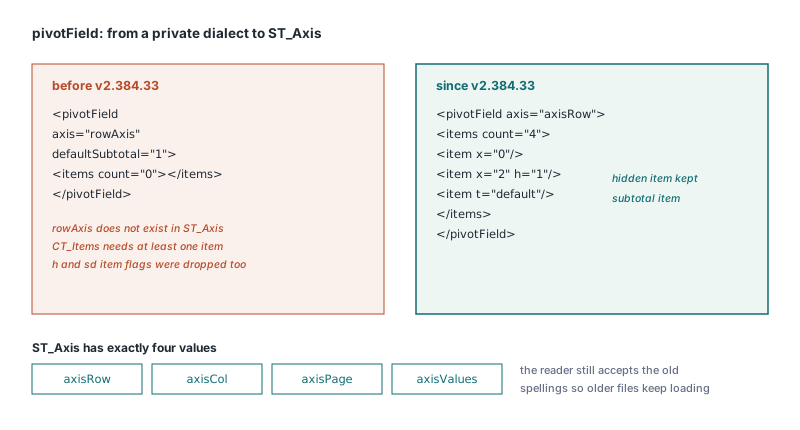
Czego CT_PivotField oczekuje poza osią
CT_PivotField ma jeszcze trzy wymagania, łatwe do zgubienia. Pole agregowane w obszarze wartości musi powiedzieć o tym na własnej definicji przez dataField="1", choć lista <dataFields> już się do niego odwołuje. HotXLS ustawia tę flagę na każdym polu pivotu, na które wskazuje wpis w DataFields, więc pole dodane przez AddDataFieldByName jest oznaczone w obu miejscach
Druga reguła jest strukturalna. CT_Items wymaga co najmniej jednego dziecka item, co czyni <items count="0"></items> niepoprawnym, choć to poprawnie sformowany XML parsowany wszędzie. Gdy pole nie ma itemów, HotXLS zostawia cały element items poza zapisem. Trzecia reguła dotyczy stanu na każdym itemie: ukryty członek niesie h="1", a członek ze zwiniętymi szczegółami niesie sd="0". Oba pochodzą z TXLSPivotItem.IsHidden i TXLSPivotItem.IsDetailHidden i są zapisywane przy każdym zapisie, więc filtr ustawiony w kodzie przeżywa do Excela
Końcowe itemy subtotal i pułapka licznika
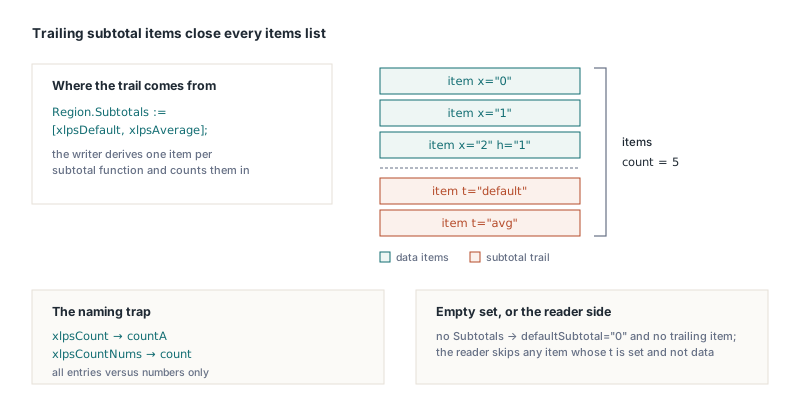
Gdy pole ma itemy, Excel podąża za itemami danych z jednym dodatkowym item na funkcję subtotal, typowanym przez ST_ItemType. Subtotal automatyczny to <item t="default"/>; funkcje jawne używają sum, countA, avg, max, min, product, count, stdDev, stdDevP, var i varP. Te wpisy nie niosą indeksu x do cache i wliczają się do atrybutu count elementu items. Pisarz, który je pominie, produkuje listę items, która już nie zgadza się z flagami subtotal na tym samym elemencie
HotXLS wyprowadza ogon z TXLSPivotField.Subtotals przy zapisie: jeden item t="…" na funkcję w zbiorze, w kolejności enumeracji, dodany do licznika, plus pasujący atrybut w stylu sumSubtotal="1" na polu. Pola stworzone przez AddPivotTable startują z pustym zbiorem, co zapisuje defaultSubtotal="0" i żaden końcowy item w ogóle. Dla generowanych raportów zostaw zbiór pusty: wiersze subtotal zmieniają wysokość pivotu i przesuwają wszystko położone pod nim. Dodawaj funkcje do Subtotals tylko na polach, gdzie czytający potrzebuje dodatkowych wierszy
Nazewnictwo zasługuje na drugie spojrzenie, zanim wybierzesz funkcję. xlpsCount mapuje się na countA, który liczy wszystkie niepuste wpisy, a xlpsCountNums mapuje się na count, który liczy tylko liczby. Ktokolwiek przeczyta „count” w XML i sięgnie po xlpsCount, dostanie drugą funkcję
Program poniżej buduje pivot z istniejącego arkusza danych z polem wiersza, polem kolumny i jednym polem wartości. Pole Region dostaje subtotal automatyczny plus średnią, co produkuje dwa końcowe itemy po jego itemach danych oraz dataField="1" na Revenue
uses
  SysUtils, lxHandleX, lxPivot;

var
  Book  : TXLSXWorkbook;
  Sheet : TXLSXWorksheet;
  Pivot : TXLSPivotTable;
  Region: TXLSPivotField;
begin
  Book := TXLSXWorkbook.Create;
  try
    Book.Open('orders.xlsx');
    Sheet := Book.Sheets[1];                  // Sheets numeruje od 1
    Pivot := Sheet.AddPivotTable('Data!$A$1:$D$800', 3, 6, 'RegionTotals');
    if Pivot = nil then
      raise Exception.Create('Bad source range or anchor');

    Region := Pivot.AddRowField('Region');    // nil, gdy nie ma takiego pola
    if Region <> nil then
      Region.Subtotals := [xlpsDefault, xlpsAverage];  // -> t="default", t="avg"
    Pivot.AddColumnField('Quarter');
    Pivot.AddDataFieldByName('Revenue', xlpaSum);      // Revenue dostaje dataField="1"

    Book.SaveAs('orders-pivot.xlsx');
  finally
    Book.Free;
  end;
end;
Czytanie tego, co Excel pomija
Czytnik ma problem w lustrzanym odbiciu. Pole pivotu z Excela wymienia swoje wpisy subtotal w items, a wczytanie ich jako zwykłych członków dałoby polu fantomowe itemy wskazujące w próżnię cache. HotXLS pomija każdy item, którego atrybut t jest obecny i nie jest data, co pokrywa wpisy subtotal, grand-total i puste. Funkcje subtotal przychodzą przez własne flagi pola i lądują w Subtotals, więc kod chodzący po Items widzi tylko prawdziwych członków, a każdy CacheItemIndex odwołuje się do wartości cache
Brakujące atrybuty to druga połowa. W schemacie defaultSubtotal na CT_PivotField i containsString na CT_SharedItems oba mają domyślnie true, i Excel je pomija, gdy trzymają tę wartość. HotXLS czyta nieobecne defaultSubtotal jako true i dodaje xlpsDefault do Subtotals, gdy pole nie niesie jawnych flag subtotal — tak właśnie Excel sam wyświetla takie pole. Nieobecne containsString też czyta się jako true, więc zwykłe pole tekstowe cache jest klasyfikowane jako dane napisowe. Odczytanie któregokolwiek atrybutu jako false sprawia, że każdy pivot zapisany przez Excela traci automatyczne subtotale przy wczytaniu, a pola tekstowe zamieniają się w inny typ. Pisarz, który zawsze rozpisuje każdy atrybut, nigdy nie dotyka tej ścieżki; ćwiczą ją tylko pliki od innego producenta
Załadowany skoroszyt z Excela to właściwe wejście testowe, bo to jedyny rodzaj pliku, który pomija te atrybuty. Kontrola niżej otwiera jeden i przechodzi pole wiersza:
var
  Book : TXLSXWorkbook;
  Pivot: TXLSPivotTable;
  Fld  : TXLSPivotField;
  I, J : Integer;
begin
  Book := TXLSXWorkbook.Create;
  try
    Book.Open('saved-by-excel.xlsx');
    Pivot := Book.Sheets[1].PivotTables.FindByName('PivotTable1');
    if Pivot = nil then
      Exit;
    for I := 0 to Pivot.FieldCount - 1 do
    begin
      Fld := Pivot.Fields[I];
      if Fld.Axis <> xlpfaRowField then
        Continue;
      // Pole Excela bez atrybutów subtotal nadal raportuje default
      if xlpsDefault in Fld.Subtotals then
        Writeln(Fld.Name, ': automatic subtotal');
      // Wpisy subtotal były pomijane, więc każdy item mapuje się na wartość cache
      for J := 0 to Fld.ItemCount - 1 do
        Assert(Fld.Items[J].CacheItemIndex >= 0);  // kontrola sugerowana do twoich własnych testów
    end;
  finally
    Book.Free;
  end;
end;
Dlaczego numFmtId="General" jest niepoprawne na polach cache
numFmtId="General" jest niepoprawne, bo ST_NumFmtId jest liczbą całkowitą bez znaku, jakkolwiek naturalnie brałoby się nazwę, którą użytkownicy widzą w oknie Format Cells. Parser typujący atrybuty ze schematu odrzuca nazwę w progu, a ta klasa awarii to dokładnie to, co zamienia się w dialog naprawy w Excelu; artykuł o regułach OPC i markupu za monitem naprawy Excela omawia, jak te dialogi są wyzwalane. HotXLS zapisuje każdy cacheField z numerycznym numFmtId wziętym z NumberFormat pola cache, czyli 0, wbudowany format General, chyba że coś go ustawiło
Tabele pivot poniżej wiersza 65535 potrzebują pozycji 32-bitowych
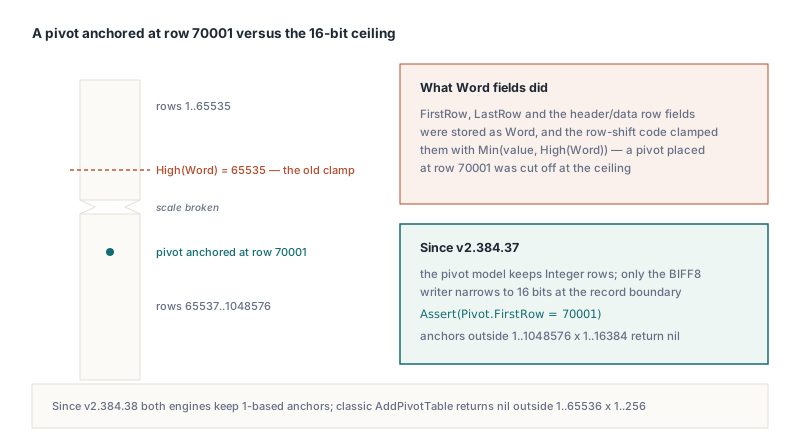
Model pivotu współdzielony przez silniki XLS i XLSX kusi, by pożyczyć szerokości pól z rekordu BIFF8 SxView, gdzie 16 bitów pokrywa każdy wiersz, jaki klasyczny arkusz może trzymać. Arkusz XLSX biegnie do 1 048 576 wierszy. Trzymaj FirstRow, LastRow, FirstHeaderRow, FirstDataRow i odpowiedniki kolumnowe jako Word, docinaj je przez Min(Value, High(Word)), a pivot zakotwiczony w wierszu 70001 zostaje ucięty na 65535
Na TXLSPivotTable te właściwości są Integer, i tylko pisarz BIFF8 zawęża je na granicy rekordu. TXLSXWorksheet.AddPivotTable zwraca nil dla kotwicy poza 1..1048576 na 1..16384, a AddPivotTableCopy zwraca nil, gdy rozpiętość kopii zbiegłaby poza siatkę
var
  Book, Check: TXLSXWorkbook;
  Pivot      : TXLSPivotTable;
begin
  Book := TXLSXWorkbook.Create;
  try
    Book.Open('orders.xlsx');
    // Wiersz 70001 jest poza zakresem 16 bitów
    Pivot := Book.Sheets[1].AddPivotTable('Data!$A$1:$D$800', 70001, 1, 'LateTotals');
    if Pivot = nil then
      Exit;  // kotwica poza arkuszem albo nierozwiązywalny zakres źródłowy
    Pivot.AddRowField('Region');
    Pivot.AddDataFieldByName('Revenue', xlpaSum);
    Book.SaveAs('late.xlsx');
  finally
    Book.Free;
  end;

  Check := TXLSXWorkbook.Create;
  try
    Check.Open('late.xlsx');
    Pivot := Check.Sheets[1].PivotTables.FindByName('LateTotals');
    // Assert to kontrola sugerowana do twoich własnych testów
    Assert((Pivot <> nil) and (Pivot.FirstRow = 70001));
  finally
    Check.Free;
  end;
end;
Klasyczny silnik XLS podąża za tą samą konwencją od 1. Rekordy SxView i DConRef trzymają wartości od 0, podczas gdy model, jak silnik XLSX i Cells[Row, Col], trzyma pozycje od 1: czytnik BIFF8 dodaje 1, a pisarz odejmuje 1 na granicy rekordu. Klasyczne AddPivotTable zwraca nil dla kotwicy poza 1..65536 na 1..256, więc kotwicz pivotty w (1, 1), a nie w (0, 0). Sam układ rekordów jest opisany w rekordach SX BIFF8 za klasycznymi pivotami .xls
Testowanie względem schematu zamiast własnego czytnika
Każda pułapka wyżej przeżywa round-trip, gdy pobłażliwa strona i wadliwa strona mieszkają w tej samej bibliotece. Trzy rodzaje kontroli je łapią. Walidacja schematu wygenerowanych części pivotTableN.xml i pivotCacheDefinitionN.xml łapie wymyślone tokeny, puste elementy items i nazwane identyfikatory formatów. Pliki zapisane przez Excel, przepuszczone przez twój czytnik, ćwiczą atrybuty, które Excel pomija przy ich domyślnych wartościach. Asercje przypinające dokładny token w zapisanym XML, jak axis="axisRow", łapią pisarza dryfującego ku pisowni, którą rozumie tylko twój czytnik; asercja na sparsowanej osi nie
Pivotty budowane przez API, włącznie z polami wyliczanymi, itemami wyliczanymi i układami percent-of-total pokazanymi w budowaniu i odświeżaniu tabel pivot XLSX z polami wyliczanymi, wychodzą z tymi regułami zastosowanymi i bez dodatkowego kodu po twojej stronie. Robota, która zostaje tobie, to wybranie, które pola dostają subtotale i którą funkcję liczenia masz na myśli
Komponent arkuszy HotXLS dla Delphi buduje, czyta i zapisuje tabele pivot XLS i XLSX z kodu Delphi i C++Builder, bez instalacji Excela ani automatyzacji COM na maszynie, na której biegnie