Excel pokazuje „We found a problem with some content” na pliku XLSX, który LibreOffice i każdy własny czytnik otwierają bez skargi, bo Excel egzekwuje dwie rzeczy, które te czytniki ignorują: atrybuty wymagane przez schemat i reguły jednoznaczności z Open Packaging Conventions. Trzy z tych reguł łatwo złamać w każdym autorze, który skleja części generowane z zachowanymi: <phoneticPr> potrzebuje swojego fontId, każda nazwa części dostaje dokładnie jeden Override w [Content_Types].xml, a dwie relacje główne nie mogą nigdy dzielić identyfikatora takiego jak rId4. Ten artykuł przechodzi przez każdą z nich i przez to, jak HotXLS, natywny komponent arkusza Excel dla Delphi i C++Buildera, zapisuje pakiet, żeby ich dotrzymać
Dlaczego Excel odrzuca pakiet, który każdy inny czytnik akceptuje?
Bo monit o naprawę to walidator schematu i pakietu, a nie błąd parsera. Skoroszyt może zrobić round-trip przez twoją własną bibliotekę, przez LibreOffice i przez walidatory XML i być strukturalnie zdrowy w sensie OPC z artykułu o rozwiązywaniu relacji OPC w XLSX: każda część osiągalna, każdy cel rozwiązywalny. Otwórz go przez Workbooks.Open w izolowanej instancji COM z wyłączonym DisplayAlerts, a wywołanie i tak może paść. Interaktywnie ten sam plik daje znajome okno z propozycją naprawy, a dziennik naprawy, gdy Excel w ogóle raczy go zapisać, wymienia część, ale nie regułę. Za tym jednym monitem może się kryć kilka niezależnych naruszeń, a Excel nie zgłasza ich po kolei; odrzuca skoroszyt i zostawia ci ich szukanie i analizę. Dalej jest każda reguła, naturalny sposób, by ją złamać, i to, jak HotXLS zamiast tego zapisuje pakiet, bo każda z nich to reguła, o którą może się potknąć każdy piszący XLSX w Delphi
Reguła 1: phoneticPr wymaga fontId, nawet gdy jest zerem
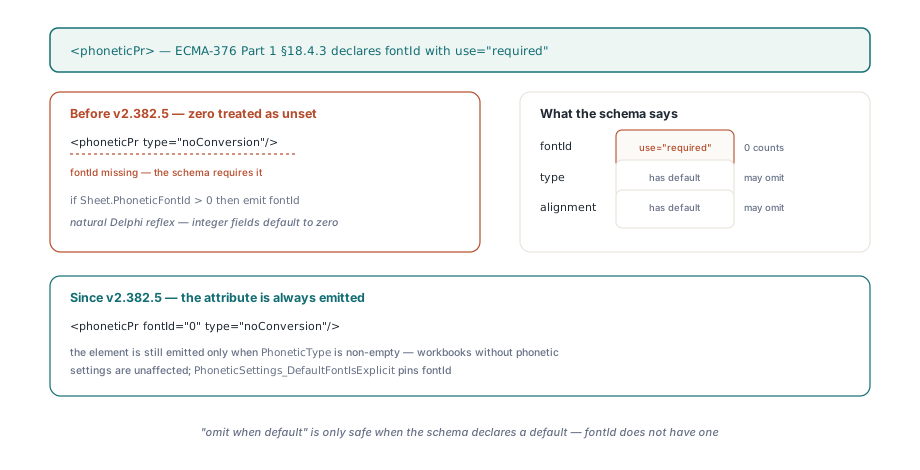
Element <phoneticPr> niesie atrybut fontId zadeklarowany jako use="required" w ECMA-376 Part 1 §18.4.3, a wartość 0 to legalny indeks czcionki, nie brak wartości. Autor, który traktuje zero jako „nieustawione” i emituje atrybut tylko gdy Sheet.PhoneticFontId > 0, idzie naturalnym odruchem Delphi — pola całkowite domyślnie mają zero — ale produkuje <phoneticPr type="noConversion"/> dla każdego skoroszytu, którego czcionka fonetyczna jest przypadkiem pierwszą czcionką w styles.xml, co łatwo trafić, bo indeks 0 to po prostu pierwsza czcionka. Excel odrzuca potem przy ponownym wczytaniu wartość, którą sam zapisał
// Odruch naturalny: zero traktowane jako nieustawione, fontId gubiony
phoneticXml:= '<phoneticPr';
if Sheet.PhoneticFontId > 0 then
  phoneticXml:= phoneticXml+ ' fontId="'+ IntToStr(Sheet.PhoneticFontId)+ '"';

// lxHandleX.pas, zapisujący arkusz — atrybut jest wymagany, zero też
phoneticXml:= '<phoneticPr fontId="'+ IntToStr(Sheet.PhoneticFontId)+ '"';
phoneticXml:= phoneticXml+ ' type="'+ XlsxEscapeAttr(Sheet.PhoneticType)+ '"';
if Sheet.PhoneticAlignment<> '' then
  phoneticXml:= phoneticXml+ ' alignment="'+ XlsxEscapeAttr(Sheet.PhoneticAlignment)+ '"';
HotXLS emituje ten element tylko wtedy, gdy TXLSXWorksheet.PhoneticType jest niepuste, więc skoroszyty, które nigdy nie miały ustawień fonetycznych, nie są tym dotknięte. Ustaw PhoneticFontId na zero na świeżym arkuszu, zapisz, a xl/worksheets/sheet1.xml niesie <phoneticPr fontId="0". Szersza lekcja: „pomiń, gdy domyślne” jest bezpieczne tylko wtedy, gdy schemat deklaruje wartość domyślną; type i alignment mają w tym elemencie wartości domyślne, fontId nie ma
Reguła 2: jeden Override na nazwę części w [Content_Types].xml
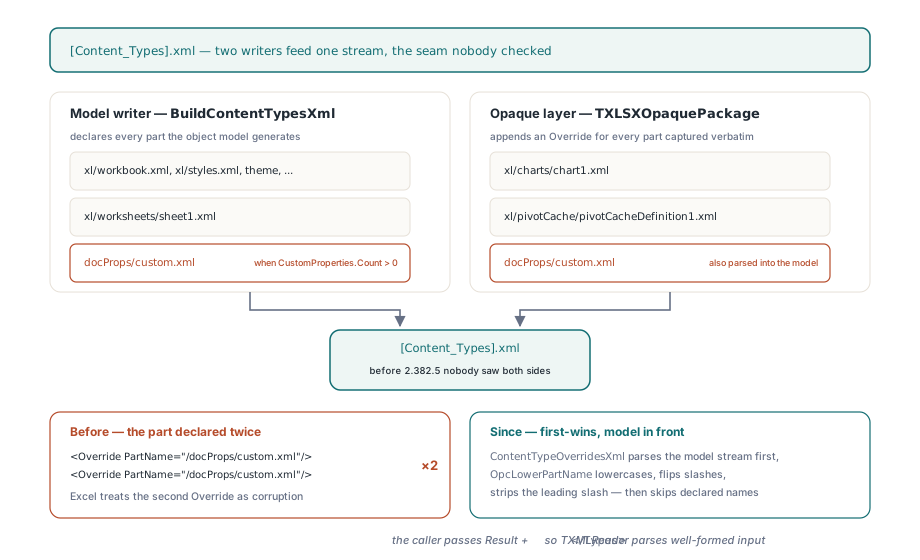
Strumień typów zawartości może zadeklarować każdą nazwę części najwyżej raz, a Excel traktuje drugi Override dla tego samego PartName jako uszkodzenie, nawet gdy oba wpisy niosą ten sam ContentType. W HotXLS dwóch autorów pisze do tego strumienia. BuildContentTypesXml deklaruje każdą część generowaną przez model obiektowy: skoroszyt, style, łańcuchy współdzielone, motyw, arkusze, a gdy TXLSXWorkbook.CustomProperties.Count > 0, także /docProps/custom.xml. Gdy włączone jest PreserveUnsupportedParts, TXLSXOpaquePackage dopisuje potem Override dla każdej części zachowanej dosłownie z pakietu źródłowego, żeby te bajty pozostały zadeklarowane na wyjściu. Kolizją jest część, która żyje po obu stronach. Właściwości niestandardowe dokumentu są parsowane do modelu, ale docProps/custom.xml z pakietu źródłowego jest dodatkowo zachowywany nieprzezroczyście, więc naiwne scalenie deklaruje go dwa razy, a części wykresów i cache tabel przestawnych mogą wylądować w tym samym miejscu, gdy model regeneruje część, którą warstwa nieprzezroczysta też zachowała. Nieprzezroczysty autor bez wglądu w to, co model już zapisał, nie może wiedzieć — dlatego ContentTypeOverridesXml dostaje ten wgląd
<!-- Co daje naiwne scalenie -->
<Override PartName="/docProps/custom.xml"
    ContentType="application/vnd.openxmlformats-officedocument.custom-properties+xml"/>
...
<Override PartName="/docProps/custom.xml"
    ContentType="application/vnd.openxmlformats-officedocument.custom-properties+xml"/>
HotXLS podaje wygenerowany XML do ContentTypeOverridesXml i pozwala nieprzezroczystemu autorowi sparsować go, zanim cokolwiek wyemituje. Poprawność trzymają dwa szczegóły. OpcLowerPartName zamienia na małe litery, odwraca ukośniki wsteczne na zwykłe i usuwa wiodące ukośniki przed porównaniem, bo nazwy części OPC porównuje się bez rozróżniania wielkości liter, a model zapisuje je z wiodącym ukośnikiem, podczas gdy warstwa nieprzezroczysta trzyma nazwy elementów ZIP bez niego. A wołający w BuildContentTypesXml przekazuje Result + '</Types>', domykając częściowo zbudowany dokument, żeby TXMLReader dostał poprawny składniowo tekst, a nie ucięty strumień. Reguła, która z tego wynika, to pierwszeństwo pierwszego zapisu z modelem na przedzie: cokolwiek deklaruje model obiektowy, jest rozstrzygające, a nieprzezroczyste odtworzenie tylko wypełnia luki
// lxOpcPackage.pas — TXLSXOpaquePackage.ContentTypeOverridesXml
function TXLSXOpaquePackage.ContentTypeOverridesXml(const ExistingXml: WideString): WideString;
begin
  ...
  UsedNames.Sorted:= True;
  UsedNames.Duplicates:= dupIgnore;
  if ExistingXml<> '' then
    // Sparsuj strumień wygenerowany przez model i zbierz każdy zadeklarowany PartName.
    while Reader.Read do
      if (Reader.NodeType= xmlntElement)and (Reader.Name= 'Override') then
      begin
        Index:= Reader.AttributeIndex('PartName');
        if Index>= 0 then
          UsedNames.Add(String(OpcLowerPartName(Reader.Attribute[Index].Value)));
      end;
  for i:= 0 to FParts.Count- 1 do
  begin
    Part:= TXLSXOpaquePart(FParts[i]);
    if (Part.ContentType= '')or (LowerCase(ExtractFileExt(String(Part.PartName)))= '.rels')or
      (UsedNames.IndexOf(String(OpcLowerPartName(Part.PartName)))>= 0) then
      Continue;                       // już zadeklarowane albo część rels
    UsedNames.Add(String(OpcLowerPartName(Part.PartName)));
    Result:= Result+ '<Override PartName="/'+ OpcXmlEscapeAttribute(Part.PartName)+
      '" ContentType="'+ OpcXmlEscapeAttribute(Part.ContentType)+ '"/>';
  end;
end;
Reguła 3: identyfikatory relacji są unikalne w obrębie części relacji
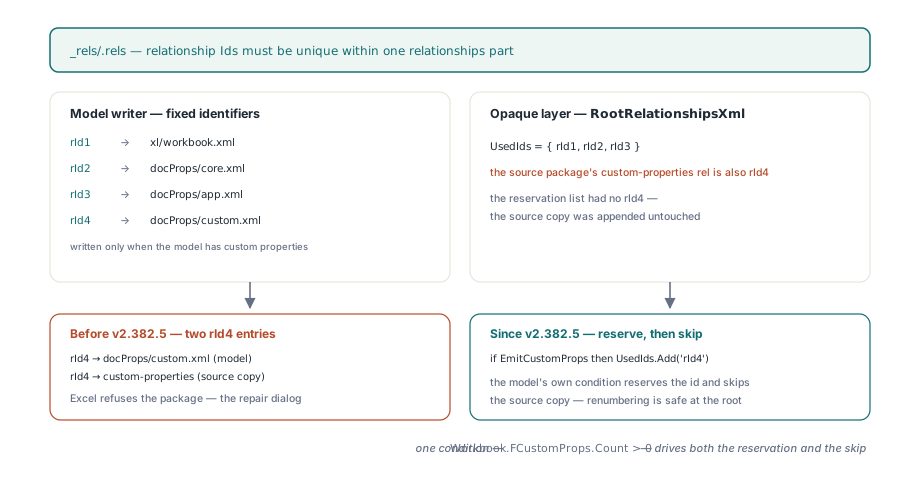
Każdy Relationship w części .rels potrzebuje Id unikalnego w obrębie tej części, a Excel odrzuca pakiet, gdy dwa dzielą jedno. HotXLS zapisuje _rels/.rels na poziomie pakietu ze stałymi identyfikatorami: rId1 dla skoroszytu, rId2 i rId3 dla podstawowych i rozszerzonych właściwości dokumentu oraz rId4 dla właściwości niestandardowych, gdy model jakieś ma. Nieprzezroczysty pakiet dopisuje potem relacje główne zachowane ze źródła, przenumerowując każdy identyfikator obecny już na liście UsedIds. Jeśli ta lista zna tylko rId1 do rId3 i nie wie, że model właśnie zamierza wyemitować własną relację właściwości niestandardowych, pakiet źródłowy, którego relacja właściwości niestandardowych też ma rId4 — a tak Excel zapisuje domyślnie — wychodzi z dwoma wpisami rId4 wskazującymi ten sam cel. RootRelationshipsXml rezerwuje więc rId4 i pomija kopię źródłową zawsze, gdy model emituje właściwości niestandardowe. Wołający, BuildRootRelsXml, przekazuje Workbook.FCustomProps.Count > 0 jako drugi argument, więc rezerwacja i pominięcie są sterowane tym samym warunkiem, który decyduje, czy model w ogóle emituje rId4. Przenumerowanie jest bezpieczne w korzeniu pakietu, bo nic wewnątrz skoroszytu nie odwołuje się do identyfikatorów relacji głównych po nazwie; ten sam trik byłby błędem o poziom niżej, gdzie atrybuty r:id w workbook.xml wiążą się z identyfikatorami w części relacji skoroszytu, dlatego MergeWorkbookRelationshipsXml trzyma osobną mapę identyfikatorów
// lxOpcPackage.pas — TXLSXOpaquePackage.RootRelationshipsXml
UsedIds.CaseSensitive:= False;
UsedIds.Add('rId1');
if EmitCustomProps then UsedIds.Add('rId4');   // rezerwowany przez autora modelu
if EmitDocProps then
begin
  UsedIds.Add('rId2');
  UsedIds.Add('rId3');
end;
for i:= 0 to FRootRelationships.Count- 1 do
begin
  Rel:= TXLSXOpaqueRelationship(FRootRelationships[i]);
  // Model jest właścicielem właściwości niestandardowych; nie odtwarzaj kopii źródłowej.
  if EmitCustomProps and OpcEndsWith(LowerCase(Rel.RelType), '/custom-properties') then
    Continue;
  Id:= Rel.Id;
  if (Id= '')or (UsedIds.IndexOf(String(Id))>= 0) then
    Id:= AllocateRelationshipId(UsedIds);      // najniższy wolny rIdN
  UsedIds.Add(String(Id));
  ...
end;
Co łączy te trzy reguły?
Wszystkie trzy strzegą przed autorem z dwoma źródłami i bez jednego właściciela niezmienników pakietu. Model obiektowy generuje części, które rozumie; warstwa nieprzezroczysta odtwarza części, których nie rozumie, żeby round-trip zachował wykresy, cache tabel przestawnych, własny XML i wszystko inne opisane w notatkach o bezstratnym round-tripie motywu, bloków extLst i calcChain. Każda ze stron może być osobno spójna. Ograniczenia, które OPC nakłada na cały pakiet — unikalne nazwy części w Override i unikalne identyfikatory relacji na część — istnieją wyłącznie na styku, gdzie oba wyniki się skleja, więc ktoś musi ten styk posiadać. Reguła fontId to ten sam kształt o poziom niżej: autor może wiedzieć, co chce pominąć, i nigdy nie zajrzeć do schematu, który mówi, że nie wolno. HotXLS rozstrzyga to sztywnym pierwszeństwem, a nie heurystyką scalania. Model zapisuje pierwszy, a warstwa nieprzezroczysta widzi, co zostało zapisane, i ustępuje przy każdej kolizji. Niezmienniki są też tanie do sprawdzenia z zewnątrz: przeczytaj [Content_Types].xml i każdy element .rels w zapisanym pakiecie i przewróć przypadek przy każdym powtórzonym PartName, Extension albo Id. To sprawdzenie nie potrzebuje Excela i pokrywa dwie reguły jednoznaczności; reguła fontId wciąż potrzebuje walidatora schematu
Obszary wydruku, które są formułami, a nie zakresami
Obszar wydruku to druga rzecz, którą Excel porównuje na zapisanej kopii: szablon, którego _xlnm.Print_Area Excel raportuje jako $A$1:$J$29, musi raportować identycznie po round-tripie. Za tym stoją dwie pułapki. Przy imporcie zdejmowanie prefiksu, które ucina wszystko do pierwszego niecytowanego !, zamienia dynamiczny obszar wydruku taki jak OFFSET('Print Data'!$A$1,0,0,2,2) w $A$1,0,0,2,2), a kwalifikowaną sumę taką jak 'Print Data'!$A$1:$B$2,'Print Data'!$D$1:$E$2 pozbawia prefiksu tylko w pierwszym segmencie. Przy eksporcie doklejenie nazwy arkusza raz do całego zapisanego PrintArea daje zwykłej sumie $A$1:$B$2,$D$1:$E$2 kwalifikowany pierwszy segment i goły drugi, czego Excel nie akceptuje jako definicji _xlnm.Print_Area zgodnie z ECMA-376 Part 1 §18.2.5
// Import: zdejmij prefiks tylko wtedy, gdy to, co zostaje, jest zwykłym sqref
function XlsxPrintAreaFromDefinition(const Formula: WideString): WideString;
begin
  Result:= Formula;
  if not XlsxReadFormulaSheetPrefixAt(Formula, 1, Prefix, SheetPart, Start) then
    Exit;
  Area:= Copy(Formula, Start, Length(Formula));
  if XlsxParseSqrefPart(Area, R1, C1, R2, C2) then
    Result:= Area;                    // 'Sheet'!$A$1:$J$29 -> $A$1:$J$29
end;                                  // OFFSET(...) jest zwracany bez zmian

// Eksport: kwalifikuj każdy segment rozdzielony przecinkami albo żaden
function XlsxPrintAreaDefinition(const SheetName, Area: WideString): WideString;
begin
  Result:= Area;
  ... split Area on ',' with StrictDelimiter ...
  for I:= 0 to Parts.Count- 1 do
    if not XlsxParseSqrefPart(WideString(Trim(Parts[I])), R1, C1, R2, C2) then
      Exit;                           // formuła: emituj dosłownie
  Result:= '';
  for I:= 0 to Parts.Count- 1 do
  begin
    if I> 0 then Result:= Result+ ',';
    Result:= Result+ XlsxQuoteSheetName(SheetName)+ '!'+ WideString(Trim(Parts[I]));
  end;
end;
Reguła parowania jest po obu stronach ta sama: obszar wydruku jest gołym zakresem tylko wtedy, gdy każdy segment daje się sparsować jako zakres, w przeciwnym razie jest formułą i podróżuje dosłownie. Z tą regułą nazwana baza, baza kwalifikowana arkuszem i suma wszystkie przeżywają powtarzane cykle zapisu i ponownego otwarcia. Jak obszary wydruku wchodzą w interakcje z ustawieniami strony i resztą modelu drukowania, pokrywa artykuł o ochronie arkusza, ustawieniach strony i drukowaniu
Jak ustalić, której regule Excel się sprzeciwia?
Zacznij od założenia, że twój własny walidator się myli, bo przecież przepuścił plik. Walidator z Open XML SDK wskaże naruszenie schematu, jak brakujący fontId, z częścią i XPath, a warstwa pakietu pod spodem w ogóle odmawia otwarcia pakietu ze zdublowanymi wpisami typów zawartości, więc puść go przed czymkolwiek innym. Gdy milczy, a Excel i tak naprawia, dziel pakiet na połowy: rozpakuj, usuń część, jej relację i jej Override, spakuj i otwórz ponownie, dzieląc zbiór kandydatów na pół, aż monit zniknie. Trzy naruszenia powyżej wychodzą w tej kolejności, a żadne nie byłoby widoczne w naprawionym pliku, który Excel proponuje zapisać, bo naprawa po cichu wyrzuca albo przenumerowuje winne wpisy. Dwa wybory projektowe w autorze HotXLS są warte znajomości. Deduplikacja to pierwszeństwo pierwszego zapisu z modelem na przedzie, więc jeśli pakiet źródłowy zadeklarował inny typ zawartości dla części, którą model też generuje, deklaracja modelu wygrywa, a źródłowa jest wyrzucana — to poprawne dla części, które HotXLS regeneruje, i nie jest ogólnym scaleniem. A dodatkowy przebieg TXMLReader po wygenerowanym strumieniu typów zawartości biegnie przy każdym zapisie z włączonym PreserveUnsupportedParts — mały koszt przy strumieniu, który rzadko przekracza kilka kilobajtów. Z tymi regułami szablon kredytu z 4805 formułami zapisany przez buildy Win32 i Win64 otwiera się w Excelu bez monitu, przelicza z zerem rozbieżności i raportuje ten sam obszar wydruku co oryginał
Jeśli sam piszesz XLSX z Delphi, lista kontrolna jest krótka: emituj każdy atrybut oznaczony w schemacie jako wymagany, niezależnie od jego wartości, deklaruj każdą nazwę części raz i trzymaj jedną listę użytych identyfikatorów na część relacji u wszystkich autorów, którzy jej dotykają. Jeśli wolisz, żeby ta lista już istniała i była testowana przeciw Excelowi, a nie tylko przeciw twojemu własnemu czytnikowi, autor pakietu opisany tutaj jest w komponencie HotXLS Delphi spreadsheet component, razem z round-tripem części nieprzezroczystych, przez który ten styk w ogóle warto było chronić